
Saltar al contenido
Empezar gratis
Volver al blog

Cómo utilizar la API de Amazon Scraper: guía de inicio rápido

Robert SfichiÚltima actualización el 25 min read
Cómo utilizar la API de Amazon Scraper: guía de inicio rápido
En resumen: Para usar la Amazon Scraper API, envía una solicitud GET a https://ecom.webscrapingapi.com/v1 con api_key, engine=amazon, un tipo de solicitud y la entrada de ese tipo, como un ASIN en product_id o una palabra clave en q. Usa product para un ASIN, search para una palabra clave, bestsellers o todays-deals para un ID de categoría, y seller_products o seller_feedback para un ID de vendedor. Esta guía cubre los nueve tipos de solicitud, 20 marketplaces, los errores y los planes.

Necesitas datos de productos, búsquedas, clasificaciones, reseñas o vendedores de Amazon que tu código pueda almacenar y comparar entre distintos mercados, sin tener que mantener un rastreador para cada diseño de página. Esta guía utiliza la API de Amazon de WebScrapingAPI. Al finalizar, enviarás una primera solicitud con tu clave en una variable de entorno, elegirás el tipo de solicitud adecuado, seleccionarás el dominio de Amazon y la ubicación de entrega correctos, leerás cada formato de respuesta con un único analizador, volverás a intentar la solicitud según el contrato de errores documentado y elegirás un plan.

Inicio rápido

  • Punto de acceso: https://ecom.webscrapingapi.com/v1 (GET)
  • Requisitos: api_key, engine=amazon, type, además de la entrada propia del tipo (q, product_id, category_id, o seller_id)
  • Tipos de solicitud: nueve, desde un único producto hasta opiniones de vendedores
  • Prueba gratuita: 100 solicitudes a Amazon

¿Qué es la API de Amazon Scraper y qué devuelve?

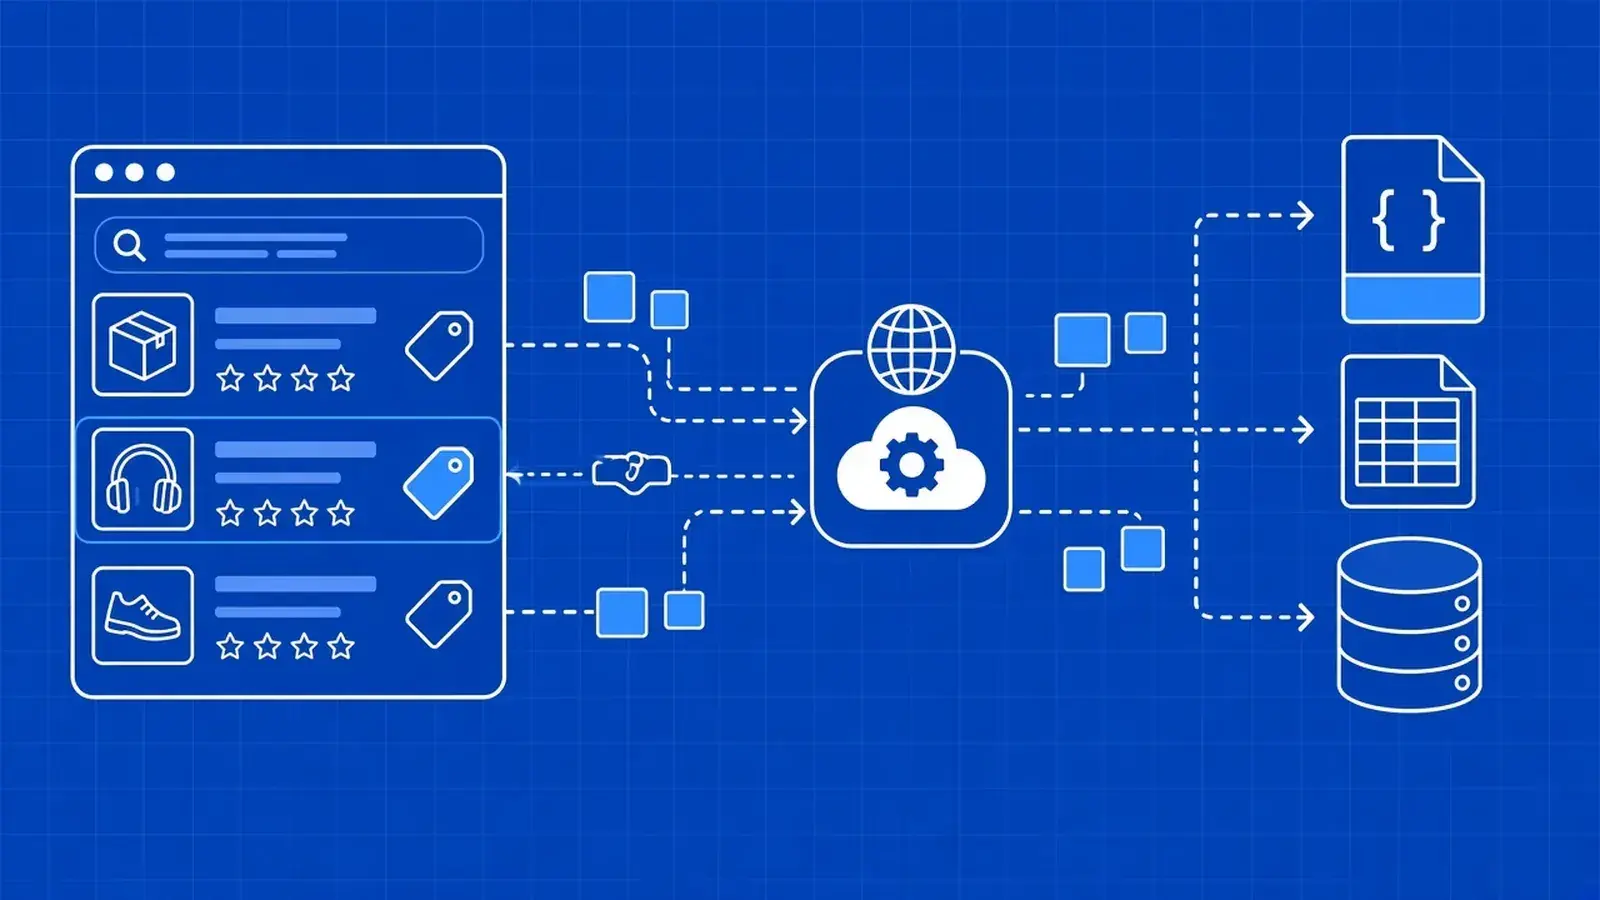
La API de Amazon de WebScrapingAPI es un punto final GET que acepta un tipo de solicitud, como «producto», «búsqueda» o «más vendidos», además de un ASIN, una palabra clave, una categoría o un ID de vendedor, y devuelve la página de Amazon correspondiente en formato JSON estructurado. WebScrapingAPI se encarga del acceso, la extracción y el mantenimiento del analizador sintáctico. Tu código selecciona las páginas, los mercados y los campos, y almacena los resultados.

Tú nombras la página a través de type y sus datos de entrada, y cada respuesta se devuelve con el mismo formato de primer nivel: lo que has solicitado, lo que Amazon ha mostrado y los registros de esa página. No tienes que escribir selectores ni reescribirlos cuando Amazon cambie su marcado.

A continuación se detalla quién se encarga de qué:

  • WebScrapingAPI se encarga de: el acceso a la fuente, la extracción de datos, las actualizaciones del analizador y el control de calidad.
  • Tu equipo se encarga de: qué páginas y mercados recopilar, qué campos conservar, los horarios de actualización y la entrega, así como el análisis que se realiza a partir de ello.

La API abarca resultados de búsqueda y categorías, páginas de productos y variaciones, y listados de ofertas de los vendedores. Los equipos la utilizan para obtener información sobre la Buy Box y las ofertas, la cuota de búsqueda y de categoría, y el análisis de variaciones y señales de reseñas. Amazon es una de las fuentes del catálogo más amplio de la API de datos.

Cada respuesta es una observación de una página, en un mercado, en un momento determinado. Un precio, una posición o un recuento de reseñas solo tienen sentido en el contexto de los parámetros y el momento en que se generaron.

¿Cómo se obtiene una clave de API y se envía la primera solicitud a Amazon?

Crea una cuenta en WebScrapingAPI, suscríbete a la API de Amazon en el panel de control y guarda tu clave en una variable de entorno. A continuación, envía una solicitud GET a https://ecom.webscrapingapi.com/v1 con api_key, engine=amazon, type=search y q establecido en tu palabra clave. Deja que tu cliente HTTP se encargue de codificar los parámetros y guarda la clave en tu servidor.

  1. Crea una cuenta con correo electrónico y contraseña, GitHub o Google.
  2. Suscríbete a la API de Amazon en el panel de control. La versión de prueba incluye 100 solicitudes a Amazon por 0 $.
  3. Guarda la clave en una variable de entorno, como WSA_API_KEY, o en un gestor de secretos.
  4. Envía la solicitud desde un terminal, Python o Node.js.

Guarda la clave en secretos del lado del servidor, nunca en el código front-end, en un repositorio público, en una línea de registro ni en una captura de pantalla. Está vinculada a tu cuenta y al límite de tu plan, por lo que cualquiera que la tenga accederá a tus solicitudes.

# Paste your key from the dashboard, or load it from your secrets manager. Never commit it.
export WSA_API_KEY="..."

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=search" \
  --data-urlencode "q=memory card"

El resto de esta guía se basa en el cliente de Python que se muestra a continuación. Lee la clave del entorno, vuelve a intentar la solicitud según las reglas de error que se explican más adelante y devuelve el JSON analizado junto con el encabezado de crédito de la llamada. Instala Requests con pip install requests.

# amazon_client.py
import os
import random
import time
from urllib.parse import urlencode

import requests

SCRAPER_URL = "https://ecom.webscrapingapi.com/v1"
RETRYABLE = {429, 500, 502, 503}


def redacted_url(params):
    """The request URL with the key hidden. Log this, never the real URL."""
    return f"{SCRAPER_URL}?{urlencode({'engine': 'amazon', 'api_key': '***', **params}, safe='*')}"


def amazon_get(params, retries=3, timeout=130):
    query = {"engine": "amazon", "api_key": os.environ["WSA_API_KEY"], **params}
    for attempt in range(retries + 1):
        resp = requests.get(SCRAPER_URL, params=query, timeout=timeout)
        if resp.status_code == 200:
            return resp.json(), resp.headers.get("Searchdata-Call-Credit-Usage")
        retry_422 = resp.status_code == 422 and attempt == 0  # retry a website error once
        if (resp.status_code not in RETRYABLE and not retry_422) or attempt == retries:
            raise RuntimeError(f"{resp.status_code} on {redacted_url(params)}: {resp.text[:200]}")
        wait = resp.headers.get("Retry-After", "")
        delay = int(wait) if wait.isdigit() else 2 ** attempt
        time.sleep(delay + random.random())  # exponential backoff with jitter
# first_request.py
from amazon_client import amazon_get

data, credits = amazon_get({"type": "search", "q": "memory card"})
results = data.get("search_results", {}).get("product_results", [])
print(len(results), "products; credits for this call:", credits)

La misma solicitud en Node.js 18 o posterior no necesita dependencias:

// amazon_request.mjs — run with: node amazon_request.mjs
const params = new URLSearchParams({
  engine: "amazon",
  api_key: process.env.WSA_API_KEY,
  type: "search",
  q: "memory card",
});

const res = await fetch(`https://ecom.webscrapingapi.com/v1?${params}`, {
  signal: AbortSignal.timeout(130_000),
});
if (!res.ok) throw new Error(`${res.status}: ${await res.text()}`);

const data = await res.json();
console.log("credits for this call:", res.headers.get("searchdata-call-credit-usage"));
console.log(data.search_results?.product_results?.length, "products");

Una palabra clave seguida de un espacio, &, o + debe seguir las reglas de codificación en porcentaje. Un & inicia silenciosamente un nuevo parámetro, que la API rechaza con el mensaje «Parámetro '<nombre>' no permitido». Las opciones --data-urlencode y URLSearchParams de curl, así como el argumento params de Requests, se encargan de la codificación por ti. Cada ejemplo establece además un tiempo de espera de 130 segundos, para que una página lenta no bloquee a un trabajador.

Respuesta de ejemplo (copiada de la documentación de la API, recortada):

{
  "search_parameters": {
    "amazon_url": "https://www.amazon.com/s?k=memory+card",
    "engine": "amazon",
    "amazon_domain": "amazon.com",
    "type": "search",
    "q": "memory card"
  },
  "search_information": {
    "organic_results_state": "Results for exact spelling",
    "total_results": "5,000",
    "query_displayed": "memory card"
  },
  "search_results": {
    "product_results": [
      {
        "position": 1,
        "product_id": "B08TJRVWV1",
        "title": "Amazon Basics microSDXC Memory Card with Full Size Adapter",
        "link": "https://www.amazon.com/dp/B08TJRVWV1",
        "price": "$12.42",
        "rating": { "rating": "4.7 out of 5 stars", "total_ratings": 33500 }
      }
    ]
  }
}

Documentación: Acceder a la API

¿Qué tipos de solicitudes de Amazon puedes utilizar?

Establece el tipo en uno de estos nueve valores: «product» para un ASIN; «search» para una palabra clave; «category», «bestsellers», «new-releases» o «todays-deals» para un ID de categoría; y «seller_products», «seller_profile» o «seller_feedback» para un ID de vendedor. «seller_feedback» es la solicitud de reseñas. Cada tipo requiere sus propios datos de entrada y devuelve las filas en su lugar correspondiente.

Objetivo

type

Datos de entrada obligatorios

Datos de entrada opcionales del tipo

Las filas se encuentran en

Sección

Un producto por ASIN (incluida la valoración y el número de valoraciones)

product

product_id

—

product_results (objeto)

Producto por ASIN

Resultados por palabra clave

search

q

page, sort_by, filter_by

search_results.product_results

Resultados de la búsqueda

Clasificación de los más vendidos

bestsellers

category_id

parent_alias

category_results.product_results

Los más vendidos

Novedades

new-releases

category_id

parent_alias

category_results.product_results

Novedades

Explorar una categoría

category

category_id

page, sort_by

category_results.product_results

Categoría

Ofertas de hoy

todays-deals

category_id

—

category_results.product_results (añade price_raw)

Ofertas de hoy

Catálogo de un vendedor

seller_products

seller_id

page

search_results.product_results

Productos del vendedor

Perfil del vendedor

seller_profile

seller_id

—

seller_profile (sin lista de productos)

Perfil del vendedor

Opiniones (opiniones de los compradores sobre un vendedor)

seller_feedback

seller_id

page (5 por página)

seller_feedback (sin lista de productos)

Opiniones

Las ubicaciones de respuesta siguen los ejemplos de la documentación. Léelas con cuidado. El analizador sintáctico que aparece a continuación muestra cómo hacerlo.

Hay tres detalles que suelen confundir a los usuarios. El valor de las ofertas es todays-deals, con el guion y la «s». La API acepta seller como alias de seller_products, pero escribe el valor completo para que tus registros sigan siendo legibles. Además, parent_alias solo se aplica a los más vendidos y a las novedades, donde apunta a una subcategoría.

Para las reseñas, utiliza seller_feedback para recopilar filas de reseñas y product para la valoración y el recuento de valoraciones de un ASIN.

Documentación: Tipos de búsqueda en Amazon

¿Cómo se extrae información de un producto de Amazon por ASIN?

Envía type=product con product_id establecido en el ASIN, el identificador de diez caracteres que aparece después de /dp/ en cualquier URL de producto de Amazon. El objeto product_results de la respuesta contiene el título, el precio, la valoración, el número total de valoraciones, las categorías, las imágenes y los atributos, además de los aspectos destacados del artículo cuando Amazon los muestra. Añade «amazon_domain» para leer el mismo ASIN en otro mercado de Amazon.

En https://www.amazon.com/dp/B098RNZGNW, el ASIN es B098RNZGNW. El mismo ASIN suele existir en varios mercados, por lo que un único identificador, junto con amazon_domain te permite comparar un producto entre distintos países.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=product" \
  --data-urlencode "product_id=B098RNZGNW" \
  --data-urlencode "amazon_domain=amazon.co.uk"
import re
from amazon_client import amazon_get

url = "https://www.amazon.com/dp/B098RNZGNW"
asin = re.search(r"/dp/([A-Z0-9]{10})", url).group(1)

data, _ = amazon_get({"type": "product", "product_id": asin})
item = data.get("product_results", {})
rating = item.get("rating", {})
print(item.get("title"), item.get("price"), rating.get("rating"), rating.get("total_ratings"))

Ejemplo de respuesta (copiado de la documentación de la API, abreviado):

{
  "product_results": {
    "product_id": "B098RNZGNW",
    "title": "Example Amazon Product",
    "item_highlights": "Foldable card table for board games, dining, and extra seating",
    "price": "$59.99",
    "rating": { "rating": "4.6 out of 5 stars", "total_ratings": 12438 },
    "categories": ["Electronics", "Headphones"],
    "images": ["https://m.media-amazon.com/images/I/example-1.jpg"],
    "attributes": { "Brand": "Example", "Color": "Black" }
  }
}

price es una cadena de visualización como "$59.99", así que déjala tal cual con su dominio y analiza el número en un paso aparte. rating.rating es texto, mientras que rating.total_ratings es un número entero que puedes comparar a lo largo del tiempo. Es la señal de valoración a nivel de producto que se combina con las valoraciones de los compradores sobre el vendedor. item_highlights se omite cuando Amazon no muestra ninguna. Establece wait_for_offers=true cuando los módulos de oferta sean relevantes, y wait_for_video=true para los módulos de vídeo.

La cobertura de los campos varía según la página. Los detalles de la Buy Box, el vendedor, las variaciones y la disponibilidad dependen de lo que muestre cada página de producto, así que comprueba una muestra representativa de tus propios ASIN antes de diseñar un esquema. Esa muestra es también donde comienza el seguimiento del precio y de la Buy Box.

Documentación: Producto de Amazon

¿Cómo se extraen los resultados de búsqueda de Amazon y se paginan?

Envía type=search con q establecido en la palabra clave. Los productos aparecen en search_results.product_results, cada uno con una posición, ASIN, título, enlace, precio y valoración, y related_searches enumera las sugerencias de Amazon. Solicita «page=2», «3» y sucesivos para obtener más resultados, y utiliza «sort_by» o «filter_by=prime» cuando necesites la clasificación propia de Amazon o el filtro Prime.

Los resultados de búsqueda de Amazon (la SERP de Amazon) muestran quién aparece para una consulta y en qué orden. position es la posición en la lista devuelta para esa palabra clave, dominio, página y momento. Guárdala junto con q, amazon_domain, page, sort_by, y la hora de captura; de lo contrario, las comparaciones de posicionamiento dejarán de tener sentido.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=search" \
  --data-urlencode "q=memory card" \
  --data-urlencode "page=2" \
  --data-urlencode "filter_by=prime"

Para paginar, mantén q, el dominio y los ajustes de ordenación iguales, y aumenta page. Cada página es una solicitud independiente, así que limita el número de páginas por palabra clave:

from datetime import datetime, timezone
from amazon_client import amazon_get

rows = []
for page in range(1, 4):  # page cap: three pages per keyword
    params = {"type": "search", "q": "memory card", "page": page, "amazon_domain": "amazon.com"}
    data, _ = amazon_get(params)
    found = data.get("search_results", {}).get("product_results", [])
    if not found:
        break
    captured_at = datetime.now(timezone.utc).isoformat()
    rows += [{**params, "captured_at": captured_at, "position": r.get("position"),
              "product_id": r.get("product_id"), "price_text": r.get("price")} for r in found]
print(len(rows), "rows")

Respuesta de ejemplo (copiada de la documentación de la API, recortada):

{
  "related_searches": [
    { "query": "micro sd card", "link": "https://www.amazon.com/s?k=micro+sd+card" }
  ]
}

sort_by acepta featured, price-asc-rank, price-desc-rank, review-rank, date-desc-rank, y relevancerank. filter_by acepta prime y climate-friendly. Mantén ambos valores fijos en todas las ejecuciones si realizas un seguimiento de las posiciones. Las páginas de búsqueda también pueden incluir top_sponsored, video_sponsored, pagination, y amazon_pagination. Léalas cuando aparezcan, pero nunca las dé por sentadas.

Si realizas un seguimiento de la posición en los resultados de búsqueda a lo largo del tiempo, compara estas filas con los resultados de Google para la misma palabra clave.

Documentación: Búsqueda en Amazon

¿Cómo se extraen las listas de superventas de Amazon?

Envía type=bestsellers con un category_id, que puede ser un alias como «electrónica» o un ID numérico de nodo, y añade parent_alias para acceder a una subcategoría. El ayudante de categorías sin clave busca ambos valores a partir de una palabra clave. Los productos clasificados aparecen en «category_results.product_results», cada uno con la posición mostrada por Amazon, el ASIN, el título, el enlace y el precio.

Tres pasos para obtener una clasificación:

  1. Busca la categoría con el ayudante de categorías, que no necesita clave API.
  2. Pasa su category_id, además de parent_alias para una subcategoría.
  3. Lee category_results.product_results.
curl "https://amazon-helpers.webscrapingapi.com/categories?q=electronics&limit=3"

Respuesta del ayudante (recortada):

[
  { "title": "Amazon Launchpad Top Electronics", "href": "/gp/new-releases/boost/23602499011", "parent_alias": "boost", "category_id": "23602499011" },
  { "title": "Electronics", "href": "/gp/new-releases/boost/21179674011", "parent_alias": "boost", "category_id": "21179674011" },
  { "title": "Electronics", "href": "/gp/new-releases/automotive/3248690011", "parent_alias": "automotive", "category_id": "3248690011" }
]

Lee los campos del helper por clave, ya que los nombres pueden diferir de los de la tabla de la documentación. Los alias de primer nivel, como electronics funcionan sin necesidad de búsqueda:

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=bestsellers" \
  --data-urlencode "category_id=electronics"

Respuesta de ejemplo (copiada de la documentación de la API, recortada):

{
  "category_results": {
    "product_results": [
      { "position": 1, "product_id": "B08C1W5N87", "title": "Fire TV Stick with Alexa Voice Remote",
        "link": "/fire-tv-stick-with-3rd-gen-alexa-voice-remote/dp/B08C1W5N87", "price": "$19.99",
        "rating": { "rating": "4.7 out of 5 stars", "total_ratings": 141438 } }
    ]
  }
}

position es la clasificación que muestra Amazon para esa categoría en ese momento, así que guarda la hora de la captura y compara las ejecuciones realizadas con la misma periodicidad. Ten en cuenta el prefijo relativo link: antepone el dominio a esas rutas antes de almacenarlas, tal y como absolute_link() es lo que hace la sección del analizador.

Documentación: Éxitos de ventas de Amazon

¿Cómo se obtienen los nuevos lanzamientos de Amazon para una categoría?

Envía type=new-releases con un category_id, como «fashion», y añade parent_alias para una subcategoría, exactamente igual que con los más vendidos. La respuesta enumera las novedades más destacadas de Amazon para esa categoría en «category_results.product_results», con la posición, el ASIN, el título, el enlace y el precio. Ejecútala de forma programada para ver qué lanzamientos entran y salen de la lista.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=new-releases" \
  --data-urlencode "category_id=fashion"

Respuesta de ejemplo (copiada de la documentación de la API; el ASIN es un marcador de posición de la documentación):

{
  "category_results": {
    "product_results": [
      { "position": 1, "product_id": "B09EXAMPLE", "title": "New release product",
        "link": "https://www.amazon.com/dp/B09EXAMPLE", "price": "$29.99" }
    ]
  }
}

Busca los ID de las subcategorías y sus parent_alias con el ayudante de categorías de la sección de superventas. Utiliza esta solicitud para el seguimiento de lanzamientos: una categoría y un mercado por ejecución, con la misma programación cada vez.

Documentación: Novedades de Amazon

¿Cómo se extraen los datos de una lista de categorías de Amazon?

Envía type=category con un category_id, ya sea un alias como amazon-devices o un ID de nodo numérico. Añade page para obtener resultados más detallados y sort_by para cambiar el orden. Los productos aparecen en category_results.product_results con la posición, el ASIN, el título, el enlace, el precio y la valoración, por lo que puedes realizar un seguimiento de todo un nodo de navegación en lugar de una sola palabra clave.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=category" \
  --data-urlencode "category_id=amazon-devices" \
  --data-urlencode "page=2"

Respuesta de ejemplo (copiada de la documentación de la API, recortada):

{
  "category_results": {
    "product_results": [
      { "position": 1, "product_id": "B08C1W5N87", "title": "Fire TV Stick with Alexa Voice Remote",
        "link": "/fire-tv-stick-with-3rd-gen-alexa-voice-remote/dp/B08C1W5N87", "price": "$19.99",
        "rating": { "rating": "4.7 out of 5 stars", "total_ratings": 141438 } }
    ]
  }
}

Una solicitud de categoría devuelve el listado de navegación según el orden elegido por Amazon, mientras que «bestsellers» devuelve la lista de los más vendidos clasificada. page y sort_by se aplican aquí, pero parent_alias no. Los enlaces pueden ser relativos, como en «bestsellers».

Documentación: Categoría de Amazon

¿Cómo se extraen las ofertas de hoy de Amazon?

Envía type=todays-deals, en lugar de deals, con un category_id como, por ejemplo, 15684181. Los productos en oferta aparecen en category_results.product_results, y cada fila contiene price, el precio actual de la oferta, y price_raw, el precio antes de la oferta. Guarda ambos junto con la hora de captura, ya que las ofertas cambian a lo largo del día y una solicitud posterior puede devolver una lista diferente.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=todays-deals" \
  --data-urlencode "category_id=15684181"

Respuesta de ejemplo (copiada de la documentación de la API, recortada):

{
  "category_results": {
    "product_results": [
      { "position": 1, "product_id": "B081T7N948", "title": "Cleaning Gel for Car",
        "link": "/Cleaning-Universal-Detailing-Automotive-Interior/dp/B081T7N948",
        "price": "$5.94", "currency": "$", "price_raw": "$9.99" }
    ]
  }
}

Calcula el descuento solo sobre los números analizados, después de eliminar el símbolo de la moneda de ese dominio, y conserva también las cadenas sin procesar:

deal, before = float(row["price"].lstrip("$")), float(row["price_raw"].lstrip("$"))
discount_pct = round((before - deal) / before * 100, 1)  # 40.5 for the sample row

Los enlaces de las ofertas pueden ser relativos, así que procesa los enlaces mediante absolute_link().

Documentación: Ofertas de Amazon

¿Cómo se enumeran los productos que ofrece un vendedor en Amazon?

Envía type=seller_products con el ID del vendedor en seller_id. La respuesta muestra los productos de la tienda de ese vendedor en search_results.product_results, con la posición, el ASIN, el título, el enlace y el precio, con el mismo formato que en search. Añade «page» para obtener más resultados. El alias más corto «seller» también funciona, pero escribe «seller_products» para que tu código siga siendo legible.

Utiliza el ID del vendedor que aparece en la URL de la tienda del vendedor.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=seller_products" \
  --data-urlencode "seller_id=AAZRLVTNON75Z"

Ejemplo de respuesta (copiado de la documentación de la API, abreviado):

{
  "search_results": {
    "product_results": [
      { "position": 1, "product_id": "B01NGTV4J5", "title": "Cascade Platinum Dishwasher Pods",
        "link": "https://www.amazon.com/dp/B01NGTV4J5", "price": "$38.88", "currency": "$" }
    ]
  }
}

Dado que las filas coinciden con los resultados de búsqueda, aquí se puede utilizar el mismo código de análisis y almacenamiento. Guárdalas por cada ejecución para ver qué ASIN ofrece un vendedor y a qué precios se muestran.

Documentación: Productos de vendedores de Amazon

¿Cómo se obtiene el perfil y la valoración de un vendedor de Amazon?

Envía type=seller_profile junto con el seller_id. El objeto seller_profile devuelve seller_details con el nombre de la tienda, el enlace a la tienda, la valoración por estrellas, el número total de valoraciones y el porcentaje de valoraciones positivas, además de una breve lista de comentarios recientes y un resumen de comentarios con los porcentajes de comentarios positivos, neutros y negativos. Se trata de una solicitud por vendedor, sin lista de productos ni paginación.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=seller_profile" \
  --data-urlencode "seller_id=AAZRLVTNON75Z"

Respuesta de ejemplo (copiada de la documentación de la API, recortada):

{
  "seller_profile": {
    "seller_details": { "name": "Triplenet Pricing INC", "store_link": "https://www.amazon.com/s?me=AAZRLVTNON75Z",
      "rating": 4, "ratings_total": 4078, "ratings_positive_percentage": 74 },
    "feedback": [ { "rating": 5, "body": "Great service", "rater": "By Sarah M. on July 24, 2023." } ],
    "feedback_summary": [ { "positive_percent": 75, "neutral_percent": 1, "negative_percent": 24, "count": 366 } ]
  }
}

Utiliza un perfil para evaluar a los vendedores externos que compiten por la «Buy Box» o por la tienda ratings_total y ratings_positive_percentage por ejecución para observar cómo evoluciona la posición de un vendedor. La feedback lista que se muestra aquí es una breve muestra reciente. Para cada fila de reseñas, navega por la solicitud de comentarios del vendedor que aparece a continuación.

Documentación: Perfil de vendedor de Amazon

¿Cómo se extraen las reseñas de Amazon mediante la solicitud de valoraciones del vendedor?

Envía type=seller_feedback con un seller_id. Se trata de la solicitud de reseñas de la API de Amazon: cada fila es una reseña de un comprador sobre ese vendedor, con el autor de la reseña, la valoración por estrellas, el texto de la reseña, la fecha y si el vendedor ha respondido. Los resultados se muestran de cinco en cinco por página, así que sigue pagination.has_next_page y next_page hasta alcanzar el límite de páginas que hayas establecido.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=seller_feedback" \
  --data-urlencode "seller_id=AAZRLVTNON75Z" \
  --data-urlencode "page=2"

Ejemplo de respuesta (copiado de la documentación de la API, recortado):

{
  "seller_feedback": [
    { "rater": "Sarah M.", "rating": 5, "has_response": false, "body": "Great service",
      "date": { "raw": "July 24, 2023", "utc": "2023-07-24T04:00:00.000Z" }, "position": 1 }
  ],
  "pagination": { "current_page": 1, "has_next_page": true, "next_page": 2 }
}

Cada página es una solicitud independiente, por lo que un historial de reseñas extenso se acumula. Este paginador se detiene cuando no hay página siguiente o cuando llega a max_pages:

# seller_feedback_pages.py
from amazon_client import amazon_get


def all_feedback(seller_id, max_pages=3):
    page, rows = 1, []
    while page and page <= max_pages:
        data, _ = amazon_get({"type": "seller_feedback", "seller_id": seller_id, "page": page})
        rows += data.get("seller_feedback", [])
        pagination = data.get("pagination", {})
        page = pagination.get("next_page") if pagination.get("has_next_page") else None
    return rows


reviews = all_feedback("AAZRLVTNON75Z")
print(len(reviews), "reviews")

Store seller_id y date.utc con cada reseña y elimina los duplicados entre ejecuciones. date.raw sigue el formato de visualización de Amazon. Combínalo con los datos del producto: type=product proporciona la valoración de cada ASIN y el recuento total de valoraciones, de modo que, juntas, las dos solicitudes cubren el volumen de reseñas, las valoraciones por estrellas y el texto de las reseñas de los vendedores.

Documentación: Comentarios de los vendedores de Amazon

¿Cómo se selecciona otro dominio de Amazon, país o código postal?

Establece amazon_domain en uno de los veinte mercados compatibles, como amazon.de o amazon.co.jp. El valor por defecto es amazon.com. Añade delivery_location con un código de país como «de» o «gb» para establecer el país de entrega por defecto, o zip_code para una dirección local de EE. UU. Utiliza hl y gl para el idioma y el país, y registra cada configuración junto con los resultados.

El precio, la disponibilidad y las condiciones de entrega en Amazon dependen del mercado y de la dirección de entrega, por lo que dos ejecuciones con configuraciones diferentes no son comparables. Define una pequeña cuadrícula de mercado (cada ASIN o palabra clave × cada dominio × cada ubicación de entrega) y manténla igual entre ejecuciones.

Región

Dominios

América

amazon.com, amazon.ca, amazon.com.mx, amazon.com.br

Europa

amazon.co.uk, amazon.de, amazon.fr, amazon.it, amazon.es, amazon.nl, amazon.pl, amazon.se, amazon.com.tr

Oriente Medio y África

amazon.ae, amazon.sa, amazon.eg

Asia-Pacífico

amazon.co.jp, amazon.in, amazon.sg, amazon.com.au

Todos estos parámetros generales son opcionales:

Parámetro

Qué hace

Valores

amazon_domain

Qué mercado de Amazon se va a consultar

Uno de los 20 dominios anteriores; por defecto, amazon.com

delivery_location

País de entrega por defecto

us, de, gb, ca, fr, jp, cn, au, es, br, in, mx

zip_code

Contexto de la dirección de entrega local

Un código postal

hl / gl

Idioma / país

Códigos de idioma y país

page

Página de resultados

Número entero

sort_by

Ordenar resultados de búsqueda o categorías

destacados, por precio ascendente, por precio descendente, por valoraciones, por fecha descendente, por relevancia

filter_by

Filtrar resultados

prime, respetuoso con el medio ambiente

scroll_to_bottom

Desplazamiento de página completa antes de la extracción

verdadero / falso (falso es más rápido)

wait_bottom_carousel

Esperar a que aparezca el carrusel inferior

verdadero / falso (falso es más rápido)

lazy_loading

Esperar un poco más después de que se cargue la página

Milisegundos

wait_for_offers / wait_for_video

Esperar a que aparezcan los módulos de ofertas o vídeos en las páginas de productos

verdadero / falso

delivery_location solo acepta los doce códigos indicados, por lo que no todos los dominios tienen un valor correspondiente. No hay it ni nl, por ejemplo. Cuando no necesites módulos en la parte inferior de la página, configura scroll_to_bottom=false y wait_bottom_carousel=false para obtener respuestas más rápidas. Utiliza lazy_loading cuando una página necesite más tiempo tras cargarse.

En Node.js, la configuración de Market consiste en más claves en URLSearchParams:

const params = new URLSearchParams({
  engine: "amazon",
  api_key: process.env.WSA_API_KEY,
  type: "search",
  q: "memory card",
  amazon_domain: "amazon.de",
  delivery_location: "de",
});

Documentación: Dominios compatibles

¿Cómo se lee y se almacena la respuesta JSON?

Empieza por search_parameters, que muestra tu solicitud y la URL de Amazon obtenida, y search_information. A continuación, lee las filas de search_results, category_results, el objeto único product_results, seller_profile o seller_feedback, según el tipo. Considera el resto de módulos como opcionales, conserva las cadenas de precios sin procesar con su dominio y almacena cada fila con la configuración de la solicitud correspondiente.

Las descripciones y los ejemplos de la documentación a veces sitúan los productos bajo claves diferentes. El texto de la página de categorías dice product_results, mientras que su ejemplo lo anida bajo category_results, y el texto de la página de productos del vendedor denomina seller_results, mientras que su ejemplo utiliza search_results. Por lo tanto, el analizador comprueba todas las ubicaciones documentadas y devuelve una lista vacía en lugar de bloquearse. Al añadirlo a amazon_client.py:

def product_rows(data):
    """Return the product list wherever this request type puts it."""
    for container in ("search_results", "category_results"):
        rows = (data.get(container) or {}).get("product_results")
        if isinstance(rows, list):
            return rows
    single = data.get("product_results")
    return [single] if isinstance(single, dict) else []


def absolute_link(link, amazon_domain="amazon.com"):
    """Category-style responses can return relative links such as /Item/dp/ASIN."""
    if not link or link.startswith("http"):
        return link
    return f"https://www.{amazon_domain}{link}"

product_rows() devuelve filas para los siete tipos que contienen productos. Lee seller_profile y seller_feedback por sus propias claves, tal y como se indica en sus secciones. A continuación, desglosa cada producto en una fila de almacenamiento:

# store.py
from datetime import datetime, timezone
from amazon_client import absolute_link, product_rows


def to_records(data, request):
    """One flat row per product, with the request settings that produced it."""
    captured_at = datetime.now(timezone.utc).isoformat()
    domain = request.get("amazon_domain", "amazon.com")
    amazon_url = (data.get("search_parameters") or {}).get("amazon_url")
    for row in product_rows(data):
        rating = row.get("rating") or {}
        yield {
            "captured_at": captured_at,
            "type": request["type"],
            "input": request.get("q") or request.get("category_id")
                     or request.get("seller_id") or request.get("product_id"),
            "amazon_domain": domain,
            "delivery_location": request.get("delivery_location"),
            "page": request.get("page", 1),
            "position": row.get("position"),
            "product_id": row.get("product_id"),
            "title": row.get("title"),
            "price_text": row.get("price"),
            "rating_text": rating.get("rating"),
            "total_ratings": rating.get("total_ratings"),
            "link": absolute_link(row.get("link"), domain),
            "amazon_url": amazon_url,
        }

Conserva también la respuesta sin procesar, para que puedas volver a procesarla cuando añadas campos. Distingue entre una solicitud que ha fallado (un error HTTP) y una que ha tenido éxito pero carece de un módulo (una lista vacía). Lo segundo es una observación, no un error. Para ver más patrones, consulta el análisis de respuestas JSON en Python.

La página de precios incluye salidas en formato JSON, CSV y HTML para cada plan. La documentación de Amazon describe las respuestas JSON, por lo que esta guía utiliza JSON en todo momento.

¿Cómo debería gestionar tu código los errores, los reintentos y el uso de créditos?

No vuelvas a intentar en caso de errores 401 o de validación. Corrige la clave, la suscripción o los parámetros. Vuelve a intentar los códigos 429, 500, 502 y 503 varias veces con retroceso exponencial y jitter, y reduce la concurrencia en el caso del 429. Un 422 significa que Amazon ha devuelto un error, un desafío o un tiempo de espera agotado, así que vuelve a intentarlo solo una vez cuando el fallo parezca temporal.

Estado

Cuerpo o forma

Significado

Acción

401

Access denied. No key api_key provided.

No se ha enviado ninguna clave

Corrige la configuración; no vuelvas a intentarlo

401

Access denied. Invalid api_key provided. o Authentication failure: …

Clave incorrecta o la clave no tiene permisos para la API de Amazon

Comprueba la clave y la suscripción; no lo vuelvas a intentar

Error de validación

Parameter '<name>' not allowed. y similares

Parámetro incorrecto o faltante para engine=amazon

Corrige la solicitud; no lo intentes de nuevo

422

error_type: "website"

Amazon ha devuelto un error, un desafío, un cuerpo no válido o se ha agotado el tiempo de espera

Vuelve a intentarlo una vez si es un error transitorio

429

{"error":"max_concurrent_connections"}

Se ha alcanzado el límite de concurrencia

Reducir la concurrencia, esperar un tiempo y volver a intentarlo

500 / 503

Internal Server Error / other_failure

Fallo transitorio de la API

Reintentar varias veces con un retraso variable

Una solicitud sin clave devuelve este cuerpo con el código HTTP 401:

{ "error": "Access denied. No key `api_key` provided." }

Otros mensajes de validación incluyen Parameter '<name>' is required., must be a boolean, must be in range, y cannot be used with. Significan que la propia solicitud es incorrecta, por lo que volver a intentarlo no cambia nada. Si una /v1 la solicitud responde «Este punto final está obsoleto. Utiliza /v2.», significa que tu clave no está suscrita a la API de Amazon. Suscríbete en el panel de control en lugar de cambiar de punto final.

amazon_get() implementa esta política. Reintenta las respuestas HTTP 429 y 5xx con retroceso exponencial más fluctuación aleatoria, respeta un encabezado numérico «Retry-After» cuando está presente, reintenta una vez el código 422 y genera una excepción en todos los demás casos con la clave ocultada. En caso de errores 429 repetidos, ejecuta también menos trabajadores en paralelo.

Registra dos encabezados en cada llamada: Searchdata-Call-Credit-Usage (créditos cobrados por esta llamada) y Searchdata-Current-Credit-Usage (el uso actual de tu cuenta). Un registro de una semana muestra qué tipos y mercados consumen tu asignación.

Documentación: Errores y encabezados

¿Cuánto cuesta la API de Amazon Scraper?

A fecha de octubre de 2026, la versión de prueba cuesta 0 $ por 100 solicitudes a Amazon. Los planes de pago son mensuales: Starter cuesta 59 $ por 10 000 solicitudes, Grow 375 $ por 250 000, Business 1 000 $ por 1 000 000 y Pro 2 200 $ por 2 500 000. Todos los planes cubren todos los dominios de Amazon, las API de productos y reseñas, los resultados de búsqueda y categorías, y los más vendidos.

Plan

Precio

Solicitudes de Amazon

Precio por cada 1 000

Prueba

0

100

—

Básico

59 $/mes

10 000

5,90 $

Crecimiento

375 $ al mes

250 000

1,50

Empresa

1.000 $ al mes

1 000 000

1,00

Pro

2.200 $ al mes

2 500 000

0,88

Todos los planes incluyen todos los dominios de Amazon, las API de productos y reseñas, los resultados de búsqueda y por categorías, la API de los más vendidos, la exportación en formatos JSON, CSV y HTML, y el procesamiento masivo. Los precios están en dólares estadounidenses. En esta guía, las API de productos y reseñas son las product y seller_feedback solicitudes.

Elige un plan en función de tus datos, no de conjeturas:

solicitudes al mes = datos de entrada (ASIN, palabras clave, categorías, vendedores) × dominios × ubicaciones de entrega × páginas por dato de entrada × ejecuciones al mes, más un margen para pruebas y reintentos

Por ejemplo, 400 ASIN × 2 dominios × 1 página × 4 ejecuciones semanales equivalen a 3.200 solicitudes, lo que se ajusta al plan Starter. Si añades 50 palabras clave × 2 dominios × 3 páginas × 30 ejecuciones diarias, es decir, 9.000 más, el total de 12.200 supera el límite del plan Starter, por lo que el siguiente plan es Grow. Los precios y los límites varían, por lo que la página de precios es la fuente de información oficial. ¿Aún estás eligiendo un proveedor? Consulta nuestra guía para comparar las API de scraping de Amazon.

¿Qué es lo que no hace la API de Amazon y cuándo es mejor optar por otra alternativa?

La API de Amazon cubre los nueve tipos de páginas que figuran en su documentación de referencia, y solo esos. No hay tareas asíncronas de Amazon, la cobertura de campos varía según la página y cada resultado describe un dominio, una ubicación y un momento concretos. Para otras páginas, otros mercados o conjuntos de datos ya preparados, utiliza la API Scraper, otra fuente de la API de datos o un feed gestionado.

  • Páginas que no pertenecen a los nueve tipos. Solicita una muestra de las mismas o descarga las páginas en formato HTML. Consulta cómo utilizar la API Scraper.
  • Prefieres crear tu propio rastreador. Para ejecutar y mantener el rastreador tú mismo, sigue esta guía práctica de un rastreador de Amazon en Python.
  • Quieres registros, no solicitudes. Para datos de Amazon preparados y recurrentes, consulta el conjunto de datos de productos de Amazon.
  • Necesitas otro mercado. La API de datos también cubre otros minoristas, como los datos de productos de Walmart.
  • No hay tareas asíncronas para Amazon. Todas las llamadas son síncronas, así que ejecuta tu propia cola de tareas con la política de reintentos indicada anteriormente.
  • Los campos varían según la página. Consulta una muestra representativa antes de decidirte por un esquema.
  • El uso está regulado. Recopila únicamente páginas públicas, de acuerdo con el Acuerdo de servicio de WebScrapingAPI y los requisitos que te sean aplicables.

Preguntas frecuentes

¿Existe una versión de prueba gratuita de la API de scraping de Amazon?

Sí. A partir de octubre de 2026, el plan de prueba de la API de Amazon de WebScrapingAPI cuesta 0 $ e incluye 100 solicitudes a Amazon, suficientes para probar solicitudes de productos, búsquedas, bestsellers y vendedores con tus propios datos. Crea una cuenta, suscríbete a la API de Amazon en el panel de control y guarda la clave en una variable de entorno mientras la evalúas.

¿Qué es un ASIN y dónde lo encuentro?

Un ASIN es el identificador de producto de Amazon, compuesto por diez caracteres, y la API de Amazon lo utiliza como «product_id». Lo encontrarás en la URL del producto, después de «/dp/», o en las secciones «Información del producto» o «Información adicional» de la página del producto. Un mismo ASIN puede mostrar diferentes precios y disponibilidad en distintos dominios de Amazon.

¿Cómo puedo extraer los rankings de los más vendidos de Amazon?

Envía type=bestsellers con un category_id, como «electronics», y añade parent_alias cuando quieras una subcategoría. El ayudante de categorías sin clave encuentra ambos valores a partir de una palabra clave. Los resultados se obtienen en category_results.product_results con la posición mostrada por Amazon, el ASIN, el título, el enlace, el precio y la valoración, así que guarda la hora de captura con cada fila.

¿Qué mercados de Amazon admite la API?

Admite veinte dominios de Amazon: Estados Unidos, Canadá, México, Brasil, Reino Unido, Alemania, Francia, Italia, España, Países Bajos, Polonia, Suecia, Turquía, Emiratos Árabes Unidos, Arabia Saudí, Egipto, Japón, India, Singapur y Australia. Establece `amazon_domain` para seleccionar uno de ellos y utiliza `delivery_location` o `zip_code` cuando el contexto de entrega modifique lo que muestra Amazon.

¿Puedo llamar a la API de Amazon desde el JavaScript del navegador?

No lo hagas. Una solicitud desde el navegador expondría tu clave de API a cualquiera que abra las herramientas de desarrollador, y la clave controla el límite de tu plan. Llama a la API desde un servidor, una función sin servidor o una tarea programada, lee la clave desde una variable de entorno o un gestor de secretos, y envía solo los resultados analizados al front-end.

¿Cómo puedo navegar por las páginas de resultados de búsqueda de Amazon?

Añade «page=2», «page=3» y así sucesivamente a una solicitud «type=search» con los mismos ajustes de «q», «domain» y «sort». Cada página supone una solicitud independiente que se descuenta de tu límite, así que establece un límite de páginas por palabra clave. Almacena el número de página con cada fila para poder reconstruir más adelante la clasificación completa de esa palabra clave.

¿Puede la API de Amazon extraer reseñas?

Sí. Envía «type=seller_feedback» con un «seller_id» para recopilar las reseñas de los compradores sobre un vendedor, cinco por página, cada una con el autor, la valoración por estrellas, el texto de la reseña, la fecha y si el vendedor ha respondido. Para obtener datos de reseñas a nivel de producto, «type=product» devuelve la valoración de cada ASIN y el recuento total de valoraciones. Sigue pagination.has_next_page para leer todas las páginas.

¿Por qué mi solicitud devuelve el mensaje «Parámetro no permitido»?

La API valida cada parámetro con el motor de Amazon y rechaza los nombres que no acepta. Las causas más comunes son un nombre de parámetro mal escrito o con mayúsculas incorrectas, un parámetro de otro motor o un símbolo «&» sin codificar en la palabra clave que la divide en un nuevo parámetro. Corrige la solicitud en lugar de volver a intentarlo.

¿Cómo puedo saber cuántos créditos ha consumido una solicitud?

Consulta el encabezado de respuesta «Searchdata-Call-Credit-Usage», que indica los créditos cobrados por esa llamada, y «Searchdata-Current-Credit-Usage», que muestra el consumo actual de tu cuenta. Registra ambos con el tipo de solicitud, la entrada y el dominio. A lo largo de una semana, ese registro muestra qué tipos de solicitudes y qué mercados consumen tu asignación, y si tu plan sigue siendo adecuado.

¿Puedo obtener datos de Amazon sin escribir código?

Sí, si un feed preparado se ajusta a tus necesidades. WebScrapingAPI puede proporcionar registros de Amazon como un conjunto de datos o una colección gestionada de forma programada, una vez que hayas revisado los datos de muestra de tus páginas, campos y mercados. La API es ideal para equipos que desean elegir ellos mismos los datos de entrada y la periodicidad, mientras que un feed gestionado es adecuado para analistas que solo necesitan archivos periódicos.

Empieza con 100 solicitudes gratuitas de Amazon

La API Amazon Scraper devuelve páginas de productos, búsquedas, categorías, superventas, ofertas, vendedores y reseñas de vendedores de 20 mercados de Amazon en formato JSON estructurado, y se encarga del mantenimiento del analizador por ti. Cuando conozcas tus ASIN, palabras clave, mercados y calendario de actualización, compara los planes de la API de Amazon y elige el límite de uso que mejor se adapte a tus necesidades.

Acerca del autor

Robert Sfichi, Desarrollador full-stack @ WebScrapingAPI

Robert Sfichi

Desarrollador full-stack

Robert Sfichi forma parte del equipo de WebScrapingAPI, donde contribuye al desarrollo del producto y ayuda a crear soluciones fiables que dan soporte a la plataforma y a sus usuarios.

Extracción de datos web con AWS Lambda: guía para Python y Java 2026
Guías

Extracción de datos web con AWS Lambda: guía para Python y Java 2026

TL;DR: En resumen: el web scraping con AWS Lambda funciona mejor cuando cada invocación es breve, está delimitada y se puede reintentar de forma independiente. Empieza con HTTP directo, AWS SAM y S3, y añade SQS, contenedores, renderización en navegador, proxies o una capa de recuperación gestionada solo cuando la carga de trabajo demuestre que los necesita.

Suciu Dan33 min read
Leer artículo
Cómo utilizar GoSpider: rastrear, depurar URL y extraer datos
Guías

Cómo utilizar GoSpider: rastrear, depurar URL y extraer datos

TL;DR: En resumen: GoSpider es un rastreador de línea de comandos diseñado para descubrir URL, no un extractor completo de datos estructurados. Esta guía sobre cómo utilizar GoSpider muestra cómo realizar un rastreo limitado, gestionar correctamente los resultados, pasar los datos de Colly a CSV y seguir una ruta de diagnóstico para respuestas 403 o páginas que requieren renderización con JavaScript.

Suciu Dan24 min read
Leer artículo
Cómo raspar Redfin: Guía Python de Datos Inmobiliarios
Guías

Cómo raspar Redfin: Guía Python de Datos Inmobiliarios

TL;DR: Redfin expone puntos finales de API ocultos que devuelven JSON estructurado para los listados de propiedades, lo que permite omitir por completo el frágil análisis HTML. Esta guía te guía a través de la construcción de un raspador de Python que extrae datos de alquiler y venta, busca por ubicación, supervisa los nuevos listados a través de mapas de sitio XML y exporta resultados limpios a CSV o JSON.

Suciu Dan14 min read
Leer artículo

Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.