Saltar al contenido
Empezar gratis

Blog · Artículos

Guías

Tutoriales paso a paso, buenas prácticas y guías prácticas sobre web scraping, gestión de proxies y extracción de datos.

Artículos publicados

104

Artículos

Guías

104 artículos

Extracción de datos web con AWS Lambda: guía para Python y Java 2026
Guías

Extracción de datos web con AWS Lambda: guía para Python y Java 2026

TL;DR: En resumen: el web scraping con AWS Lambda funciona mejor cuando cada invocación es breve, está delimitada y se puede reintentar de forma independiente. Empieza con HTTP directo, AWS SAM y S3, y añade SQS, contenedores, renderización en navegador, proxies o una capa de recuperación gestionada solo cuando la carga de trabajo demuestre que los necesita.

Suciu Dan33 min read
Leer artículo
Cómo utilizar GoSpider: rastrear, depurar URL y extraer datos
Guías

Cómo utilizar GoSpider: rastrear, depurar URL y extraer datos

TL;DR: En resumen: GoSpider es un rastreador de línea de comandos diseñado para descubrir URL, no un extractor completo de datos estructurados. Esta guía sobre cómo utilizar GoSpider muestra cómo realizar un rastreo limitado, gestionar correctamente los resultados, pasar los datos de Colly a CSV y seguir una ruta de diagnóstico para respuestas 403 o páginas que requieren renderización con JavaScript.

Suciu Dan24 min read
Leer artículo
Cómo raspar Redfin: Guía Python de Datos Inmobiliarios
Guías

Cómo raspar Redfin: Guía Python de Datos Inmobiliarios

TL;DR: Redfin expone puntos finales de API ocultos que devuelven JSON estructurado para los listados de propiedades, lo que permite omitir por completo el frágil análisis HTML. Esta guía te guía a través de la construcción de un raspador de Python que extrae datos de alquiler y venta, busca por ubicación, supervisa los nuevos listados a través de mapas de sitio XML y exporta resultados limpios a CSV o JSON.

Suciu Dan14 min read
Leer artículo
Cómo analizar JSON en Python: desde respuestas de API hasta JSON oculto en páginas web
Guías

Cómo analizar JSON en Python: desde respuestas de API hasta JSON oculto en páginas web

TL;DR: Analiza JSON en Python con json.loads y json.load, corrige errores de decodificación, valida datos anidados, procesa archivos de gran tamaño y extrae JSON-LD o __NEXT_DATA__ ocultos en páginas web, además de los envoltorios de WebScrapingAPI.

Suciu Dan13 min read
Leer artículo
Las 10 mejores herramientas de web scraping con IA para 2026
Guías

Las 10 mejores herramientas de web scraping con IA para 2026

TL;DR: No hay ningún scraper de IA que sea ideal para todas las cargas de trabajo. Compara 11 herramientas según el método de extracción, el tipo de usuario, las operaciones y el coste, y luego utiliza un plan de pruebas práctico para elegir la que mejor se adapte a tus necesidades.

Suciu Dan25 min read
Leer artículo
XPath Web Scraping: Guía práctica con ejemplos en Python
Guías

XPath Web Scraping: Guía práctica con ejemplos en Python

TL;DR: XPath es un lenguaje de consulta para navegar árboles HTML/XML por ruta, atributo o contenido de texto. Esta guía cubre la sintaxis XPath, ejes y funciones, a continuación, muestra raspadores Python de trabajo con lxml y Selenium. También obtendrá una hoja de trucos consolidada y una sección de solución de problemas para los errores más comunes de XPath.

Suciu Dan11 min read
Leer artículo
Tutorial de Scrapy Playwright: Scrapear sitios con JavaScript a gran escala
Guías

Tutorial de Scrapy Playwright: Scrapear sitios con JavaScript a gran escala

TL;DR: Scrapy-Playwright te permite renderizar páginas con mucho JavaScript directamente dentro de arañas Scrapy controlando navegadores reales Chromium, Firefox o WebKit a través de Playwright. Este tutorial te guía a través de la instalación, configuración, interacciones de página, intercepción AJAX, anti-detección, y una estructura de proyecto lista para producción para que puedas scrapear sitios dinámicos sin dejar el ecosistema Scrapy.

Raluca Penciuc21 min read
Leer artículo
Cómo extraer datos de Expedia con Python: hoteles, precios y valoraciones (Guía 2026)
Guías

Cómo extraer datos de Expedia con Python: hoteles, precios y valoraciones (Guía 2026)

TL;DR: Extrae los listados de hoteles de Expedia con Python utilizando renderizado en JavaScript, proxies, selectores CSS y paginación; a continuación, limpia los datos y expórtalos a un archivo CSV.

Mihai Maxim14 min read
Leer artículo
Guía de la API de extracción de datos de SERP: Google, Bing, DuckDuckGo, Yandex
Guías

Guía de la API de extracción de datos de SERP: Google, Bing, DuckDuckGo, Yandex

TL;DR: Envía tu primera solicitud a la API SERP de WebScrapingAPI con la clave en una variable de entorno; a continuación, filtra los resultados de Google por país, idioma y dispositivo; lee los archivos JSON de Google y Bing de forma defensiva; extrae tú mismo el código HTML de DuckDuckGo y Yandex; ejecuta tareas asíncronas de Google, vuelve a intentarlo según los códigos de error documentados y elige un plan basándote en los precios de Google a partir de octubre de 2026.

Suciu Dan25 min read
Leer artículo
Cómo utilizar la API de Amazon Scraper: guía de inicio rápido
Guías

Cómo utilizar la API de Amazon Scraper: guía de inicio rápido

TL;DR: Empieza a utilizar la API de WebScrapingAPI para extraer datos de Amazon: envía tu primera solicitud, elige entre nueve tipos de solicitud (productos, búsquedas, superventas, ofertas, opiniones de vendedores y mucho más), selecciona entre 20 mercados de Amazon, analiza cada respuesta JSON, gestiona los errores y los reintentos, y elige un plan.

Robert Sfichi25 min read
Leer artículo
Scrapy vs Beautiful Soup: Qué Python Scraper elegir
Guías

Scrapy vs Beautiful Soup: Qué Python Scraper elegir

TL;DR: Scrapy es un completo framework de rastreo que maneja peticiones, análisis y exportación de datos en un solo paquete. Beautiful Soup es una biblioteca ligera de análisis sintáctico que se combina con un cliente HTTP como requests. Elige Scrapy cuando necesites un rastreo concurrente a gran escala con pipelines integrados. Elige Beautiful Soup cuando quieras una configuración rápida y mínima para analizar un puñado de páginas.

Mihnea-Octavian Manolache12 min read
Leer artículo
Tutorial de Scrapy Splash: Renderizar páginas JavaScript
Guías

Tutorial de Scrapy Splash: Renderizar páginas JavaScript

TL;DR: Scrapy Splash empareja el rápido motor de rastreo de Scrapy con el navegador sin cabeza Splash para renderizar páginas con mucho JavaScript. Este tutorial de Scrapy Splash te guía a través de la configuración de Docker, la configuración del proyecto Scrapy, los conceptos básicos de SplashRequest, los scripts Lua para desplazarse y hacer clic, la integración de proxy y la solución de los errores más comunes que encontrarás.

Ștefan Răcilă13 min read
Leer artículo
Scrapear datos de productos de Amazon con Python: Guía práctica
Guías

Scrapear datos de productos de Amazon con Python: Guía práctica

TL;DR: Las páginas de productos de Amazon están repletas de datos valiosos (precios, valoraciones, reseñas, ASIN), pero extraerlos de forma fiable requiere algo más que una petición HTTP básica. Esta guía te guía a través de la construcción de un scraper Python con Requests y BeautifulSoup, el manejo de la paginación y las defensas anti-bot, la exportación a CSV o JSON, y la alimentación de los resultados en los flujos de trabajo LLM. También aprenderás cuándo utilizar una API de scraping en lugar de desarrollar tu propia solución.

Raluca Penciuc18 min read
Leer artículo
Las mejores herramientas de job scraping en 2026: comparativa y guía
Guías

Las mejores herramientas de job scraping en 2026: comparativa y guía

TL;DR: Las herramientas de job scraping van desde ligeros servicios API y automatización de navegadores de código abierto hasta extractores basados en IA y plataformas visuales sin código. En esta guía se comparan las mejores herramientas de scraping de empleo de Google Jobs, Indeed, Monster, Upwork y mercados de autónomos, y a continuación se explica cómo crear una canalización fiable con deduplicación, programación y gestión antirrobot para empezar a recopilar datos de empleo limpios a escala.

Gabriel Cioci19 min read
Leer artículo
Evitar Cloudflare con Selenium: 5 métodos Python (2026)
Guías

Evitar Cloudflare con Selenium: 5 métodos Python (2026)

TL;DR: Cloudflare bloquea vanilla Selenium mediante fingerprinting del navegador, inspección de cabeceras y análisis de señales de comportamiento. Esta guía recorre cinco métodos prácticos de desvío (ChromeDriver no detectado, Selenium Stealth, SeleniumBase UC mode, integración de CAPTCHA-solver y API de raspado), con código Python, una tabla comparativa y un manual de solución de problemas para que puedas elegir el enfoque adecuado para tu escala y presupuesto.

Mihnea-Octavian Manolache21 min read
Leer artículo
7 mejores API de SERP en 2026: Comparación de precios y características
Guías

7 mejores API de SERP en 2026: Comparación de precios y características

TL;DR: No existe una API SERP oficial de Google, por lo que proveedores externos cubren este vacío. Los precios oscilan aproximadamente entre 0,30 y 15 dólares por cada mil búsquedas, y la elección correcta depende del volumen, el presupuesto y las funciones de las SERP que necesites extraer. En esta guía se comparan los principales proveedores, se desglosa el coste real a escala y se ofrece un marco de decisión para preseleccionar la mejor API de SERP para tu proyecto.

Andrei Ogiolan22 min read
Leer artículo
Cómo configurar Axios Proxy en Node.js: Auth, Rotación, SOCKS5
Guías

Cómo configurar Axios Proxy en Node.js: Auth, Rotación, SOCKS5

TL;DR: Axios enruta las peticiones a través de un proxy aceptando un objeto proxy con los campos host, port y auth opcional. Esta guía cubre cómo establecer la configuración del proxy Axios desde cero: cableado básico, proxies autenticados, tunelado HTTPS, un sistema de rotación usando interceptores, SOCKS5 vía socks-proxy-agent, y diagnóstico de errores comunes. Cada fragmento es código Node.js copiable y pegable.

Suciu Dan12 min read
Leer artículo
Archivo de descarga de Puppeteer: 4 métodos para Node.js
Guías

Archivo de descarga de Puppeteer: 4 métodos para Node.js

TL;DR: Un flujo de trabajo de descarga de archivos de Puppeteer tiene cuatro buenas formas: haga clic en un botón y deje que Chrome escriba en una carpeta que usted controla, ejecute fetch() dentro de la página y la tubería base64 de vuelta a Node, dirija el protocolo DevTools de Chrome con eventos de progreso de descarga, o salte el navegador y obtenga la URL con Axios usando cookies cosechadas de la sesión de Puppeteer. Elige por tamaño de archivo, autenticidad, y cómo el sitio expone el enlace.

Mihnea-Octavian Manolache41 min read
Leer artículo
Cómo utilizar un proxy en Node-Fetch: Guía práctica
Guías

Cómo utilizar un proxy en Node-Fetch: Guía práctica

TL;DR: Node-Fetch no tiene un interruptor de proxy incorporado, por lo que debe conectar un agente HTTP, HTTPS o SOCKS5 a la solicitud a través de su opción de agente. Esta guía explica cómo usar un proxy en Node-Fetch de principio a fin: proxies HTTP y HTTPS autenticados, SOCKS5, rotación, reintentos, casos extremos de TLS, resolución de problemas y la ruta moderna undici para Node 18+ native fetch.

Mihnea-Octavian Manolache13 min read
Leer artículo
Web Scraping Tablas JavaScript en Python: De las API ocultas a Playwright
Guías

Web Scraping Tablas JavaScript en Python: De las API ocultas a Playwright

TL;DR: Web scraping JavaScript tables in Python raramente necesita un navegador headless. Abra DevTools, encuentre el punto final JSON que hidrata la cuadrícula, reprodúzcala con solicitudes, pagínela y vuelva a Playwright solo cuando la llamada de red esté firmada, cifrada o sellada de alguna otra forma.

Andrei Ogiolan13 min read
Leer artículo
Cómo raspar tablas HTML en Golang con Colly: Guía de principio a fin
Guías

Cómo raspar tablas HTML en Golang con Colly: Guía de principio a fin

TL;DR: Esta guía muestra cómo raspar tablas HTML en Golang de principio a fin: elegir entre Colly, goquery y golang.org/x/net/html, apuntar al <tbody> correcto, modelar filas como una estructura tipada y exportar JSON y CSV limpios. También obtendrá patrones de paginación, antibloqueo y tablas renderizadas en JavaScript.

Andrei Ogiolan12 min read
Leer artículo
Playwright Web Scraping: La guía completa para Python y Node.js
Guías

Playwright Web Scraping: La guía completa para Python y Node.js

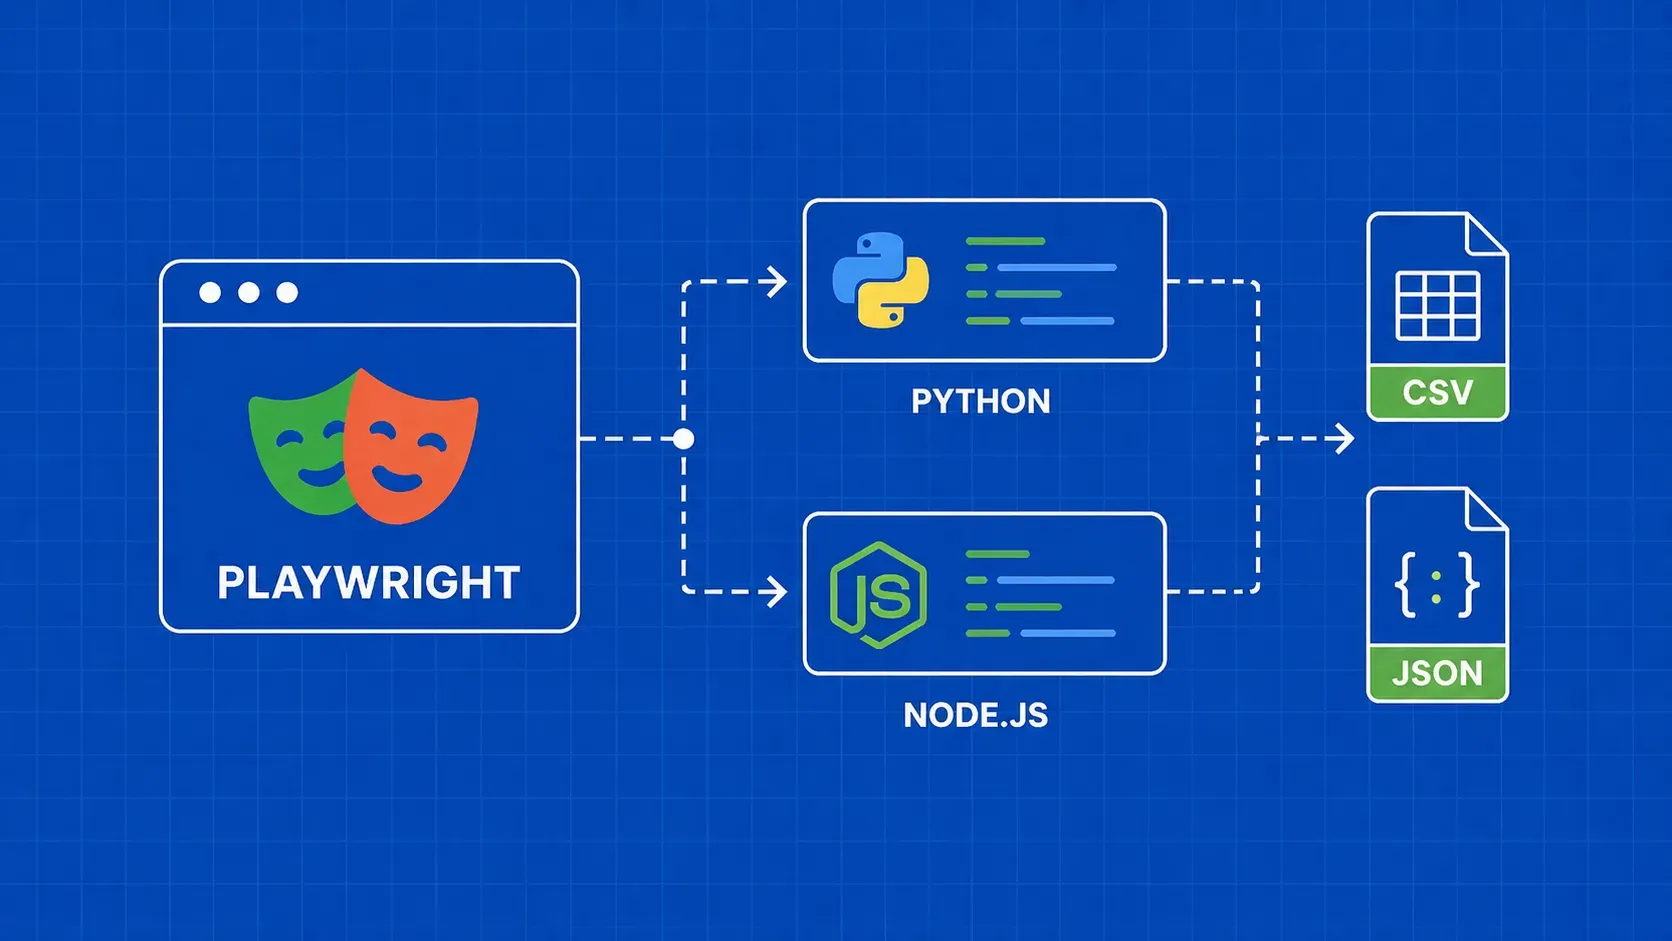
TL;DR: Playwright te ofrece una automatización completa del navegador para el scraping de sitios con mucho JavaScript, con soporte de primera clase tanto para Python como para Node.js. Esta guía le guiará a través de la instalación, extracción de elementos, configuración de proxy, antidetección, paginación, descarga de imágenes y exportación de datos a CSV o JSON, todo ello con ejemplos de código en ambos lenguajes.

Mihnea-Octavian Manolache17 min read
Leer artículo
Cómo buscar reseñas en Google Maps: Una guía práctica en Python
Guías

Cómo buscar reseñas en Google Maps: Una guía práctica en Python

TL;DR: Averiguar cómo raspar Google Maps para las revisiones se reduce a tres vías de método: un raspador de Selenium DIY detrás de un proxy giratorio, una API de raspado con instrucciones de renderizado, o una API de revisiones de Maps estructurada que devuelve JSON analizado. Esta guía recorre las tres vías en Python con código copiable y pegable, patrones de paginación, tácticas antibloqueo y un paso final de limpieza que convierte las reseñas sin procesar en algo que una empresa puede utilizar realmente.

Andrei Ogiolan18 min read
Leer artículo
Descarga páginas web y archivos sin esfuerzo con Python y wget
Guías

Descarga páginas web y archivos sin esfuerzo con Python y wget

TL;DR: Automatiza la extracción de datos web y la descarga de archivos con Python y wget. Aprende a utilizar estas herramientas para recopilar datos y ahorrar tiempo.

Gabriel Cioci8 min read
Leer artículo
Cómo utilizar proxies con Python Requests: De lo básico a la producción
Guías

Cómo utilizar proxies con Python Requests: De lo básico a la producción

TL;DR: Esta guía explica cómo usar proxies con Python Requests de principio a fin: un dictado de proxies funcional, URLs autenticadas, variables de entorno, reutilización de sesiones, SOCKS5 sin fugas de DNS, y un pool de rotación con reintentos y un disyuntor. Al final, usted sabrá cuando una API gestionada gana su sustento sobre una piscina de bricolaje.

Ștefan Răcilă11 min read
Leer artículo
Cómo extraer datos de los resultados de lugares de Google Maps
Guías

Cómo extraer datos de los resultados de lugares de Google Maps

TL;DR: Descubre cómo extraer datos de los resultados de lugares de Google Maps con nuestra API utilizando Node.js: guía paso a paso, ventajas de un extractor profesional y mucho más. Obtén fácilmente el data_id, las coordenadas y el parámetro «build data».

Andrei Ogiolan7 min read
Leer artículo
Web Scraping con Regex: Guía práctica
Guías

Web Scraping con Regex: Guía práctica

TL;DR: Web scraping con regex brilla cuando necesitas patrones de texto cortos y predecibles (precios, SKUs, correos electrónicos, fechas) de HTML en el que ya confías. Empareje el módulo re de Python con Beautiful Soup, extienda sus patrones a un nodo analizado en lugar de a una marca sin procesar y mantenga el regex fuera del camino del análisis completo del árbol HTML. Esta guía muestra un raspador de título y precio, características avanzadas de regex y los problemas que afectan a los raspadores reales en producción.

Mihai Maxim12 min read
Leer artículo
Del análisis de opiniones al marketing: las numerosas ventajas del web scraping en Twitter
Guías

Del análisis de opiniones al marketing: las numerosas ventajas del web scraping en Twitter

TL;DR: Saca el máximo partido a los datos de Twitter con técnicas avanzadas de web scraping. Aprende a extraer datos de Twitter para el análisis de opiniones, el marketing y la inteligencia empresarial. Guía completa con TypeScript.

Raluca Penciuc9 min read
Leer artículo
Cómo utilizar un proxy con HttpClient en C#
Guías

Cómo utilizar un proxy con HttpClient en C#

TL;DR: Para usar un proxy con HttpClient en C#, construye un WebProxy, adjúntalo a un HttpClientHandler (o SocketsHttpHandler), y pasa ese handler al constructor de HttpClient. Para producción, cambia los bucles manuales por IHttpClientFactory, añade NetworkCredential para proxies autenticados, y envuelve las llamadas en reintentos con Polly para que las IPs muertas no tumben tu trabajador.

Suciu Dan19 min read
Leer artículo
Cómo raspar tablas HTML con Python
Guías

Cómo raspar tablas HTML con Python

TL;DR: La mayoría de las tablas HTML se pueden raspar con una sola línea de pandas.read_html. Cuando la tabla es paginada, JavaScript-rendered, o tiene cabeceras fusionadas, cambie a Requests + BeautifulSoup o un navegador headless como Playwright. Esta guía le da una matriz de decisión, código de trabajo para los tres enfoques, y los pasos de limpieza que convierten las filas raspadas en datos listos para la tubería.

Andrei Ogiolan18 min read
Leer artículo
Cheerio vs Titiritero: Cómo elegir la herramienta adecuada
Guías

Cheerio vs Titiritero: Cómo elegir la herramienta adecuada

TL;DR: Cheerio es un analizador HTML ligero; Puppeteer maneja un navegador Chromium real. Usa Cheerio cuando los datos ya estén en el HTML crudo, Puppeteer cuando JavaScript los renderice, y combínalos cuando una página con mucho JS tenga muchos campos que extraer por visita.

Sergiu Inizian9 min read
Leer artículo
Cómo raspar Realtor.com: Guía práctica 2026
Guías

Cómo raspar Realtor.com: Guía práctica 2026

TL;DR: Si estás trabajando en cómo scrapear Realtor.com limpiamente, hay tres cosas que importan más: selectores estables que sobrevivan a sus nombres de clase hash, una capa de petición que sobreviva a la pila anti-bot de Realtor, y código que recorra tanto las páginas de listado como las de detalle. Esta guía es la compilación completa en Python, con tácticas antibloqueo y exportaciones preparadas para LLM.

Raluca Penciuc15 min read
Leer artículo
Web Scraping Booking.com: Hoteles, precios y reseñas (Guía 2026)
Guías

Web Scraping Booking.com: Hoteles, precios y reseñas (Guía 2026)

TL;DR: Esta guía te guía a través del raspado web de Booking.com de principio a fin en Python: extrayendo listados de búsqueda, páginas de hoteles, precios por noche y opiniones de huéspedes. Obtendrás dos métodos complementarios: un flujo de trabajo Selenium Wire para páginas renderizadas en JS y una ruta más rápida que llama directamente al punto final interno /dml/graphql de Booking.com, además de un libro de jugadas antibloqueo, manejo de divisas y una solución para el límite de paginación de aproximadamente 1.000 resultados.

Raluca Penciuc16 min read
Leer artículo
Cómo extraer datos de Idealista: Un manual para 2026
Guías

Cómo extraer datos de Idealista: Un manual para 2026

TL;DR: Idealista es el mercado inmobiliario más grande de España, Italia y Portugal, pero se encuentra detrás de una seria pila anti-bot que bloquea rápidamente a los scrapers ingenuos. Esta guía te guía a través de cómo raspar datos de Idealista de extremo a extremo en Python, cubriendo el mapeo del sitio, Selenium con undetected-chromedriver, manejo de DataDome, rotación de proxy y exportaciones limpias, con endurecimiento de producción que los competidores suelen omitir.

Raluca Penciuc17 min read
Leer artículo
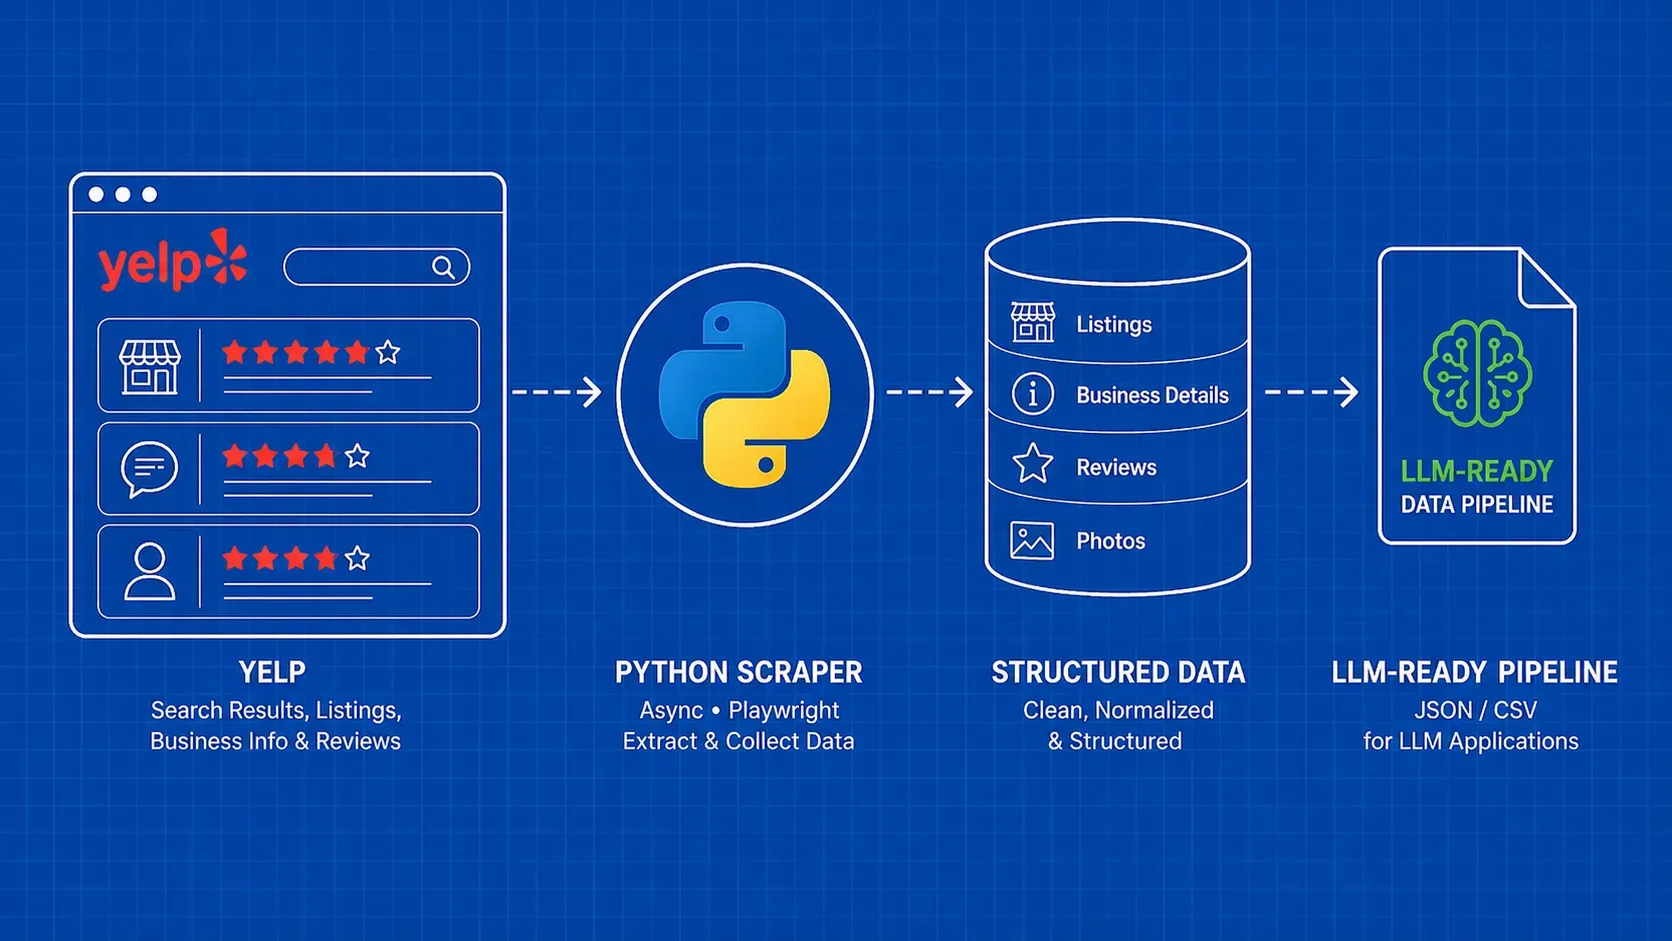
Cómo raspar Yelp con Python: Reseñas, listados y pipelines de datos listos para el LLM
Guías

Cómo raspar Yelp con Python: Reseñas, listados y pipelines de datos listos para el LLM

TL;DR: Esta guía te guía a través de la construcción de un scraper completo de Yelp en Python, cubriendo los resultados de búsqueda, detalles de negocios y reseñas con código de trabajo. También aprenderás cómo manejar las protecciones anti-bot, exportar datos a CSV o JSON, y alimentar reseñas raspadas en un LLM para el análisis de sentimiento, algo que ningún otro tutorial de raspado de Yelp cubre.

Raluca Penciuc16 min read
Leer artículo
Cómo extraer datos de los vendedores cercanos de Google Shopping con Node.js
Guías

Cómo extraer datos de los vendedores cercanos de Google Shopping con Node.js

TL;DR: Descubre cómo utilizar Node.js y nuestra API para extraer datos de vendedores cercanos de Google Shopping. Extrae información valiosa de forma rápida y sencilla con nuestro extractor web profesional.

Andrei Ogiolan6 min read
Leer artículo
Formulario de envío de Puppeteer: Guía Node.js para 2026
Guías

Formulario de envío de Puppeteer: Guía Node.js para 2026

TL;DR: Utilice page.locator(selector).fill(value) para scripts de formularios de envio rapidos y deterministas de Puppeteer y page.type() cuando la pagina busca pulsaciones reales (autocompletar, anti-bot, validacion en vivo). Envie haciendo click en el boton, pulsando Enter, o llamando a form.requestSubmit(), y espere siempre una señal concreta de exito en lugar de un tiempo de espera fijo.

Mihnea-Octavian Manolache15 min read
Leer artículo
Cómo crear un raspador web con Pyppeteer (Guía 2026)
Guías

Cómo crear un raspador web con Pyppeteer (Guía 2026)

TL;DR: Pyppeteer es el port no oficial a Python de Puppeteer y todavía funciona para manejar un Chromium real desde asyncio. En esta guía lo instalarás, escribirás un scraper web moderno con Pyppeteer usando asyncio.run y try/finally, manejarás esperas, formularios, capturas de pantalla, scroll infinito, cookies y proxies, y aprenderás cuándo migrar a Playwright, Selenium o una API de scraping alojada.

Mihnea-Octavian Manolache12 min read
Leer artículo
Cómo raspar Walmart.com: Guía completa 2026
Guías

Cómo raspar Walmart.com: Guía completa 2026

TL;DR: Esta guía explica cómo hacer web scrape de datos de productos Walmart de principio a fin en Python, desde analizar el JSON __NEXT_DATA__ oculto hasta escalar con proxies, reintentos y búsquedas asíncronas. También traza una línea honesta para cuando una API de raspado administrado supera DIY.

Raluca Penciuc14 min read
Leer artículo
Aprende a extraer las especificaciones de los productos de Google Shopping con Node.js
Guías

Aprende a extraer las especificaciones de los productos de Google Shopping con Node.js

TL;DR: Descubre la guía paso a paso para extraer de la web las especificaciones de los productos de Google Shopping utilizando Node.js. Mejora tus habilidades en la extracción de datos web con este tutorial.

Andrei Ogiolan6 min read
Leer artículo
Cómo evitar Cloudflare en 2026: herramientas, código y tácticas
Guías

Cómo evitar Cloudflare en 2026: herramientas, código y tácticas

TL;DR: Cloudflare bloquea a los "scrapers" superponiendo huellas dactilares TLS, desafíos JavaScript, análisis de comportamiento y CAPTCHAs Turnstile en una puntuación de confianza compuesta. Para eludir a Cloudflare de forma fiable, es necesario coincidir con todas las capas simultáneamente. Esta guía cubre la pila de detección, compara cuatro herramientas prácticas (Nodriver, SeleniumBase UC, Camoufox, curl-impersonate), y camina a través de estrategias de proxy, persistencia de sesión, solución de problemas de error y escalado de producción.

Mihnea-Octavian Manolache17 min read
Leer artículo
Empieza a usar Web Stealth Proxy como un experto: guía de inicio rápido
Guías

Empieza a usar Web Stealth Proxy como un experto: guía de inicio rápido

TL;DR: Descubre cómo usar Web Stealth Proxy como un experto con nuestra guía de inicio rápido. Obtén instrucciones paso a paso para mejorar tu uso del proxy y llevar tu privacidad en línea al siguiente nivel. ¡Empieza hoy mismo!

Mihai Maxim6 min read
Leer artículo
Cómo scrapear YouTube con Python en 2026
Guías

Cómo scrapear YouTube con Python en 2026

TL;DR: Este es un libro de jugadas 2026 sobre cómo scrapear YouTube con Python. Elegirás el método adecuado (Data API v3, yt-dlp, endpoints ocultos /youtubei/v1/, o un scraper gestionado) usando una matriz de decisión, luego ejecutarás código para metadatos de vídeo, comentarios, canales, búsqueda, Shorts y transcripciones, con una sección de producción sobre proxies, cabeceras y 429 backoff para que no te bloqueen.

Raluca Penciuc21 min read
Leer artículo
Librerías Python Headless Browser para Web Scraping en 2026
Guías

Librerías Python Headless Browser para Web Scraping en 2026

TL;DR: Un navegador sin cabeza Python le permite renderizar JavaScript, hacer clic a través de SPAs, y raspar sitios que los clientes HTTP no pueden alcanzar. Selenium es el más seguro por defecto, Playwright es la elección moderna para el nuevo código, Pyppeteer y Splash todavía tienen usos de nicho, y una API de navegador alojado es lo que se busca cuando las defensas anti-bot o la escala comienzan a morder.

Mihnea-Octavian Manolache22 min read
Leer artículo
Analizadores sintácticos de HTML y XML en Ruby: una comparación basada en la carga de trabajo
Guías

Analizadores sintácticos de HTML y XML en Ruby: una comparación basada en la carga de trabajo

TL;DR: En resumen: elige los analizadores de HTML y XML para Ruby en función de la carga de trabajo, no según una clasificación genérica. Empieza con Nokogiri para el análisis general de árboles HTML y XML; plantéate utilizar Ox o LibXML para Ruby en tareas específicas de XML; y añade Selenium solo cuando sea necesario que un navegador real muestre la página o interactúe con ella.

Raluca Penciuc15 min read
Leer artículo
Errores de estado del proxy: diagnóstico del salto fallido de la solicitud
Guías

Errores de estado del proxy: diagnóstico del salto fallido de la solicitud

TL;DR: Localiza el salto fallido antes de volver a intentar una solicitud de proxy. Utiliza los códigos de estado, los resultados de CONNECT y los registros de diagnóstico seguros para distinguir los fallos del proxy de las respuestas del destino.

Mihai Maxim17 min read
Leer artículo
Cómo extraer datos de una tabla HTML con JavaScript y exportarlos a un archivo CSV limpio
Guías

Cómo extraer datos de una tabla HTML con JavaScript y exportarlos a un archivo CSV limpio

TL;DR: En resumen: Primero, determina si las filas de la tabla están presentes en la respuesta HTTP, se obtienen mediante una solicitud de datos o requieren que un navegador las represente. A continuación, utiliza el script estático de Axios y Cheerio o la ruta específica de Puppeteer que se indica a continuación para extraer datos de una tabla HTML en JavaScript, validar registros basados en encabezados, eliminar duplicados de páginas y generar un archivo CSV de forma segura. Una tabla HTML organiza la información en filas y columnas, normalmente mediante los elementos <table>, <tr>, <th> y <td>. Extraer datos de una tabla HTML en JavaScript significa recuperar o renderizar ese marcado, convertir cada fila de datos en un objeto JavaScript, validar el resultado y serializarlo a un formato como CSV.

Mihai Maxim15 min read
Leer artículo
Análisis de HTML en Java con Jsoup
Guías

Análisis de HTML en Java con Jsoup

TL;DR: Jsoup es la biblioteca por defecto para el análisis sintáctico de HTML en Java. Esta guía recorre el ciclo de vida completo (configuración de Maven, carga de un documento, selectores CSS, DOM traversal, extracción, modificación y serialización), además de un proyecto de scraping ejecutable, manejo de errores, paginación y los límites que te empujan hacia un navegador sin cabeza o una API de scraping.

Mihai Maxim13 min read
Leer artículo
Python Extraer Texto De HTML
Guías

Python Extraer Texto De HTML

TL;DR: Para extraer texto de HTML en Python, analice el marcado con un analizador real (BeautifulSoup, lxml.html o html-text), elimine los scripts, estilos y cromo del sitio, y luego normalice los espacios en blanco y Unicode antes de guardar. Esta guía compara las principales bibliotecas, corrige las trampas comunes de limpieza, y termina con un rastreador ejecutable que escribe JSONL más archivos .txt por página.

Mihai Maxim26 min read
Leer artículo
Web Scraping con Scrapy: Playbook 2026
Guías

Web Scraping con Scrapy: Playbook 2026

TL;DR: Esta es una guía de opinión, de extremo a extremo para web scraping con Scrapy en 2026. Instalarás Scrapy, crearás prototipos de selectores en el shell, construirás una araña multipágina de comercio electrónico, limpiarás elementos con cargadores de elementos, persistirás en una base de datos, endurecerás la configuración contra prohibiciones y atornillarás Scrapy-Playwright para páginas renderizadas en JavaScript.

Mihai Maxim18 min read
Leer artículo
JavaScript con Scrapy: primero los datos, renderizar solo cuando sea necesario
Guías

JavaScript con Scrapy: primero los datos, renderizar solo cuando sea necesario

TL;DR: En resumen: El uso de JavaScript con Scrapy no siempre requiere un navegador. En primer lugar, analiza la respuesta sin procesar, las solicitudes de red y el estado de la página incrustada; añade «scrapy-playwright» solo cuando los datos de destino dependan realmente de la ejecución en el navegador y, a continuación, controla de forma deliberada las esperas, las interacciones, la limpieza y la concurrencia.

Mihai Maxim13 min read
Leer artículo
Axios Establecer cabeceras en 2026: El libro de jugadas del desarrollador
Guías

Axios Establecer cabeceras en 2026: El libro de jugadas del desarrollador

TL;DR: Axios establece cabeceras a través de cinco capas, configuración por petición, valores predeterminados globales, instancias axios.create(), interceptores de petición y respuesta, y la propia respuesta. Esta guía recorre cada capa con fragmentos ejecutables de la v1, y luego corrige los cuatro errores que afectan a todo el mundo: límites multiparte, cookies CORS, certificados autofirmados y cabeceras.

Mihnea-Octavian Manolache18 min read
Leer artículo
Extracción de datos web con JavaScript y Node.js: una guía práctica
Guías

Extracción de datos web con JavaScript y Node.js: una guía práctica

TL;DR: Extrae datos de la web con JavaScript y Node.js: recupera y analiza páginas con la función nativa `fetch` y Cheerio, rastrea sitios web paginados de forma respetuosa, accede a puntos finales JSON ocultos, visualiza páginas con Playwright o Puppeteer, prueba tu analizador sin conexión y envía las páginas bloqueadas a una API de extracción de datos sin necesidad de reescribirla.

Robert Sfichi26 min read
Leer artículo
Web scraping con Ruby: de Faraday y Nokogiri a Selenium
Guías

Web scraping con Ruby: de Faraday y Nokogiri a Selenium

TL;DR: El «web scraping» con Ruby consiste en solicitar contenido web, localizar valores útiles en HTML o en un documento visualizado por el navegador y convertir dichos valores en registros estructurados mediante código Ruby. El enfoque más fácil de mantener es utilizar la pila más ligera que permita acceder a los datos de forma fiable.

Raluca Penciuc20 min read
Leer artículo
Web Scraping con PHP: Guía práctica de bibliotecas, código y buenas prácticas
Guías

Web Scraping con PHP: Guía práctica de bibliotecas, código y buenas prácticas

TL;DR: PHP es un lenguaje perfectamente apto para el web scraping, gracias a extensiones integradas como cURL y DOMDocument, además de un rico ecosistema Composer que incluye Guzzle, Symfony DomCrawler y Symfony Panther para la navegación headless. Esta guía te guía a través del flujo de trabajo completo: obtención de páginas, análisis sintáctico de HTML, almacenamiento de resultados en CSV/JSON/MySQL, gestión de errores y evitación de bloqueos.

Sorin-Gabriel Marica19 min read
Leer artículo
Adiós al web scraping en Node.js: load() para un scraper probado
Guías

Adiós al web scraping en Node.js: load() para un scraper probado

TL;DR: En resumen: Cheerio es un analizador HTML rápido para Node.js con una API al estilo de jQuery, así que sirve para web scraping cuando los datos ya están en el HTML sin procesar de la página. Usa fetch con Cheerio para páginas estáticas, llama directamente al JSON cuando la página carga así los datos y renderiza con un navegador solo cuando JavaScript construye el contenido. Esta guía crea un scraper probado con paginación, reintentos y exportación a JSON o CSV.

Raluca Penciuc21 min read
Leer artículo
XPath Cheat Sheet para Web Scraping: Sintaxis, ejes y código real
Guías

XPath Cheat Sheet para Web Scraping: Sintaxis, ejes y código real

TL;DR: Esta hoja de trucos XPath cubre la sintaxis, predicados, ejes y funciones que realmente necesita para el web scraping, además de una tabla de traducción de CSS a XPath y ejemplos ejecutables de Puppeteer y Scrapy. Úsala como referencia de escritorio la próxima vez que un selector CSS se rompa silenciosamente en un sitio del que dependas.

Mihai Maxim15 min read
Leer artículo
Cómo utilizar cURL con Python en 2026
Guías

Cómo utilizar cURL con Python en 2026

TL;DR: Hay tres formas sensatas de usar cURL con Python: shell out al binario curl con subproceso, bind a libcurl a través de PycURL, o saltarse curl por completo y usar la librería Requests. Saber cómo usar bien cURL con Python significa conocer los tres. Esta guía te da ejemplos ejecutables para los tres, una tabla de traducción curl-flag-a-Python, y una matriz de decisión para que puedas elegir la herramienta correcta la primera vez.

Andrei Ogiolan15 min read
Leer artículo
Aprende a utilizar Node-Fetch (NPM) para realizar solicitudes HTTP en Node.js
Guías

Aprende a utilizar Node-Fetch (NPM) para realizar solicitudes HTTP en Node.js

TL;DR: Descubre cómo utilizar el recién lanzado node-fetch para realizar solicitudes HTTP directamente desde Node.js. Node-fetch es el equivalente a la API fetch en JavaScript.

Sorin-Gabriel Marica9 min read
Leer artículo
Los 6 mejores clientes HTTP de Python para el scraping web
Guías

Los 6 mejores clientes HTTP de Python para el scraping web

TL;DR: Elige el cliente HTTP de Python más adecuado para tu rastreador. Compara Requests, HTTPX, aiohttp, urllib3, curl_cffi y Niquests, con ejemplos prácticos y consejos sobre fiabilidad.

Mihnea-Octavian Manolache23 min read
Leer artículo
Cómo hacer scraping en LinkedIn en 2026: una guía en Python
Guías

Cómo hacer scraping en LinkedIn en 2026: una guía en Python

TL;DR: El raspado de LinkedIn significa trabajar alrededor de un muro de autenticación agresivo, seguimiento de comportamiento, y TLS fingerprinting. Esta guía te ofrece un árbol de decisiones método por método, patrones de trabajo en Python para trabajos, perfiles y empresas (API oculta, JSON-LD, Selenium cuando sea necesario) y una lista de comprobación antibloqueo consolidada para 2026.

Suciu Dan15 min read
Leer artículo
las 12 mejores herramientas gratuitas de Web Scraping en 2026: Comparativa
Guías

las 12 mejores herramientas gratuitas de Web Scraping en 2026: Comparativa

TL;DR: Las 12 mejores herramientas gratuitas de web scraping en 2026 se dividen en cuatro categorías: APIs gestionadas con créditos gratuitos, frameworks de código abierto, extensiones de navegador sin código y extractores de IA. Elige primero por caso de uso (raspado puntual frente a pipeline programado) y luego por nivel de conocimientos. La mayoría de los niveles gratuitos cubren la evaluación, no la producción; en el momento en que su tasa de éxito caiga por debajo de ~90% o queme más horas en bloques que en datos, es hora de pasar a una API de pago.

Suciu Dan30 min read
Leer artículo
Alternativas a la API de Yahoo Finance: una guía para desarrolladores
Guías

Alternativas a la API de Yahoo Finance: una guía para desarrolladores

TL;DR: Compara los proveedores de datos de mercado documentados y, a continuación, realiza la migración teniendo en cuenta los requisitos específicos relativos a las fuentes de datos, la zona horaria, los ajustes, las licencias y la validación.

Raluca Penciuc16 min read
Leer artículo
¿Es legal el Web Scraping en 2026? Marco de cumplimiento
Guías

¿Es legal el Web Scraping en 2026? Marco de cumplimiento

TL;DR: ¿Es legal el web scraping? Normalmente sí, con algunas salvedades. La legalidad depende del tipo de datos, la ruta de acceso, las jurisdicciones implicadas y lo que se haga con el resultado. Esta guía le ofrece un veredicto directo, un marco de cinco minutos previo al raspado, los casos que importan y una lista de comprobación que puede ejecutar antes de realizar el envío.

Suciu Dan16 min read
Leer artículo
Las 9 mejores API de búsqueda de imágenes de Google en 2022
Guías

Las 9 mejores API de búsqueda de imágenes de Google en 2022

TL;DR: Descubre las 9 mejores herramientas de la API de Búsqueda de imágenes de Google para extraer imágenes de forma eficaz. Aprende a optimizar tu búsqueda de imágenes y a mejorar tu recopilación de datos con estas potentes API.

Raluca Penciuc10 min read
Leer artículo
Cómo probar proxies: 6 métodos prácticos
Guías

Cómo probar proxies: 6 métodos prácticos

TL;DR: Los proxies malos son caros. Queman ancho de banda, provocan bloqueos y corrompen silenciosamente los datos de los que dependen tus scrapers. Esta guía muestra cómo probar los proxies a través de cinco señales de salud (conectividad, IP de salida, velocidad, anonimato y reputación) usando ping, curl, verificadores en línea, bases de datos IP y un script Python reutilizable que puede colocar en su tubería CI.

Robert Munceanu11 min read
Leer artículo
Las mejores API de web scraping en 2026: comparación de 12 según su finalidad y coste
Guías

Las mejores API de web scraping en 2026: comparación de 12 según su finalidad y coste

TL;DR: En resumen: La mejor API de web scraping depende de la tarea: una API de páginas barata gana con HTML estático, una opción de renderizado o un navegador alojado con apps cargadas de JavaScript, un endpoint de SERP o e-commerce para registros ya analizados, y una API orientada a Markdown para pipelines de LLM. Preselecciona dos o tres proveedores y compara el coste por página útil con tus URL: los multiplicadores de créditos y el cobro de fallos deciden el coste real.

Suciu Dan31 min read
Leer artículo
Reseña de webscraper.io: precios, límites y cuándo cambiar de servicio
Guías

Reseña de webscraper.io: precios, límites y cuándo cambiar de servicio

TL;DR: En resumen: Web Scraper de webscraper.io es una extensión gratuita para Chrome y Firefox, más el servicio de pago Web Scraper Cloud, y es una buena opción para tareas recurrentes pequeñas y medianas en sitios públicos corrientes. Quédate con él cuando unas pocas personas actualizan un puñado de sitios a diario o cada semana y alguien mantiene los selectores. Cambia cuando necesites muchos sitios, objetivos protegidos o con mucho JavaScript, o control a nivel de código.

Suciu Dan20 min read
Leer artículo
Cookies HTTP: guía para desarrolladores sobre cómo extraer datos de sesiones
Guías

Cookies HTTP: guía para desarrolladores sobre cómo extraer datos de sesiones

TL;DR: Comprende cómo los «cookie jars», las políticas del navegador y la propiedad de la sesión afectan a las respuestas extraídas. Aprende a diagnosticar los errores de autenticación sin revelar las credenciales.

Gabriel Cioci15 min read
Leer artículo
Aplicaciones para la extracción de datos: compara cuatro flujos de trabajo reales
Guías

Aplicaciones para la extracción de datos: compara cuatro flujos de trabajo reales

TL;DR: Compara Octoparse, ParseHub, Web Scraper y Apify en cuanto a la configuración de proyectos, la ejecución, las exportaciones y el mantenimiento, mediante una prueba piloto que evalúe el flujo de trabajo completo de entrega.

Mihnea-Octavian Manolache16 min read
Leer artículo
Extracción automática de datos de la web: crea tareas que puedas recuperar
Guías

Extracción automática de datos de la web: crea tareas que puedas recuperar

TL;DR: Crea colectores programados con identidades de ejecución explícitas, reintentos limitados, validación y entrega a prueba de repetición. Descubre cómo recuperar los fallos sin ocultar los datos que faltan.

Andrei Ogiolan17 min read
Leer artículo
Alternativas a Scrapebox: cinco herramientas para distintas tareas
Guías

Alternativas a Scrapebox: cinco herramientas para distintas tareas

TL;DR: Encuentra la alternativa adecuada para las auditorías de sitios web, el rastreo personalizado, las interacciones con el navegador, la extracción visual o la limpieza de conjuntos de datos, y luego comprueba que el cambio funciona mediante una prueba piloto.

Raluca Penciuc15 min read
Leer artículo
Herramientas de extracción de contenido: elige en función de la fidelidad del texto
Guías

Herramientas de extracción de contenido: elige en función de la fidelidad del texto

TL;DR: Elige un extractor para artículos con diferentes diseños o reglas de plantilla específicas y, a continuación, comprueba la fidelidad del texto, los metadatos, la estructura y la gestión de errores en tu propio corpus.

Robert Munceanu16 min read
Leer artículo
Alternativas a Puppeteer: Las mejores herramientas para scraping y testing 2026
Guías

Alternativas a Puppeteer: Las mejores herramientas para scraping y testing 2026

TL;DR: Puppeteer es genial para la automatización rápida de Chromium, pero su bloqueo en un solo navegador, el escalado de recursos pesados y el nulo soporte anti-bot integrado empujan a muchos equipos hacia alternativas. Esta guía desglosa las alternativas más fuertes de Puppeteer por caso de uso (raspado, pruebas E2E, control de calidad entre navegadores, móvil), le da una tabla de comparación lado a lado, y termina con un marco de decisión para que pueda elegir la herramienta adecuada sin ensayo y error.

Suciu Dan18 min read
Leer artículo
Extracción de datos de sitios web: un flujo de trabajo práctico con el DOM
Guías

Extracción de datos de sitios web: un flujo de trabajo práctico con el DOM

TL;DR: Crea un recopilador de navegadores con un indicador de preparación explícito, registros validados y condiciones de finalización fiables. Descubre cuándo es preferible la extracción del DOM a las capturas de pantalla y al OCR.

Raluca Penciuc14 min read
Leer artículo
Alternativa a Charles Proxy: selección por tarea de depuración
Guías

Alternativa a Charles Proxy: selección por tarea de depuración

TL;DR: Compara mitmproxy, Fiddler Everywhere, HTTP Toolkit y Proxyman en función de las tareas de depuración. Realiza una prueba controlada para verificar la captura de datos, el intercambio de pruebas y la limpieza de certificados.

Robert Sfichi16 min read
Leer artículo
Alternativa a import.io: elige según el flujo de trabajo de datos
Guías

Alternativa a import.io: elige según el flujo de trabajo de datos

TL;DR: Compara Octoparse, Browse AI, Apify y Scrapy en función de quién se encargue de la extracción y las necesidades de entrega. Crea un proyecto piloto que compruebe la exhaustividad, la actualidad y la preparación para la migración.

Ștefan Răcilă16 min read
Leer artículo
Site Scraper: Crea un recopilador que puedas validar
Guías

Site Scraper: Crea un recopilador que puedas validar

TL;DR: Diseña un recopilador de sitios web, desde la definición de los registros hasta la entrega verificada. Delimita el alcance de las fuentes, elige un modelo de ejecución, valida las observaciones y recupera las ejecuciones incompletas.

Mihnea-Octavian Manolache16 min read
Leer artículo
Alternativas a PhantomJS: qué utilizar ahora y cómo realizar la migración
Guías

Alternativas a PhantomJS: qué utilizar ahora y cómo realizar la migración

TL;DR: PhantomJS dejó de desarrollarse en 2018. Elige un sustituto en función de lo que hiciera tu script, asigna las llamadas a PhantomJS a Playwright o Puppeteer y elimina las dependencias antiguas.

Sorin-Gabriel Marica21 min read
Leer artículo
8 alternativas a Scrapy para 2026: elige en función de los cuellos de botella, el coste y el riesgo
Guías

8 alternativas a Scrapy para 2026: elige en función de los cuellos de botella, el coste y el riesgo

TL;DR: En resumen: La elección adecuada depende de si el cuello de botella de Scrapy es el renderizado, el bloqueo, la compatibilidad con el lenguaje o las operaciones. Mantén o amplía los rastreadores que funcionen bien siempre que sea posible; utiliza herramientas de navegador para páginas interactivas, plataformas alojadas para operaciones, pilas ligeras para tareas estáticas delimitadas y API gestionadas cuando la infraestructura de solicitudes sea la limitación. Valida la lista de opciones preseleccionadas con un modelo de costes y una prueba de concepto representativa.

Mihai Maxim22 min read
Leer artículo
Alternativa al web scraper: adapta primero el flujo de trabajo
Guías

Alternativa al web scraper: adapta primero el flujo de trabajo

TL;DR: Compara Octoparse, Browse AI, Apify y Playwright según su modelo de creación. Mantén la navegación, registra la identidad y el comportamiento de entrega al sustituir Web Scraper.

Suciu Dan15 min read
Leer artículo
Alternativa a WebHarvy: compara flujos de trabajo de datos de productos
Guías

Alternativa a WebHarvy: compara flujos de trabajo de datos de productos

TL;DR: Compara Octoparse, ParseHub, Web Scraper y Apify para la extracción de datos de productos. Comprueba las variantes, las ofertas, los artículos que faltan y las exportaciones antes de sustituir a WebHarvy.

Suciu Dan16 min read
Leer artículo
Alternativa a Niche Scraper: elige mejores fuentes de información para tus investigaciones
Guías

Alternativa a Niche Scraper: elige mejores fuentes de información para tus investigaciones

TL;DR: Compara las distintas opciones de investigación de productos en función de la tarea, la procedencia de los datos y las necesidades de entrega. Diseña una prueba reproducible sin confundir la demanda estimada con las ventas verificadas.

Mihnea-Octavian Manolache15 min read
Leer artículo
Las mejores alternativas a Wget: Comparación de herramientas modernas de descarga CLI
Guías

Las mejores alternativas a Wget: Comparación de herramientas modernas de descarga CLI

TL;DR: Wget es fiable pero anticuado. Si necesitas descargas paralelas, usa aria2. Para una amplia cobertura de protocolos y scripts, curl es la mejor opción. ¿Quieres un flujo de trabajo de pruebas de API más amigable? HTTPie (o su hermano Rust xh) encaja perfectamente. Y si quieres la ruta de actualización más cercana, wget2 añade HTTP/2, multihilo y un sistema de plugins, manteniendo los mismos patrones de comandos que ya conoces.

Anda Miuțescu12 min read
Leer artículo
Comparativa de 5 alternativas a node-fetch: Native Fetch, Axios, Got, Ky y SuperAgent
Guías

Comparativa de 5 alternativas a node-fetch: Native Fetch, Axios, Got, Ky y SuperAgent

TL;DR: En resumen: Empieza con el `Fetch` nativo en las versiones compatibles de Node.js y añade una dependencia solo cuando sustituya a código personalizado relevante. Axios prioriza la comodidad en distintos entornos de ejecución; Got ofrece un control más profundo específico para Node; Ky mejora la ergonomía de `Fetch`; y SuperAgent se adapta a flujos de trabajo fluidos con formularios y archivos. Elijas lo que elijas, conserva el comportamiento de status, timeout, retry, cookie y stream durante la migración.

Raluca Penciuc18 min read
Leer artículo
Cómo el web scraping en R hace que la ciencia de datos sea divertida
Guías

Cómo el web scraping en R hace que la ciencia de datos sea divertida

TL;DR: Descubre cómo empezar tu próximo proyecto utilizando el web scraping con R y rvest.

Raluca Penciuc9 min read
Leer artículo
Profit Scraper: Comprobar la disponibilidad y sustituir el flujo de trabajo
Guías

Profit Scraper: Comprobar la disponibilidad y sustituir el flujo de trabajo

TL;DR: Comprueba la identidad actual del servicio antes de seguir las recomendaciones antiguas de Profit Scraper. Crea un flujo de trabajo alternativo para los datos de los anuncios, el análisis de los precios de venta y las hipótesis de costes transparentes.

Mihai Maxim15 min read
Leer artículo
La guía definitiva para iniciarse en el web scraping con Elixir
Guías

La guía definitiva para iniciarse en el web scraping con Elixir

TL;DR: Esta es la guía completa para el web scraping con Elixir. Descubre cómo crear un rastreador web utilizando uno de los mejores lenguajes de programación para la concurrencia.

Robert Sfichi8 min read
Leer artículo
Guía para principiantes sobre el web scraping con Rust
Guías

Guía para principiantes sobre el web scraping con Rust

TL;DR: Rust es un lenguaje rápido y eficiente en cuanto al uso de la memoria. Pero, ¿cómo se desenvuelve con el web scraping? Echa un vistazo a esta guía para principiantes y descubre cómo puedes utilizarlo para crear un scraper web básico.

Mihai Maxim7 min read
Leer artículo
Web scraping con Go: cómo crear un rastreador HTML fiable
Guías

Web scraping con Go: cómo crear un rastreador HTML fiable

TL;DR: Crea un scraper en Go que extraiga registros de libros en formato JSON. Sigue un ejemplo probado con goquery y, a continuación, planifica la paginación, el uso de Colly, la visualización en el navegador y la gestión de errores.

Sorin-Gabriel Marica15 min read
Leer artículo
Alternativa a Octoparse: compara las herramientas que ya tienes
Guías

Alternativa a Octoparse: compara las herramientas que ya tienes

TL;DR: Compara Web Scraper, Browse AI, Apify y Scrapy en función del trabajo conservado. Realiza una prueba controlada de reparabilidad y verifica que la entrega sea completa antes de sustituir Octoparse.

Gabriel Cioci16 min read
Leer artículo
Extracción de datos web en C# con HttpClient, AngleSharp y Playwright
Guías

Extracción de datos web en C# con HttpClient, AngleSharp y Playwright

TL;DR: En resumen: Para hacer web scraping en C#, empieza en .NET 10 con el HttpClient integrado para descargar páginas y AngleSharp para analizar HTML con selectores CSS. Elige HtmlAgilityPack si prefieres XPath o mantienes código antiguo, y añade Playwright para .NET cuando JavaScript construye la página. Esta guía crea un scraper con reintentos respetuosos, rastreo acotado, exportación a CSV y JSON y pruebas sin conexión.

Sorin-Gabriel Marica30 min read
Leer artículo
Los mejores raspadores web Node.js en 2026: 6 bibliotecas comparadas
Guías

Los mejores raspadores web Node.js en 2026: 6 bibliotecas comparadas

TL;DR: Los mejores raspadores web Node.js en 2026 se dividen en dos campos: clientes HTTP como Axios y Superagent para páginas estáticas, y navegadores sin cabeza como Puppeteer y Playwright para sitios con mucho JavaScript. Elija por flujo de trabajo, no por popularidad, y descargue la renderización a una API de scraping gestionada una vez que las defensas anti-bot o la escala empiecen a consumir su tiempo de ingeniería.

Suciu Dan12 min read
Leer artículo
Alternativa a ProxyScrape: elige el sustituto adecuado
Guías

Alternativa a ProxyScrape: elige el sustituto adecuado

TL;DR: Compara las redes de proxy y la obtención gestionada en función del comportamiento de las sesiones, la procedencia de los datos y el coste por registro aceptado. Recurre a una prueba controlada y a un plan de migración reversible.

Ștefan Răcilă15 min read
Leer artículo
Comparativa de 7 alternativas a Axios para navegadores, Node.js y scraping
Guías

Comparativa de 7 alternativas a Axios para navegadores, Node.js y scraping

TL;DR: En resumen: utiliza Fetch nativo para una solución básica con pocas dependencias; Ky, para la facilidad de uso de Fetch; Got o SuperAgent, para un comportamiento del cliente más completo; y Alova cuando el estado de la solicitud del frontend sea el requisito fundamental. Elige Puppeteer o una API de scraping gestionada solo cuando la representación, la interacción, los proxies o los sistemas antibots hagan que el transporte HTTP habitual resulte insuficiente.

Raluca Penciuc17 min read
Leer artículo
Cómo extraer datos de las páginas de eBay para obtener información sobre precios
Guías

Cómo extraer datos de las páginas de eBay para obtener información sobre precios

TL;DR: En el caso de los productos nuevos, resulta difícil fijar el precio adecuado. Pues bien, hay una solución: recopilar datos de los gigantes del comercio electrónico y fijar los precios basándose en datos claros.

Gabriel Cioci5 min read
Leer artículo
Cómo hacer Web Scrape con Puppeteer y NodeJS Guía 2026
Guías

Cómo hacer Web Scrape con Puppeteer y NodeJS Guía 2026

TL;DR: Puppeteer le da el control total de una instancia de Chrome sin cabeza de Node.js, por lo que es la herramienta go-to para el raspado de páginas con JavaScript. Esta guía le guía a través de la instalación, la extracción basada en selectores, el desplazamiento infinito, el inicio de sesión de formulario, la interceptación de solicitudes, los plugins ocultos, la exportación de datos estructurados y la implementación de Docker, para que pueda pasar de un script de juguete a un raspador de producción.

Gabriel Cioci19 min read
Leer artículo
Tutorial de BeautifulSoup: Construir un raspador real de Python desde cero
Guías

Tutorial de BeautifulSoup: Construir un raspador real de Python desde cero

TL;DR: Este tutorial de BeautifulSoup te guía a través de un scraper Python completo, desde la instalación pip hasta un script reforzado que pagina Hacker News, exporta a CSV y JSON, y se mantiene lo suficientemente educado como para no ser bloqueado. Cada fragmento es ejecutable, y señalamos los momentos exactos en los que BeautifulSoup es la herramienta equivocada.

Sorin-Gabriel Marica19 min read
Leer artículo
Web scraping en Java: cómo crear un scraper fiable en Java
Guías

Web scraping en Java: cómo crear un scraper fiable en Java

TL;DR: En resumen: Empieza con HttpClient y Jsoup cuando los datos estén presentes en el HTML devuelto; recurre a una fuente JSON expuesta cuando sea necesario; y añade renderizado o Selenium únicamente para los estados que dependan del navegador. Este tutorial de Java sobre web scraping amplía un código base de Java 21 con paginación, concurrencia limitada, reintentos, sesiones, validación y salida duradera.

Raluca Penciuc32 min read
Leer artículo
Web Scraping con Selenium: Tutorial paso a paso en Python
Guías

Web Scraping con Selenium: Tutorial paso a paso en Python

TL;DR: Selenium te permite scrapear sitios web con mucho JavaScript manejando un navegador real desde código Python. Este tutorial te guía a través de cada fase: instalación de Selenium, configuración de Chrome, localización e interacción con elementos, manejo de esperas y paginación, exportación de datos limpios y escalado de tu scraper con proxies, Selenium Grid y alternativas basadas en API.

Robert Sfichi33 min read
Leer artículo
Extracción de datos de la web en C y C++ con libcurl y lexbor
Guías

Extracción de datos de la web en C y C++ con libcurl y lexbor

TL;DR: Extrae datos de páginas web en C y C++ con libcurl y lexbor: crea un rastreador C++20 «educado» con CMake y vcpkg, exporta archivos CSV y JSON limpios, gestiona páginas con JavaScript de tres formas diferentes y ejecuta el mismo rastreador en C puro.

Raluca Penciuc29 min read
Leer artículo
Extracción de datos de mapas de sitio: descubre URL con límites seguros
Guías

Extracción de datos de mapas de sitio: descubre URL con límites seguros

TL;DR: Convierte los índices del mapa del sitio en una cola de descubrimiento de URL rastreables. Aprende a analizar el contenido teniendo en cuenta los espacios de nombres, los límites de los protocolos, las advertencias sobre la actualidad de la información y los límites de seguridad para las URL no fiables.

Robert Munceanu16 min read
Leer artículo
Cómo utilizar WebScrapingAPI: Guía de la API de scraping y de Web MCP
Guías

Cómo utilizar WebScrapingAPI: Guía de la API de scraping y de Web MCP

TL;DR: Envía tu primera solicitud a la API de WebScrapingAPI utilizando la clave en una variable de entorno y, a continuación, añade la representación en JavaScript, la geolocalización, las reglas de extracción y las tareas asíncronas solo cuando el objetivo lo requiera. La guía abarca todos los códigos de error documentados, el seguimiento de costes por llamada, los planes a partir de octubre de 2026, cuándo optar por la API de navegador, la de SERP, la de rastreo o la de datos, y cómo conectar agentes de IA a través de Web MCP.

Robert Munceanu28 min read
Leer artículo
Web scraping con Python en 2026: la guía práctica para desarrolladores
Guías

Web scraping con Python en 2026: la guía práctica para desarrolladores

TL;DR: En resumen: Esta es una guía práctica sobre el scraping web con Python que comienza con un árbol de decisión y, a continuación, repasa Requests junto con Beautiful Soup, XPath con lxml, Playwright, Selenium, Scrapy y una API de scraping para objetivos difíciles. Al finalizar, dispondrás de código funcional, un manual para evitar bloqueos, patrones de almacenamiento preparados para modelos de lenguaje grande (LLM) y una lista de comprobación para la puesta en producción.

Raluca Penciuc35 min read
Leer artículo
Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.