
Saltar al contenido
Empezar gratis
Volver al blog

Cookies HTTP: guía para desarrolladores sobre cómo extraer datos de sesiones

Gabriel CiociÚltima actualización el 15 min read
Cookies HTTP: guía para desarrolladores sobre cómo extraer datos de sesiones
En resumen: Las cookies HTTP permiten al cliente conservar el estado entre solicitudes, pero una cookie almacenada no garantiza que la sesión esté autenticada. Utiliza un «cookie jar», mantén las cuentas aisladas, conoce las reglas específicas de cada navegador y valida la página devuelta antes de tratarla como datos extraídos.

Tu rastreador solicita una página de catálogo y recibe una respuesta positiva. El analizador no encuentra ningún producto. En un navegador, la misma URL funciona. Antes de cambiar los selectores, comprueba si la respuesta es en realidad una página de inicio de sesión, un selector de región o una pantalla de consentimiento.

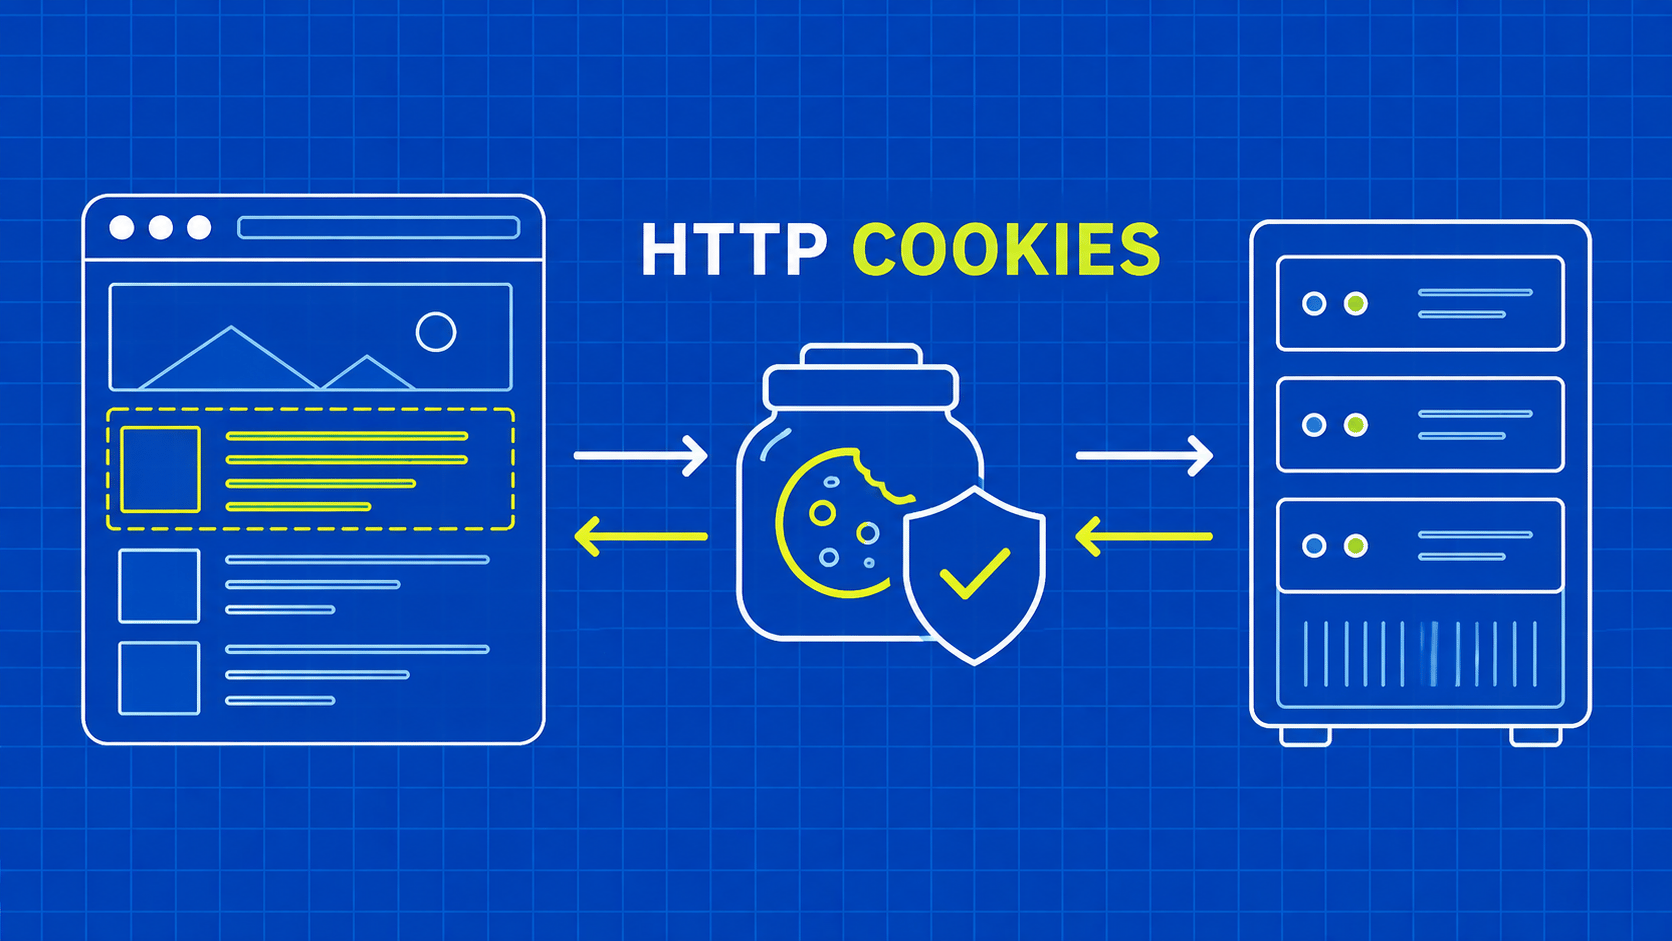
Las cookies HTTP son pequeños fragmentos de estado que un cliente almacena y puede enviar con las solicitudes posteriores. A menudo explican por qué unas URL idénticas devuelven contenido diferente. Una cookie puede identificar una sesión, recordar un idioma o contener una preferencia de la aplicación. El significado corresponde a la aplicación, no al protocolo de cookies en sí.

Para los desarrolladores que recopilan datos, la habilidad clave es gestionar ese estado de forma deliberada. Es necesario saber qué cliente ha recibido una cookie, adónde puede transmitirse, si el servidor sigue aceptándola y cómo diagnosticar fallos sin que las credenciales se filtren en los registros.

Esta guía sigue el recorrido de una cookie desde la respuesta hasta la solicitud, distingue entre un cliente HTTP y un navegador, y muestra un ejercicio local en Python que permite observar el comportamiento de la sesión. Se centra en tus propias aplicaciones y en las cuentas que estás autorizado a utilizar. Copiar la sesión de otra persona no es un atajo legítimo para acceder a los datos.
Sigue las cookies HTTP desde la respuesta hasta la solicitud

Un intercambio típico comienza con una respuesta del servidor que contiene Set-Cookie. El cliente procesa la cookie y sus atributos y, a continuación, decide si incluir el par nombre-valor en un Cookie encabezado de solicitud posterior. Se trata de encabezados distintos con funciones diferentes, no de cadenas intercambiables.

La especificación de las cookies HTTP define el mecanismo subyacente de gestión del estado. Es importante destacar que las cookies de solicitud no contienen todos los atributos que aparecían en la respuesta. Ver un nombre y un valor en el servidor no te indica la duración original de la cookie ni el contexto en el que se creó.

HTTP/1.1 200 OK
Set-Cookie: preference=compact; Path=/catalog; Secure; SameSite=Lax

GET /catalog/items HTTP/1.1
Host: shop.example
Cookie: preference=compact

Este intercambio ilustrativo omite los encabezados no relacionados. El segundo mensaje contiene el valor de preferencia, no Path, Secure, ni SameSite. Esos atributos ayudan al cliente a decidir si debe enviarlo. No son valores de preferencia adicionales que tu analizador deba recopilar.

Pueden llegar varias cookies en Set-Cookie campos. Evita tratar esos campos como una lista separada por comas: una fecha de caducidad puede contener en sí misma una coma. Utiliza la gestión de cookies de la biblioteca HTTP en lugar de escribir un separador de encabezados improvisado que solo funcione en tu primera respuesta de prueba.

Para una tarea de recopilación, piensa en términos de una secuencia en lugar de una sola solicitud. La página de destino podría establecer una región. Una respuesta posterior podría actualizar una sesión. Una redirección podría emitir otra cookie antes de que se cargue la página final. Guardar solo los encabezados visibles de la última respuesta puede ocultar el paso que cambió el estado.

Anota la secuencia esperada para tu integración. Por ejemplo: establecer la sesión permitida, confirmar la región seleccionada, solicitar la página de recopilación y comprobar el marcador específico de los datos. Este pequeño modelo facilita distinguir los fallos de los cambios en el HTML.

Interpreta los atributos de las cookies como reglas de enrutamiento y acceso

El ámbito de las cookies forma parte de la corrección. Una preferencia destinada a una ruta concreta no debería convertirse accidentalmente en una suposición global para todo el rastreador. Del mismo modo, pueden existir dos cookies con el mismo nombre en ámbitos diferentes. Agruparlas en un único diccionario puede hacer que se pierda información que puedas necesitar más adelante.

La referencia de Set-Cookie documenta los atributos y su comportamiento en el navegador. La siguiente tabla es una ayuda práctica para la lectura, no una implementación sustitutiva del algoritmo de selección del navegador.

Atributo

Pregunta que ayuda a responder

Implicaciones para el recopilador

Domain

¿Qué hosts están dentro del ámbito?

Conservar el ámbito del host al importar el estado

Path

¿Qué rutas de solicitud coinciden?

Es posible que una cookie de una sección no acompañe a otra

Secure

¿Se requiere transporte cifrado?

No rebajes una sesión de producción a HTTP

HttpOnly

¿Puede leerla el JavaScript de la página?

La ausencia de un valor en document.cookie no demuestra su ausencia

Expires / Max-Age

¿Cuándo debe dejar de conservarlo el cliente?

Comprueba la fecha de caducidad antes de culpar a los selectores

SameSite

¿Es admisible esta solicitud del navegador en el contexto de su sitio web?

Un flujo entre sitios difiere de una solicitud directa

Utiliza esta tabla como lista de comprobación para la depuración. Cuando una cookie sea visible en el almacenamiento pero no aparezca en la solicitud saliente, compara el destino y el contexto reales con su ámbito. No amplíes el dominio ni elimines atributos de seguridad solo para que la prueba se supere. Eso altera el experimento y puede provocar una fuga de credenciales.

Una distinción importante es la vida útil de la cookie almacenada frente a la vida útil de la sesión del lado del servidor. Una cookie puede seguir presente aunque su sesión haya sido revocada. Por el contrario, un navegador puede restaurar el estado de la sesión tras un reinicio. «La cookie existe» y «el usuario está autenticado» son observaciones distintas.

Distingue también el nombre de la cookie de la cuenta a la que representa. Un nombre como session no te proporciona información fiable sobre sus permisos o su propietario. Mantén esa asociación en la configuración controlada de tu trabajo y verifícala mediante una comprobación de identidad específica de la aplicación y no sensible, cuando sea posible.

Si se omite Domain crea una cookie exclusiva del servidor; si se establece, puede incluir subdominios. Para las solicitudes del navegador, SameSite=Strict excluye el uso entre sitios, mientras que Lax permite determinadas navegaciones de primer nivel mediante métodos seguros, no recuperaciones entre sitios habituales. SameSite=None requiere Secure, y las restricciones del navegador respecto a terceros pueden seguir impidiendo la transmisión. HttpOnly impide que el JavaScript de la página lea el valor, pero las solicitudes elegibles iniciadas por JavaScript aún pueden transportar la cookie. Estas distinciones son la razón por la que inspeccionar document.cookie por sí sola sea una prueba incompleta.

Para disponer de un método de depuración práctico, anota tanto la página iniciadora como la URL solicitada. La afirmación «la solicitud se dirige al mismo punto final» omite el contexto que podría explicar el comportamiento diferente de los navegadores. Prueba por separado la navegación directa y las solicitudes incrustadas cuando ambas formen parte de tu flujo de trabajo permitido, y documenta qué caso debe reproducir el recopilador.

Elige entre un cliente HTTP y un navegador real

Un cliente HTTP envía solicitudes y procesa respuestas. Un navegador, además, ejecuta scripts y mantiene el contexto de la página en el que se producen las solicitudes. Esa diferencia explica por qué exportar cookies HTTP desde un navegador no es una forma universal de reproducir una sesión de navegador.

Empieza con el cliente más básico que admita el flujo de trabajo aprobado. Si un punto final documentado o una página renderizada por el servidor proporciona los datos necesarios, una sesión HTTP persistente suele ser suficiente. Si la aplicación requiere navegación o interacción mediante scripts, un navegador puede ser la capa de recopilación adecuada. Nuestra guía del cliente HTTP en Python te ayuda a tomar esa decisión.

Comportamiento

Cliente de sesión HTTP

Contexto del navegador

Conservar las cookies entre solicitudes

Normalmente proporcionado por un almacén de cookies

Se gestiona como estado del navegador

Ejecutar el JavaScript de la página

No por sí solo

Sí

Mantiene el almacenamiento local

No de forma automática

Disponible dentro del origen

Aplicar la política de navegación del navegador

No es equivalente a un navegador

Depende de la implementación y la configuración del navegador

Reproduce la interacción de la aplicación

Secuencia de solicitudes explícita

Navegación, clics, formularios y ejecución de scripts

No se debe deducir un comportamiento de seguridad idéntico a partir de una biblioteca que acepte los mismos atributos de cookies. Un «cookie jar» de uso general no es un motor de privacidad de navegador. En concreto, no proporciona el mismo contexto de sitio de nivel superior que se utiliza para interpretar las solicitudes del navegador. Prueba el cliente que realmente vas a implementar, en lugar de extrapolar conclusiones de un entorno de ejecución diferente.

El error contrario es añadir un navegador a cada tarea de recopilación sin identificar la capacidad que falta. La ejecución en el navegador introduce más estado y más elementos que diagnosticar. Anota por qué es necesario: un campo renderizado, una interacción o un flujo de autenticación gestionado por la aplicación. «Funcionaba en mi navegador» es una observación inicial, no una decisión de arquitectura.

Al utilizar la automatización, aísla los contextos por cuenta y tarea. El estado compartido del navegador puede cambiar silenciosamente la región, la organización seleccionada o el usuario detrás de solicitudes posteriores. Nuestra guía de automatización de Playwright proporciona un contexto más amplio para controlar una página interactiva.

Observa un «tarro de cookies» con un ejercicio local en Python

El siguiente ejemplo de la biblioteca estándar ejecuta un pequeño servidor local y un cliente en un mismo proceso. El servidor establece una cookie de demostración no confidencial. El cliente la conserva y la devuelve en la segunda solicitud. No interviene ningún sitio web externo, cuenta ni credencial.

La documentación de http.cookiejar de Python describe el «jar» y su integración con los gestores de solicitudes. En este caso, lo más útil es la retención automática: el ejemplo nunca crea manualmente un Cookie encabezado de solicitud.

from http.server import BaseHTTPRequestHandler, HTTPServer
from http.cookiejar import CookieJar
from threading import Thread
from urllib.request import build_opener, HTTPCookieProcessor

class Handler(BaseHTTPRequestHandler):
    def do_GET(self):
        self.send_response(200)
        if self.path == "/start":
            self.send_header("Set-Cookie", "demo=ready; Path=/")
        self.end_headers()
        value = self.headers.get("Cookie", "no cookie")
        self.wfile.write(value.encode("utf-8"))

    def log_message(self, *args):
        pass

server = HTTPServer(("127.0.0.1", 0), Handler)
thread = Thread(target=server.serve_forever, daemon=True)
thread.start()
client = build_opener(HTTPCookieProcessor(CookieJar()))
base = f"http://127.0.0.1:{server.server_port}"
try:
    with client.open(base + "/start", timeout=5) as response:
        response.read()
    with client.open(base + "/check", timeout=5) as response:
        result = response.read().decode("utf-8")
    assert result == "demo=ready"
    print("Cookie retained and returned")
finally:
    server.shutdown()
    server.server_close()
    thread.join()

El transporte HTTP local es intencionado para que la demostración sea autónoma. No se trata de un servidor de autenticación de producción y la cookie no es secreta. Para sesiones de producción, utiliza HTTPS y la configuración de seguridad documentada de la aplicación. No copies este controlador en un servicio público.

Amplía el ejercicio con un segundo cliente independiente. Este no debería heredar la cookie del primer cliente. Esa sencilla prueba pone de manifiesto una propiedad útil en producción: una nueva sesión comienza sin el estado de otra tarea. También puedes cambiar la ruta de la cookie y solicitar una ruta que no coincida para observar las decisiones de ámbito en este cliente concreto.

El ejemplo demuestra la retención de la cookie, no la autenticación. Una integración real necesita una comprobación de respuesta independiente para la cuenta o el tipo de página esperados. Mantén esa distinción en tus pruebas: las aserciones de estado de transporte explican el mecanismo, mientras que las aserciones de aplicación establecen si el contenido devuelto es adecuado para su extracción.

Mantén la propiedad de la sesión explícita entre los trabajadores

Un recopilador que procese varias cuentas necesita un propietario claro para cada conjunto de cookies. Asigna el estado por cuenta aprobada y contexto de recopilación. Evita una sesión global compartida por tareas no relacionadas, incluso si todas las solicitudes utilizan el mismo nombre de host.

En el caso de las integraciones con Python, la guía avanzada de Requests indica que una sesión conserva las cookies y reutiliza las conexiones. Esas comodidades no determinan tu política de aislamiento de cuentas. Diseña el ciclo de vida de la sesión en función de tu flujo de trabajo, en lugar de dejar que un objeto global de larga duración lo defina de forma accidental.

Imagina dos trabajadores que recopilan informes para diferentes organizaciones dentro del mismo servicio. Si comparten un estado de autenticación mutable, un inicio de sesión o un cambio de organización puede afectar al otro. El fallo podría consistir en datos válidos asignados al cliente equivocado, lo cual es más difícil de detectar que una excepción. Incluye la organización esperada en el contrato de validación, no solo los nombres de columna esperados.

Utiliza un único responsable lógico para actualizar una sesión. Si cada trabajador reacciona de forma independiente ante la caducidad, el grupo puede generar inicios de sesión redundantes o sobrescribir un estado más reciente con uno más antiguo. Un paso de actualización controlado puede pausar el trabajo dependiente, establecer un estado válido y reanudarse solo después de que se haya superado la comprobación de identidad.

Evita dar por sentada la seguridad de subprocesos cuando una biblioteca de cliente no la haya garantizado. A menudo es más fácil razonar sobre objetos de transporte independientes que sobre la mutación concurrente de un archivo JAR compartido. Si tu arquitectura distribuye el trabajo entre procesos, define cómo se transfiere el estado, cuánto tiempo permanece válido y qué componente está autorizado a sustituirlo.

Mantén el contexto ajeno a la autenticación junto con esa propiedad. Las preferencias de configuración regional y de moneda pueden alterar los valores extraídos sin cambiar la identidad de la cuenta. Un registro de tareas útil identifica la fuente, el ámbito de la cuenta esperado, la región y el identificador de generación de estado. No debe contener los propios valores secretos de las cookies.

Depura las sesiones fallidas sin exponer sus valores

Cuando un trabajo deje de extraer datos, clasifica primero la respuesta. Comprueba la URL final, el estado, el tipo de contenido, el marcador de página esperado y la secuencia de redireccionamientos. Una respuesta HTTP de éxito que contenga un formulario de inicio de sesión constituye un fallo de la aplicación para tu recopilador, aunque la solicitud de red se haya completado.

Registra la mínima información necesaria para identificar la etapa en la que se produce el fallo. Los nombres de las cookies, los dominios de ámbito, las rutas y las observaciones sobre la caducidad pueden ser suficientes. Oculta los valores en los volcados de solicitudes, los informes de excepciones, las capturas de pantalla y los rastros del navegador guardados. Un paquete de depuración no debe convertirse en un paquete de inicio de sesión portátil.

Síntoma

Primera comprobación

Evitar

La página de inicio de sesión se devolvió con el estado 200

URL final y marcador de página autenticada

Considerar el estado por sí solo como un éxito

Cookie almacenada pero no enviada

Host de destino, ruta, transporte, caducidad

Simplificación del archivo JAR y forzado de todos los valores

El navegador funciona, pero el script falla

Interacciones necesarias y otros tipos de almacenamiento

Suponiendo que las cookies abarcan toda la sesión

Configuración regional o datos de la cuenta incorrectos

Propietario de la sesión y contexto de la aplicación

Compartir un archivo JAR global

Errores repetidos de caducidad

Ciclo de vida de la actualización y rechazo del servidor

Un bucle de inicio de sesión sin fin

Mantén un pequeño caso de fallo redactado cuando esté permitido. Puede mostrar que un selector ahora coincide con un campo de inicio de sesión sin revelar la identidad ni el token del usuario. Prueba tu clasificador de respuestas con ese caso para que el mismo fallo no pueda volver a introducirse silenciosamente en el conjunto de datos.

Las cookies de sesión no son el único elemento sensible en la automatización del navegador. La documentación de autenticación de Playwright advierte de que el estado de autenticación guardado puede permitir la suplantación de identidad y no debe guardarse en repositorios. Trata el estado exportado como material de credenciales con acceso restringido y una política de eliminación definida.

En caso de escalación, informa de lo que ha cambiado en lugar de volcar toda la información: el identificador de la ejecución, la última comprobación de identidad satisfactoria, la categoría del fallo y las pruebas de respuesta censuradas. Esto permite al siguiente ingeniero llevar a cabo una investigación reproducible, al tiempo que se mantiene el acceso a la cuenta fuera del sistema de seguimiento de incidencias.

Puntos clave

  • Deja que un «cookie jar» gestione las cookies HTTP en lugar de copiar los encabezados sin procesar entre solicitudes.
  • Distingue entre el estado almacenado, la elegibilidad de la solicitud y la validez de la sesión del lado del servidor.
  • Elige un navegador solo cuando el flujo de trabajo requiera las capacidades de este.
  • Aísla el estado de la cuenta y de la región entre los trabajadores de recopilación.
  • Valida la identidad de la página y elimina los datos de autenticación antes de registrar los errores.

Preguntas frecuentes

¿Son las cookies programas ejecutables?

No. Una cookie es datos almacenados, no código ejecutable. Su valor puede seguir siendo sensible, y una aplicación puede comportarse de forma diferente al recibir ese valor. Evalúa lo que representa la cookie y por dónde transita, en lugar de tratar todas las cookies como preferencias inofensivas o archivos intrínsecamente maliciosos.

No. Eliminar el estado local no elimina los registros guardados previamente por tu recopilador u otro servicio. Esos conjuntos de datos necesitan sus propios controles de retención y eliminación. Mantén separadas la limpieza de sesiones y la gestión del ciclo de vida de los datos, para que un cierre de sesión correcto no se confunda con una prueba de que se han borrado los registros posteriores.

¿Puedo reproducir un precio personalizado guardando únicamente la URL?

No de forma fiable. Una URL puede omitir contexto que haya influido en la oferta mostrada, como la elegibilidad de la cuenta, la configuración regional o elecciones anteriores. Registra el contexto de observación no sensible necesario para la interpretación. No incluyas claves de autenticación en un conjunto de datos compartido simplemente para que sea reproducible; en su lugar, utiliza un proceso de reejecución controlado.

Conclusión

Una gestión fiable de las sesiones comienza con un pequeño conjunto de preguntas explícitas: ¿qué cliente es propietario de este estado?, ¿adónde puede desplazarse? y ¿qué demuestra que la respuesta pertenece al flujo de trabajo previsto? Las cookies HTTP ayudan a resolver parte de ese problema, pero no sustituyen a la validación de la aplicación.

Comienza con una prueba de retención local y, a continuación, prueba la secuencia permitida de inicio de sesión y recopilación de la integración real. Mantén un único propietario de la sesión, identifica la respuesta que esperas y gestiona la caducidad como una transición de estado delimitada. Cuando el comportamiento difiera del del navegador, investiga la capacidad que le falta al navegador en lugar de eliminar las protecciones de las cookies o copiar un perfil completo.

Si la recuperación de páginas supone una carga operativa adicional, evalúa la API Scraper de WebScrapingAPI para esa capa, manteniendo al mismo tiempo explícitas en tu aplicación la autorización de la cuenta y la titularidad de la sesión. Un servicio de recuperación no convierte una credencial en un permiso. El recopilador final debe hacer que su estado sea comprensible sin hacerlo público.

Acerca del autor

Gabriel Cioci, Desarrollador full-stack @ WebScrapingAPI

Gabriel Cioci

Desarrollador full-stack

Gabriel Cioci es desarrollador full stack en WebScrapingAPI, donde se encarga de crear y mantener los sitios web, el panel de usuario y los componentes principales de la plataforma destinados a los usuarios.

Extracción de datos web con AWS Lambda: guía para Python y Java 2026
Guías

Extracción de datos web con AWS Lambda: guía para Python y Java 2026

TL;DR: En resumen: el web scraping con AWS Lambda funciona mejor cuando cada invocación es breve, está delimitada y se puede reintentar de forma independiente. Empieza con HTTP directo, AWS SAM y S3, y añade SQS, contenedores, renderización en navegador, proxies o una capa de recuperación gestionada solo cuando la carga de trabajo demuestre que los necesita.

Suciu Dan33 min read
Leer artículo
Cómo utilizar GoSpider: rastrear, depurar URL y extraer datos
Guías

Cómo utilizar GoSpider: rastrear, depurar URL y extraer datos

TL;DR: En resumen: GoSpider es un rastreador de línea de comandos diseñado para descubrir URL, no un extractor completo de datos estructurados. Esta guía sobre cómo utilizar GoSpider muestra cómo realizar un rastreo limitado, gestionar correctamente los resultados, pasar los datos de Colly a CSV y seguir una ruta de diagnóstico para respuestas 403 o páginas que requieren renderización con JavaScript.

Suciu Dan24 min read
Leer artículo
Cómo raspar Redfin: Guía Python de Datos Inmobiliarios
Guías

Cómo raspar Redfin: Guía Python de Datos Inmobiliarios

TL;DR: Redfin expone puntos finales de API ocultos que devuelven JSON estructurado para los listados de propiedades, lo que permite omitir por completo el frágil análisis HTML. Esta guía te guía a través de la construcción de un raspador de Python que extrae datos de alquiler y venta, busca por ubicación, supervisa los nuevos listados a través de mapas de sitio XML y exporta resultados limpios a CSV o JSON.

Suciu Dan14 min read
Leer artículo

Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.