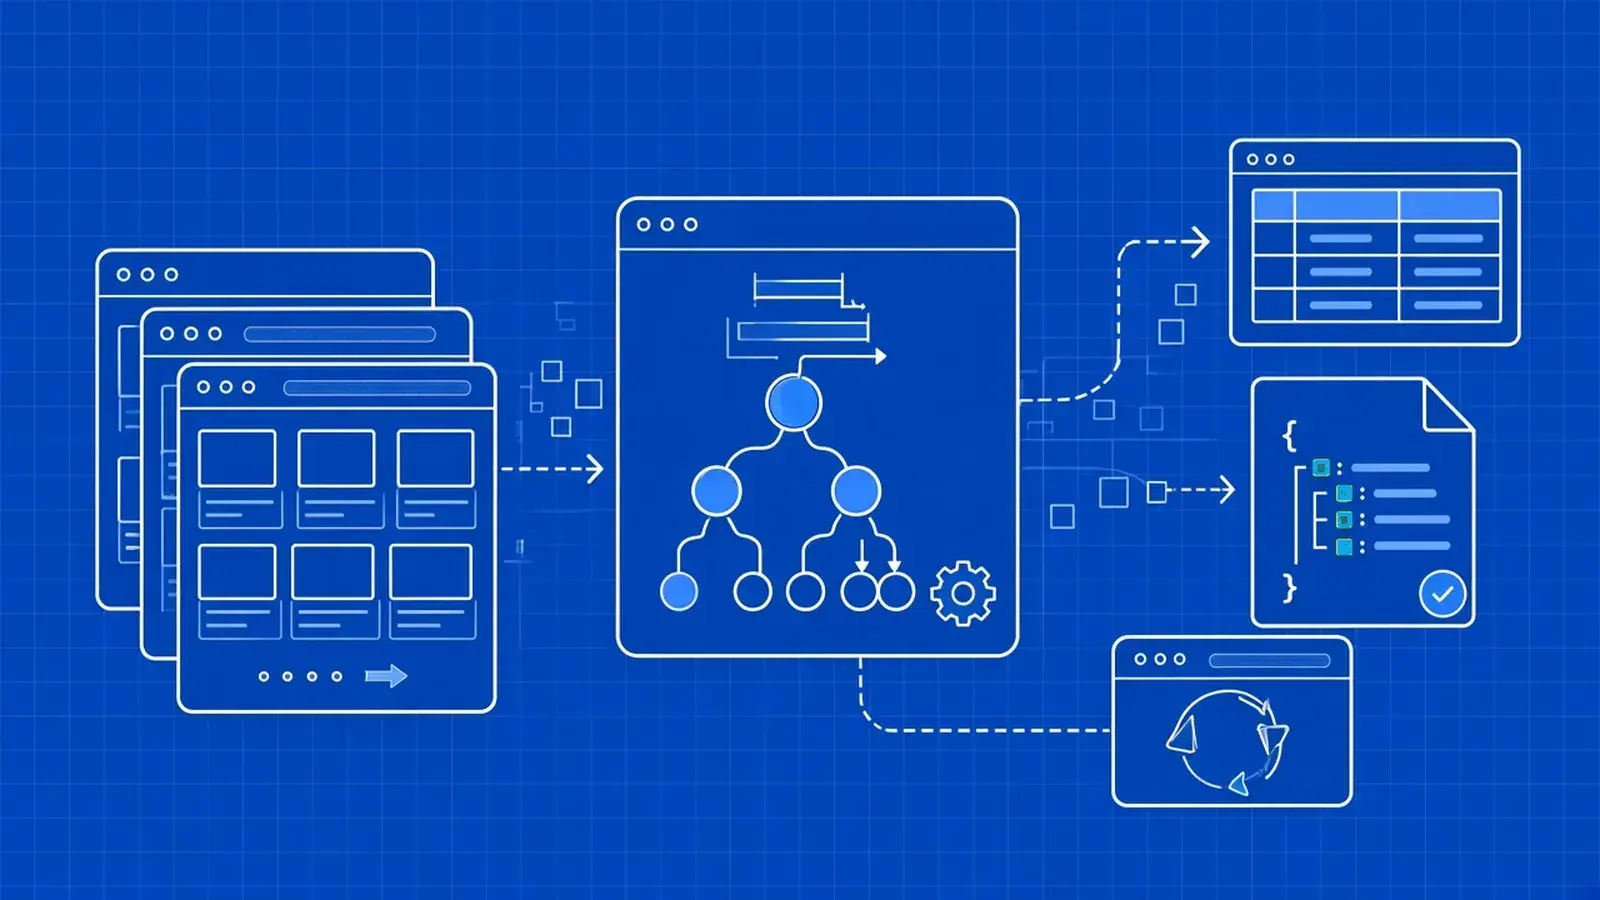
En resumen: Ruby realiza el rastreo web con Faraday para HTTP, Nokogiri para el análisis de CSS y XPath, y un pequeño grupo de subprocesos para la concurrencia. Esta guía explica cómo crear un rastreador que recopila un catálogo de ejercicios con 1.000 libros en formatos CSV y JSON, realiza reintentos de forma cortés, gestiona una página con JavaScript mediante Ferrum y llama a una API de rastreo desde el mismo código.
El rastreo web con Ruby requiere tres componentes: Faraday recupera la página, Nokogiri analiza el HTML con selectores CSS o XPath, y un grupo fijo de subprocesos recupera muchas páginas a la vez sin sobrecargar el sitio. Crearás un rastreador de principio a fin. Este recopila todos los libros de books.toscrape.com, un catálogo público de práctica, sigue la paginación, procesa las páginas de forma simultánea, reintenta correctamente las solicitudes con límite de frecuencia y escribe los resultados en formatos CSV y JSON. A continuación, gestionarás una página renderizada con JavaScript (quotes.toscrape.com/js/) de tres formas diferentes, iniciarás sesión en un formulario de práctica con Mechanize y llamarás a una API de scraping desde el mismo código de Faraday.
El código está pensado para Ruby 3.4 o posterior y las versiones de las gemas que se indican en la tabla siguiente.