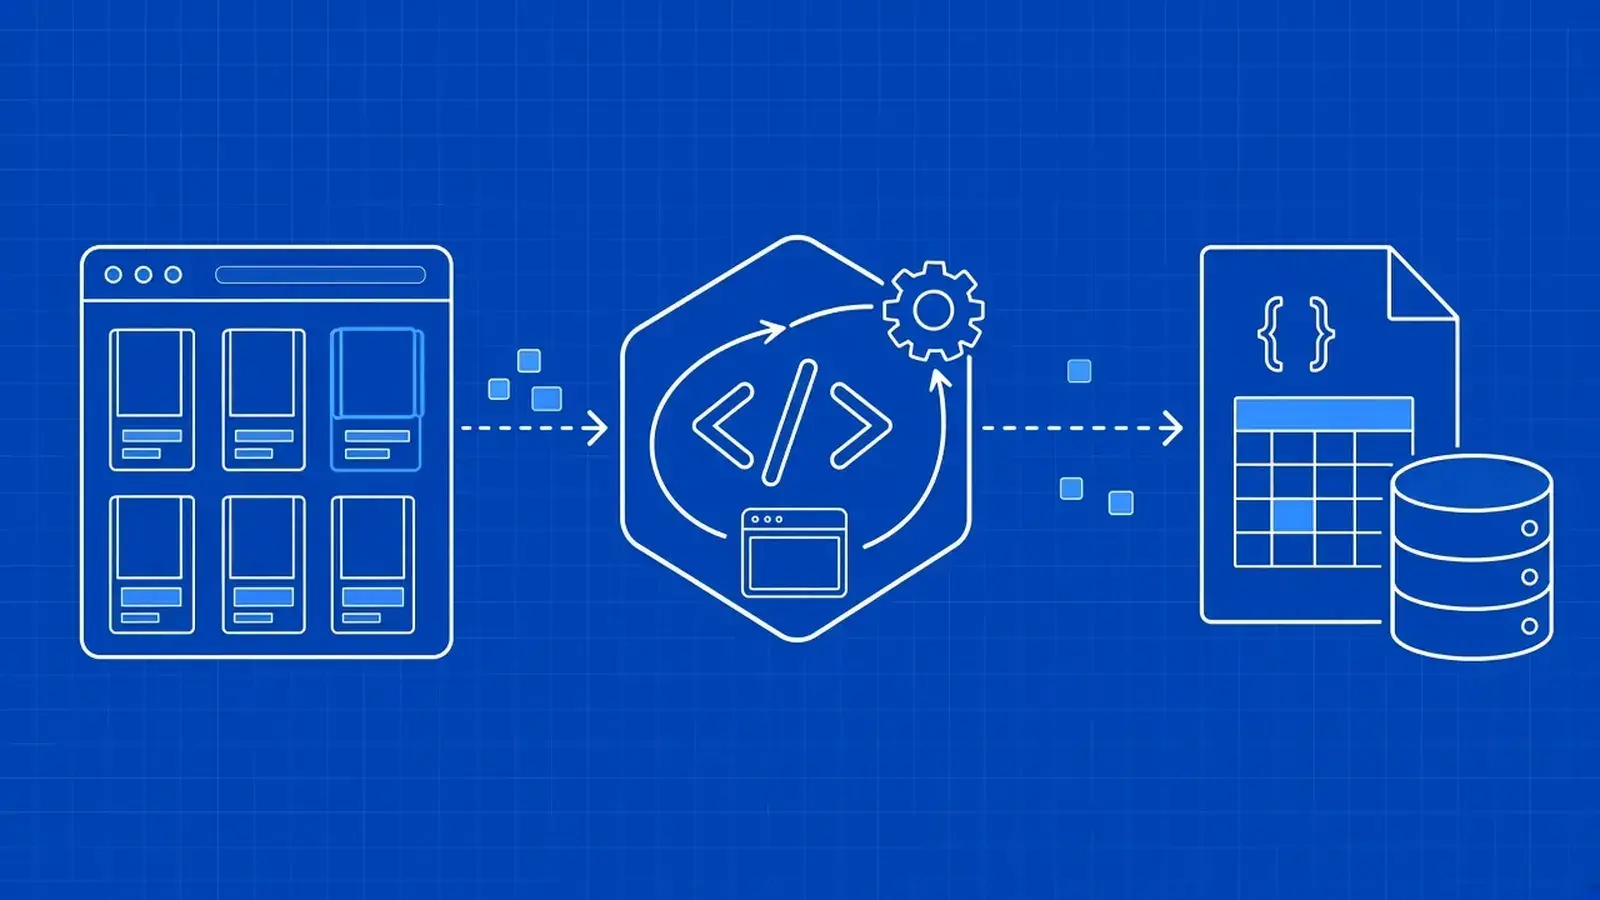
En resumen: El web scraping con JavaScript y Node.js requiere Node.js 22.12 o posterior, el fetch integrado para las solicitudes y Cheerio para analizar HTML. Usa Cheerio cuando los datos están en el HTML que recibe tu solicitud, y Playwright cuando JavaScript construye la página o esta necesita clics y esperas. Esta guía crea un único scraper, desde la paginación y el JSON oculto hasta las pruebas sin conexión y una API de scraping como alternativa.
El web scraping con JavaScript empieza con una tarea sencilla: los datos están en una página web, escribes código JavaScript y quieres obtener esos datos en formato JSON limpio, sin tener que lidiar con bloques ni matrices vacías. Si este concepto te resulta nuevo, lee primero qué es el web scraping.
Esta guía utiliza books.toscrape.com, una librería de prácticas creada para extractores de datos, como ejemplo práctico. Recogerás y analizarás una página con fetch y Cheerio, rastrearás un catálogo paginado de forma respetuosa, comprobarás si JavaScript genera una página, renderizarás y navegarás por las páginas con Playwright, probarás tu analizador sin conexión y transferirás las páginas bloqueadas a una API de extracción de datos sin modificar el analizador.
Inicio rápido
- Utiliza Node.js 22.12 o posterior (se recomienda la versión 24 o 26 LTS)
npm install cheeriopara páginas cuyos datos se encuentren en el HTMLnpm install playwrightpara páginas que requieran un navegador real- Comprueba el archivo robots.txt y las condiciones de uso del sitio antes de realizar el rastreo


