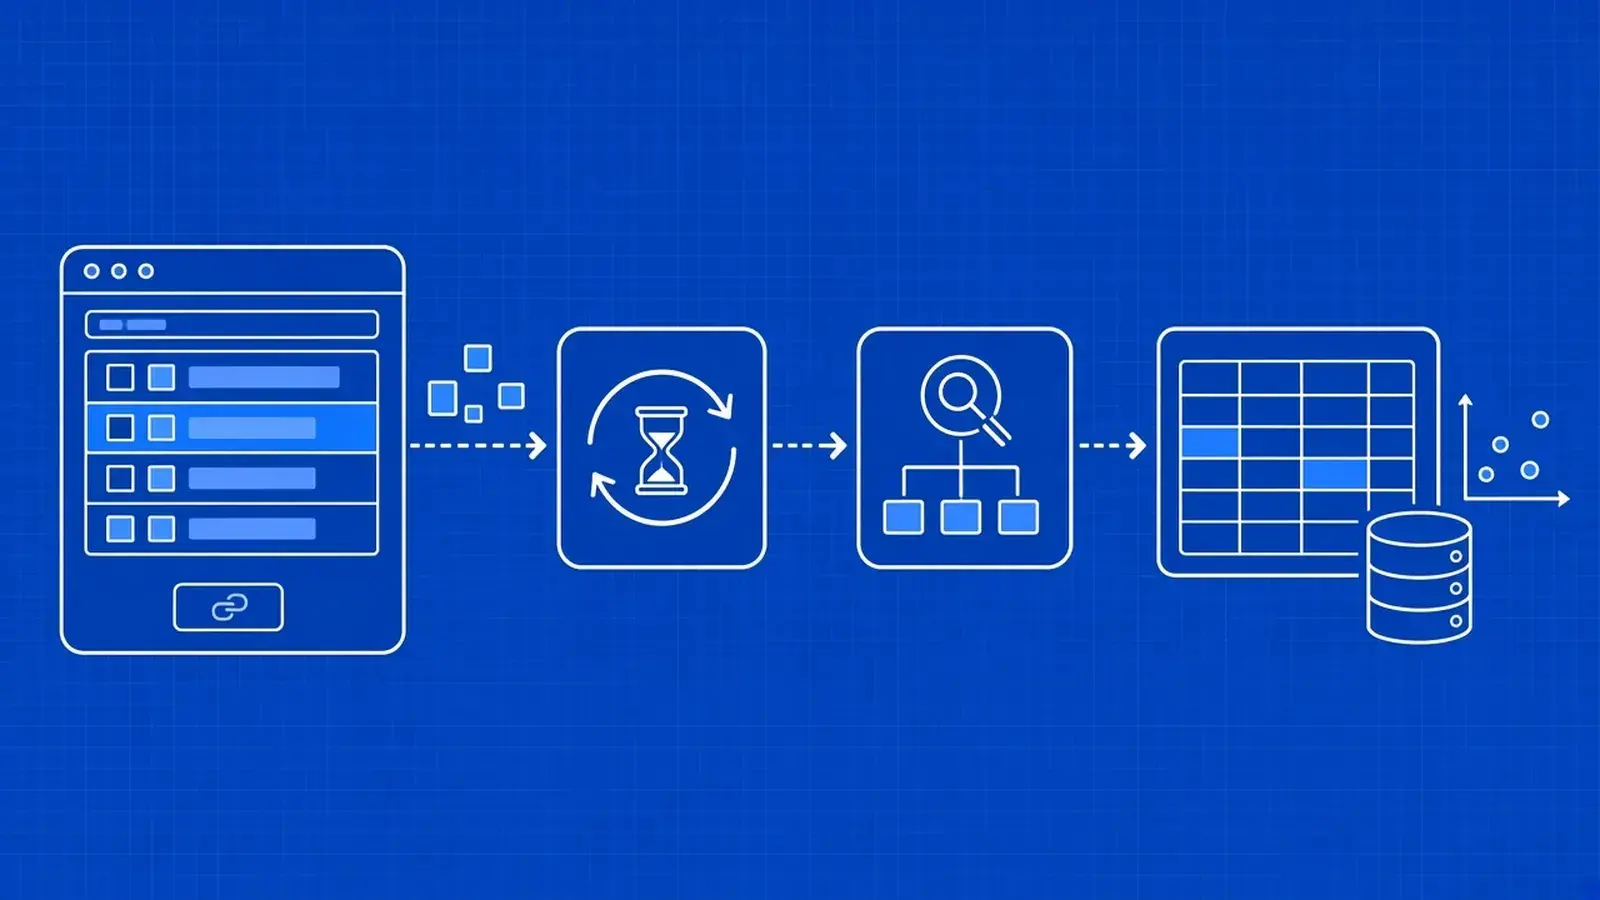
En resumen: para hacer web scraping en R, usa rvest para analizar HTML con selectores CSS o XPath y httr2 para descargar páginas con reintentos y límites de velocidad. rvest por sí solo basta para una página; en cuanto rastrees un sitio, descarga con httr2 y analiza con rvest, y recurre a read_html_live() cuando JavaScript construya la página. Esta guía cubre tablas, paginación, datos en etiquetas script, API de scraping y pruebas sin conexión.
Los datos que necesitas están en una página web y quieres tenerlos en un tibble sin salir de R. El web scraping en R te lleva hasta ahí con dos paquetes y el tidyverse que ya conoces. ¿Es la primera vez que oyes hablar del tema? Empieza por qué es el web scraping.
Esta guía usa Goodreads como ejemplo de principio a fin: la lista de lectores "Best Books Ever" y la página de 1984 de George Orwell. Vas a analizar una página y una tabla con rvest, rastrear con cortesía una lista paginada con httr2, extraer datos que construye JavaScript, pasar las páginas bloqueadas a una API de scraping sin cambiar tu parser, probar tu código sin conexión y resumir el resultado.
Inicio rápido
- Instala:
install.packages(c("rvest", "httr2")) - Carga con
read_html(), selecciona conhtml_elements(), extrae conhtml_text2()ohtml_attr() - Usa
read_html_live()para páginas que construye JavaScript - Usa R 4.1 o posterior para el pipe nativo
|>