Saltar al contenido
Empezar gratis
Volver al blog

Extracción de datos de las API: un primer proceso de extracción fiable

Gabriel CiociÚltima actualización el 14 min read
Extracción de datos de las API: un primer proceso de extracción fiable
En resumen: la extracción de datos de una API es un proceso que va desde las solicitudes documentadas hasta los registros validados. Empieza con un contrato de salida reducido, prueba la paginación y los casos de error de forma local; a continuación, añade un cliente real, puntos de control duraderos y un informe explícito que indique si la recopilación ha finalizado.

Una solicitud devuelve una lista de productos, tu script analiza el JSON y la terminal muestra una fila. Esa es una primera comprobación útil, pero extraer datos de las API implica mucho más que recibir una respuesta. Un extractor fiable debe decidir qué registros son válidos, cómo continuar y qué informar cuando solo llega una parte de la recopilación prevista.

Esta guía desarrolla esas decisiones en torno a un catálogo de productos ficticio. El ejercicio utiliza un entorno de prueba local en Python en lugar de un servicio de red, por lo que puedes probar la continuación, el manejo de duplicados y los registros rechazados sin necesidad de credenciales ni tráfico externo. Una vez que esas reglas funcionen, un cliente HTTP real puede suministrar páginas a través del mismo entorno.

El enfoque se centra en la implementación más que en la terminología. Si aún no estás familiarizado con los métodos, los encabezados y los estados de respuesta, la guía de API para principiantes explica esos conceptos básicos. Aquí, el resultado es un pequeño diseño de extracción con condiciones de éxito y fallo observables. Podrás determinar qué se aceptó, qué se rechazó y si se alcanzó la condición de finalización documentada por la fuente.
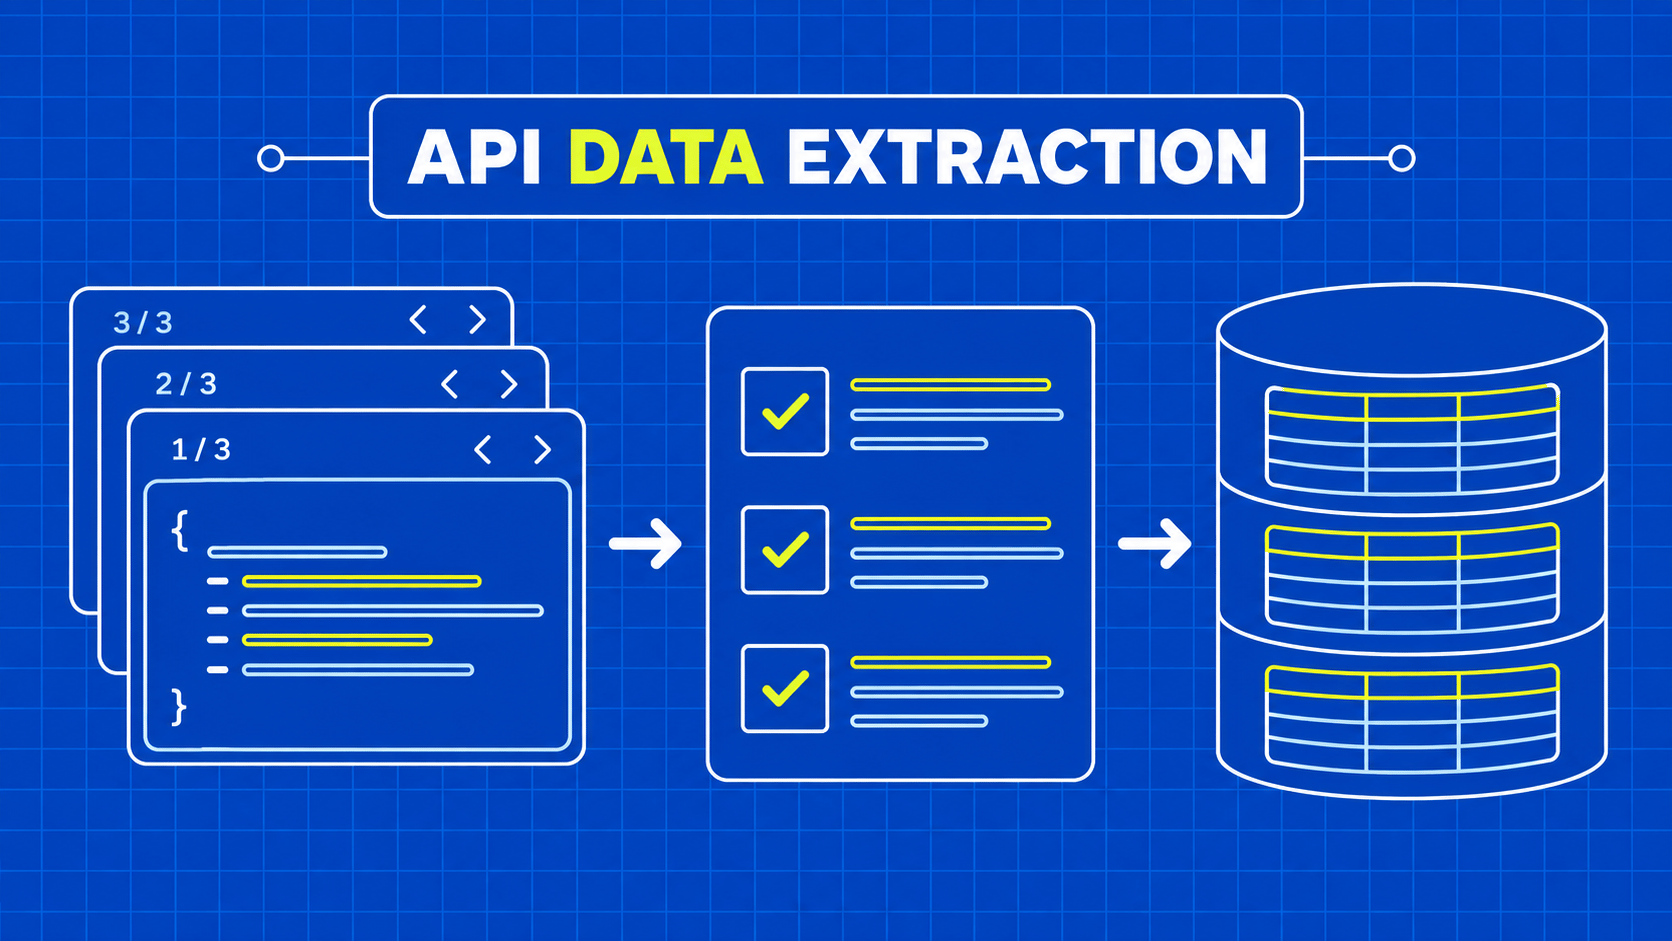
Planifica la extracción de datos de las API en torno a un contrato de salida

Anota la fila que pretendes entregar antes de crear un bucle. Para el catálogo ficticio, cada fila aceptada necesita un ID de producto estable, un nombre no vacío, un precio entero no negativo en céntimos y la moneda EUR. Se trata de reglas específicas del ejercicio, no de supuestos que se apliquen a todos los proveedores.

Separa el contrato de origen del esquema de destino. La fuente puede representar el dinero como texto decimal, un entero o un valor de visualización formateado. Conserva ese significado de forma explícita al realizar la correspondencia con el destino. Un campo llamado price no indica por sí solo su unidad, su tratamiento fiscal ni su moneda.

Decisión

Regla de ejemplo

No evitar

Identidad

Conservar el ID del producto de origen

Tratar la posición en la matriz como clave del producto

Texto obligatorio

El nombre debe contener texto que no sea un espacio en blanco

Publicar un campo en blanco como un registro completo

Significado numérico

Céntimos enteros según este contrato de instalación

Deducir la unidad a partir del valor

Política de duplicados

Conservar la primera aparición para este ejercicio

Mezcla silenciosa de observaciones contradictorias

Finalización

Detener en el cursor nulo documentado

Considerar completada una parada de presupuesto de página

Procedencia

Conservar el ámbito de la solicitud y la hora de recopilación

Pérdida del contexto que seleccionó estos registros

La política de duplicados merece una elección explícita. El ejercicio conserva la primera aparición válida porque su elemento de prueba repite un producto idéntico. Un catálogo real en constante cambio puede requerir, en su lugar, una comparación de marcas de tiempo o un registro de conflicto. La deduplicación debe implementar la política elegida, no ocultar las discrepancias entre observaciones.

Al extraer datos de las API, distingue un registro rechazado de una página fallida. Un elemento no válido puede ponerse en cuarentena, mientras que otros elementos siguen siendo utilizables según tu política. Una envoltura de página no reconocida puede impedir que confíes tanto en los elementos como en el valor de continuación, por lo que continuar a ciegas supondría un riesgo diferente.

Por último, define el alcance de la recopilación. Registra la cuenta, los filtros, el periodo y la versión del punto final cuando sea pertinente. Un registro preciso fuera de ese alcance sigue siendo un resultado erróneo para la tarea.

Separa la recuperación, la decodificación y la aceptación de registros

Utilice tres límites en la implementación. La recuperación obtiene una respuesta del proveedor. La decodificación interpreta la representación. La aceptación valida y mapea los registros de negocio. Cada límite debe devolver un resultado útil o un fallo clasificado, en lugar de sustituir silenciosamente un problema por una recopilación vacía.

La capa de recuperación gestiona la solicitud documentada, las credenciales, los tiempos de espera de transporte y el estado de la respuesta HTTP. Debe exponer pruebas suficientemente depuradas para diagnosticar un fallo. No hagas que el validador de registros se encargue de adivinar si una página de error HTML se debió a un tiempo de espera agotado o a un requisito de inicio de sesión.

La capa de decodificación comprueba el formato y la envoltura esperados. El análisis sintáctico de JSON establece que el texto sigue la sintaxis de JSON; no demuestra que el resultado sea una página de producto. La especificación JSON define los valores y la estructura, dejando el significado de los campos al contrato de la aplicación.

Para este ejercicio, una página tiene una items lista y un next valor que puede ser nulo o una cadena no vacía. Una envoltura inesperada supone un fallo de la página. A continuación, cada elemento se comprueba de forma independiente con respecto a las reglas del producto antes de llegar a la salida aceptada.

Estos límites facilitan las pruebas de extracción de datos de las API. Un fixture local puede sustituir la recuperación de datos, mientras que la lógica de decodificación y aceptación en producción sigue ejerciéndose. Puedes reproducir una fila mal formada o un cursor repetido sin depender de que un proveedor genere esa condición bajo demanda.

Al añadir un cliente real, limita sus responsabilidades. La comparación del cliente HTTP de Python resulta útil para evaluar los controles de solicitud, pero ninguna biblioteca de cliente puede deducir tu definición de un producto válido. Mantén esa definición en una función separada y revisable.

Evita también capturar todas las excepciones y devolver []. Ese patrón hace que una infraestructura no disponible resulte indistinguible de un catálogo vacío válido. Quien realiza la llamada debería poder distinguir si el proveedor no ha devuelto ningún registro coincidente o si el extractor no ha podido establecer un resultado válido.

Realiza un ejercicio local de paginación y validación

Guarda lo siguiente como extract_fixture.py y ejecútalo con Python 3. Solo utiliza la biblioteca estándar y no realiza solicitudes de red. Las páginas ficticias incluyen dos productos válidos, un precio no válido y un duplicado idéntico. Las aserciones finales también verifican que un cursor de continuación repetido falle de forma visible.

from copy import deepcopy

PAGES = {
    None: {"items": [
        {"id": "p1", "name": "Lamp", "price_minor": 2400,
         "currency": "EUR"},
        {"id": "bad", "name": "Chair", "price_minor": True,
         "currency": "EUR"},
    ], "next": "page-b"},
    "page-b": {"items": [
        {"id": "p1", "name": "Lamp", "price_minor": 2400,
         "currency": "EUR"},
        {"id": "p2", "name": "Book", "price_minor": 650,
         "currency": "EUR"},
    ], "next": None},
}

def valid_record(row):
    return (
        isinstance(row, dict)
        and isinstance(row.get("id"), str) and bool(row["id"].strip())
        and isinstance(row.get("name"), str) and bool(row["name"].strip())
        and type(row.get("price_minor")) is int
        and row["price_minor"] >= 0
        and row.get("currency") == "EUR"
    )

def collect(fetch_page, max_pages=5):
    cursor, visited, accepted = None, set(), {}
    rejected = duplicates = 0
    for _ in range(max_pages):
        if cursor in visited:
            raise ValueError("pagination cursor repeated")
        visited = visited | {cursor}
        page = fetch_page(cursor)
        if not isinstance(page, dict) or not isinstance(page.get("items"), list):
            raise ValueError("invalid page envelope")
        if "next" not in page or not (
            page["next"] is None
            or isinstance(page["next"], str) and bool(page["next"])
        ):
            raise ValueError("invalid continuation")
        for row in page["items"]:
            if not valid_record(row):
                rejected += 1
            elif row["id"] in accepted:
                duplicates += 1
            else:
                accepted = {**accepted, row["id"]: dict(row)}
        cursor = page["next"]
        if cursor is None:
            return list(accepted.values()), rejected, duplicates
    raise ValueError("page budget exhausted before completion")

rows, rejected, duplicates = collect(lambda cursor: deepcopy(PAGES[cursor]))
assert [row["id"] for row in rows] == ["p1", "p2"]
assert (rejected, duplicates) == (1, 1)
assert not valid_record({"id": "x", "name": "X",
                         "price_minor": True, "currency": "EUR"})
try:
    collect(lambda cursor: {"items": [], "next": "same"})
except ValueError as error:
    assert str(error) == "pagination cursor repeated"
else:
    raise AssertionError("repeated cursor was accepted")
print("2 accepted, 1 rejected, 1 duplicate; cycle check passed")

El transporte ficticio devuelve una copia, por lo que la extracción no modifica el fixture. El colector valida el contenedor antes de procesar las filas, realiza un seguimiento de los cursores por separado de las identidades de los productos y solo acepta registros que cumplan las reglas declaradas. Una página repetida y un producto repetido son observaciones diferentes.

Fíjate en la comprobación del tipo numérico. En Python, los booleanos son una subclase de los enteros, por lo que una comprobación amplia de instancias de entero aceptaría True como precio. Este fixture lo excluye deliberadamente mediante una comparación de tipos exacta. Otros lenguajes y herramientas de esquemas requieren una atención equivalente a la coerción y a los tipos aceptados.

El límite de páginas es un límite de protección, no una garantía de exhaustividad. Si expira antes de que aparezca la continuación nula, el ejercicio genera un error. Nunca devuelve un resultado final normal simplemente porque el bucle haya alcanzado su máximo configurado.

Se trata de un extractor didáctico, no de un sistema de almacenamiento de producción. Acumula los registros aceptados en memoria y genera un error ante un fallo de página, en lugar de conservar de forma duradera el progreso parcial. Antes de extraer datos de API a gran escala, sustituye esas limitaciones por un «sink» y un registro de ejecución que conserven el trabajo ya aceptado.

Las próximas pruebas locales deben reflejar tu contrato: una clave de continuación ausente, un campo que no sea de tipo lista items y duplicados conflictivos. Mantén explícitos los resultados esperados. El objetivo es probar las decisiones que la fuente real puede imponer, no añadir un gran conjunto de pruebas que se limite a repetir la implementación.

Haz explícitos la finalización de la paginación y los puntos de control

El ejercicio utiliza valores de cursor, pero los proveedores publican diferentes contratos de paginación. Algunos devuelven enlaces, otros utilizan desplazamientos y otros requieren números de página o tokens de continuación. La documentación de paginación de GitHub ilustra la continuación basada en enlaces para ese servicio; se trata de un ejemplo, no de un formato de API universal.

Conserva los valores de continuación opacos exactamente como indica el proveedor. Mantén los filtros relevantes y el contexto de la cuenta asociados al elemento de trabajo. Un token generado para el ámbito de una solicitud no debe tratarse como una instrucción independiente que se aplique a cualquier consulta posterior.

Valida la continuación basada en URL antes de seguirla. Un enlace «siguiente» proporcionado en la respuesta debe permanecer dentro de los destinos con los que tu integración está autorizada a contactar, y las redirecciones requieren las mismas comprobaciones de límites. No reenvíes una credencial a un servidor ajeno simplemente porque una respuesta incluyera esa URL.

Al extraer datos de las API hacia un almacenamiento duradero, confirma los datos aceptados antes de avanzar el punto de control. Si el punto de control avanza primero y el almacenamiento falla, un reinicio puede omitir registros. Si los datos se almacenan primero y la actualización del punto de control falla, el siguiente intento puede reproducir una página, lo cual puede gestionarse mediante una política de duplicados deliberada.

Una transacción atómica puede resultar útil cuando el destino y el punto de control comparten un sistema de almacenamiento. Si no es así, documenta cómo funcionan la reproducción y la conciliación. Evita afirmar que se trata de un procesamiento «exactamente una vez» simplemente porque la ruta normal almacena una fila por cada identificador de origen.

Registra el motivo de finalización. Una página final proporcionada por la fuente, un límite de páginas, un plazo y una respuesta rechazada son resultados distintos. Un informe que contenga únicamente el recuento de datos aceptados no puede explicar si el trabajo abarcó el alcance previsto.

Comprueba también las suposiciones del proveedor sobre los datos cambiantes. Una lista basada en desplazamientos puede moverse mientras la recorres, y un cursor puede caducar antes de un reinicio posterior. Registra la ventana de recogida y utiliza una instantánea documentada o un mecanismo incremental cuando la tarea requiera una consistencia mayor que la que ofrece un recorrido en tiempo real.

Gestiona los reintentos sin ocultar lagunas ni duplicados

Un reintento es otro intento de realizar una operación, no una corrección de sus entradas. Repetir una solicitud con credenciales no válidas o parámetros mal formados suele repetir el problema. Empieza por clasificar el fallo e identificar qué podría cambiar, si es que hay algo, antes de realizar otro intento.

En el caso de HTTP, la semántica de los métodos del RFC 9110 ayuda a distinguir la recuperación segura de aquellas operaciones cuya repetición puede tener repercusiones en el negocio. Incluso en el caso de las lecturas, limita el número de intentos y respeta el comportamiento documentado del proveedor. No actives una función de reintento general sin comprobar qué errores y operaciones repite.

Los límites de tasa requieren prestar atención a la carga agregada. Una 429 respuesta indica una condición de limitación; el ámbito de recuento lo define el servicio, y la respuesta puede incluir indicaciones sobre el retraso. La RFC 6585 define el estado. Varios trabajadores que compartan credenciales pueden consumir el mismo cupo.

Elige un responsable de los reintentos. Si el cliente, el intermediario y el ejecutor de tareas realizan reintentos de forma invisible, una sola solicitud prevista puede generar más tráfico del que registra el colector. Haz que el recuento de intentos y el tiempo transcurrido de la tarea sean lo suficientemente visibles como para investigar esa multiplicación.

Al extraer datos de las API, mantén un estado independiente para la recopilación parcial. Si se aceptaron tres páginas y la cuarta falló, conserva los datos aceptados de acuerdo con la política y registra el ámbito que falta. No crees un marcador de página final ni entregues un conjunto de datos «completo» sin matices.

Protege el propio informe de fallos. Almacena identificadores de solicitud depurados, categorías de respuesta y errores de esquema. Evita volcar credenciales, registros completos de cuentas o cuerpos sin restricciones en un registro general simplemente porque algo haya salido mal.

Por último, distingue entre la recuperación repetida y la entrega repetida. Si la exportación posterior falla tras una recopilación satisfactoria, volver a intentar la exportación a partir de los registros almacenados conserva la observación original. Volver a recuperar la fuente crea una ejecución diferente cuyos valores y exhaustividad pueden variar.

Entrega los registros con información de procedencia y comprobaciones de cambios

Una fila aceptada debe incluir suficiente contexto para explicar su procedencia. Dependiendo de la tarea, esto incluye la identidad de la fuente, la hora de recogida, el ámbito de la solicitud, la versión del punto final y la versión de la transformación. Mantén separada la hora de modificación de la fuente de la hora en que tu recopilador observó el registro.

Valida tanto los límites de la entrega como la respuesta de la fuente. Un entero correcto puede convertirse en texto en una exportación, un valor nulo puede convertirse en una celda vacía, o un consumidor puede interpretar una marca de tiempo en una zona horaria diferente. Define el esquema de salida y comprueba un archivo o mensaje representativo antes de publicar una ejecución completa.

Para extraer datos de las API de forma programada, añade un monitor de pequeños cambios. Compara el recuento de rechazos, la presencia de campos obligatorios y el comportamiento de finalización con las expectativas para esa fuente. Una caída repentina en los registros aceptados merece una investigación, pero no es automáticamente un error de extracción; los filtros de la fuente o el inventario pueden haber cambiado de forma legítima.

Mantén una configuración aprobada para el mantenimiento. Cuando un proveedor modifique un campo opcional, una prueba debería mostrar si tu mapeo lo ignora de forma segura o necesita una actualización. Cuando un campo obligatorio cambie de significado, revisa el contrato en lugar de añadir una solución alternativa genérica que genere una salida plausible.

La guía de extracción web automatizada vincula estos límites de aceptación y entrega con el ciclo de vida más amplio del trabajo. Se aplica la misma disciplina operativa tanto si los datos de entrada proceden de una API documentada como de una página web analizada.

Finaliza la primera implementación con un informe de ejecución que pueda utilizar otra persona: recuentos de elementos aceptados, rechazados, duplicados y páginas con error; el motivo del rechazo; y la ubicación del resultado validado. Ese informe convierte un script funcional en un proceso de recopilación cuyas limitaciones permanecen visibles.

Puntos clave

  • Define el significado de los campos, la identidad, la política de duplicados y la finalización antes de extraer datos de las API en un bucle.
  • Mantén separadas la recuperación, la decodificación y la validación empresarial para que los fallos de transporte no se conviertan en resultados de éxito vacíos.
  • Prueba localmente los cursores repetidos, las filas no válidas y los límites de páginas antes de conectar el extractor a un proveedor en producción.
  • Almacena los datos aceptados antes de avanzar un punto de control y haz que el comportamiento de reinicio sea compatible con la reproducción deliberada.
  • Conserve las pruebas de ejecuciones parciales y valide el formato de entrega final con el mismo cuidado que la respuesta de origen.

Preguntas frecuentes

¿Deben la recopilación y la transformación seguir el mismo calendario?

No necesariamente. La recogida de una observación de origen y la transformación de los datos almacenados son tareas diferentes. Separarlas puede permitirle corregir una asignación sin tener que realizar otra solicitud al origen. Decida cuánto tiempo deben conservarse las observaciones sin procesar y qué versiones de transformación necesitan los consumidores; a continuación, programe cada paso de acuerdo con esos requisitos.

¿Cómo debe gestionar un recopilador de API un nuevo campo opcional?

Sigue la política de compatibilidad que hayas elegido para la fuente. Un recopilador que ignore los campos opcionales desconocidos puede seguir funcionando sin cambios, mientras que uno que conserve un documento sin procesar completo puede retenerlos para su revisión posterior. No expongas automáticamente todos los campos nuevos a los consumidores posteriores sin comprobar su significado y las implicaciones de acceso.

¿Puede una exportación CSV conservar todos los valores de la API?

No sin una asignación explícita. El formato CSV no conserva de forma inherente objetos anidados, matrices o distinciones como «nulo» frente a «texto vacío». Aplanar o codificar esos valores de forma deliberada, documentar la convención y comprobar la interpretación del consumidor. Mantener una representación más rica de la fuente cuando el procesamiento posterior pueda necesitar información que la tabla omita.

Conclusión

Empieza a extraer datos de las API con un contrato reducido y un bucle que tenga en cuenta los fallos. El ejercicio local ilustra las decisiones clave: acepta solo registros definidos, trata los productos duplicados por separado de los cursores repetidos y exige una condición de finalización real. Un cliente HTTP real añade consideraciones de transporte sin sustituir esas reglas.

Antes de programar la tarea, asigna a los datos aceptados un destino duradero, garantiza que el punto de control se pueda reproducir de forma segura y genera un informe que distinga entre ejecuciones completas y parciales. Esos controles te permiten ampliar el alcance sin que resulte más difícil detectar los datos que faltan.

Si algunos campos obligatorios solo están disponibles a través de páginas web, evalúa la API Scraper de WebScrapingAPI como fuente de entrada adicional. Mantén el mismo contrato de aceptación, procedencia y entrega en torno a esos datos, de modo que el proceso se mantenga coherente incluso cuando los métodos de recopilación difieran.

Acerca del autor

Gabriel Cioci, Desarrollador full-stack @ WebScrapingAPI

Gabriel Cioci

Desarrollador full-stack

Gabriel Cioci es desarrollador full stack en WebScrapingAPI, donde se encarga de crear y mantener los sitios web, el panel de usuario y los componentes principales de la plataforma destinados a los usuarios.

Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.