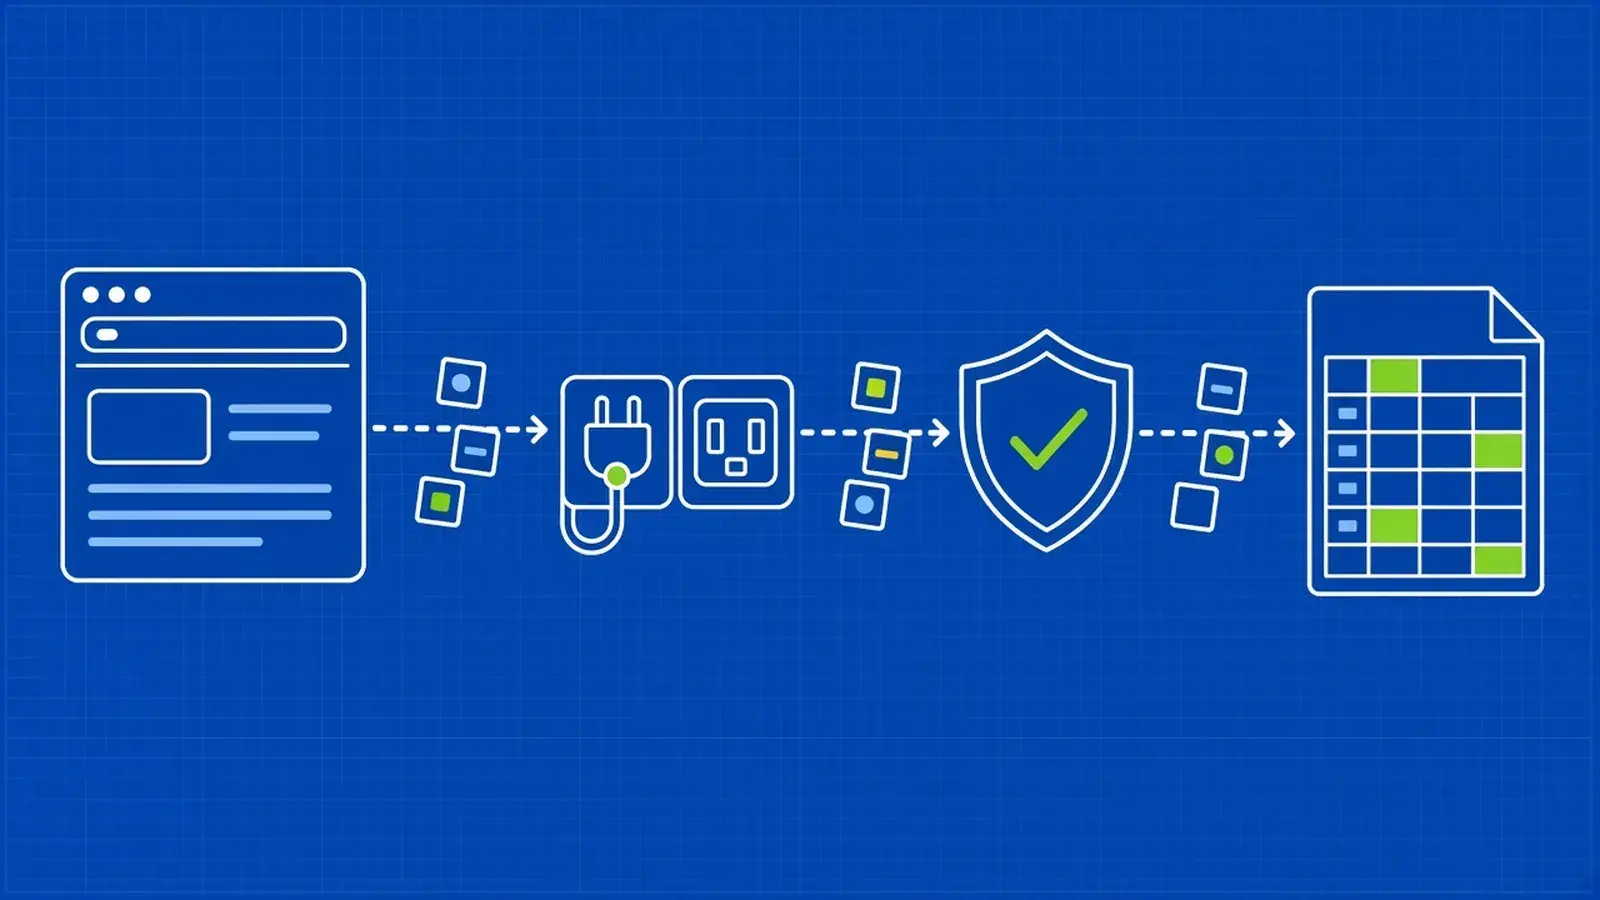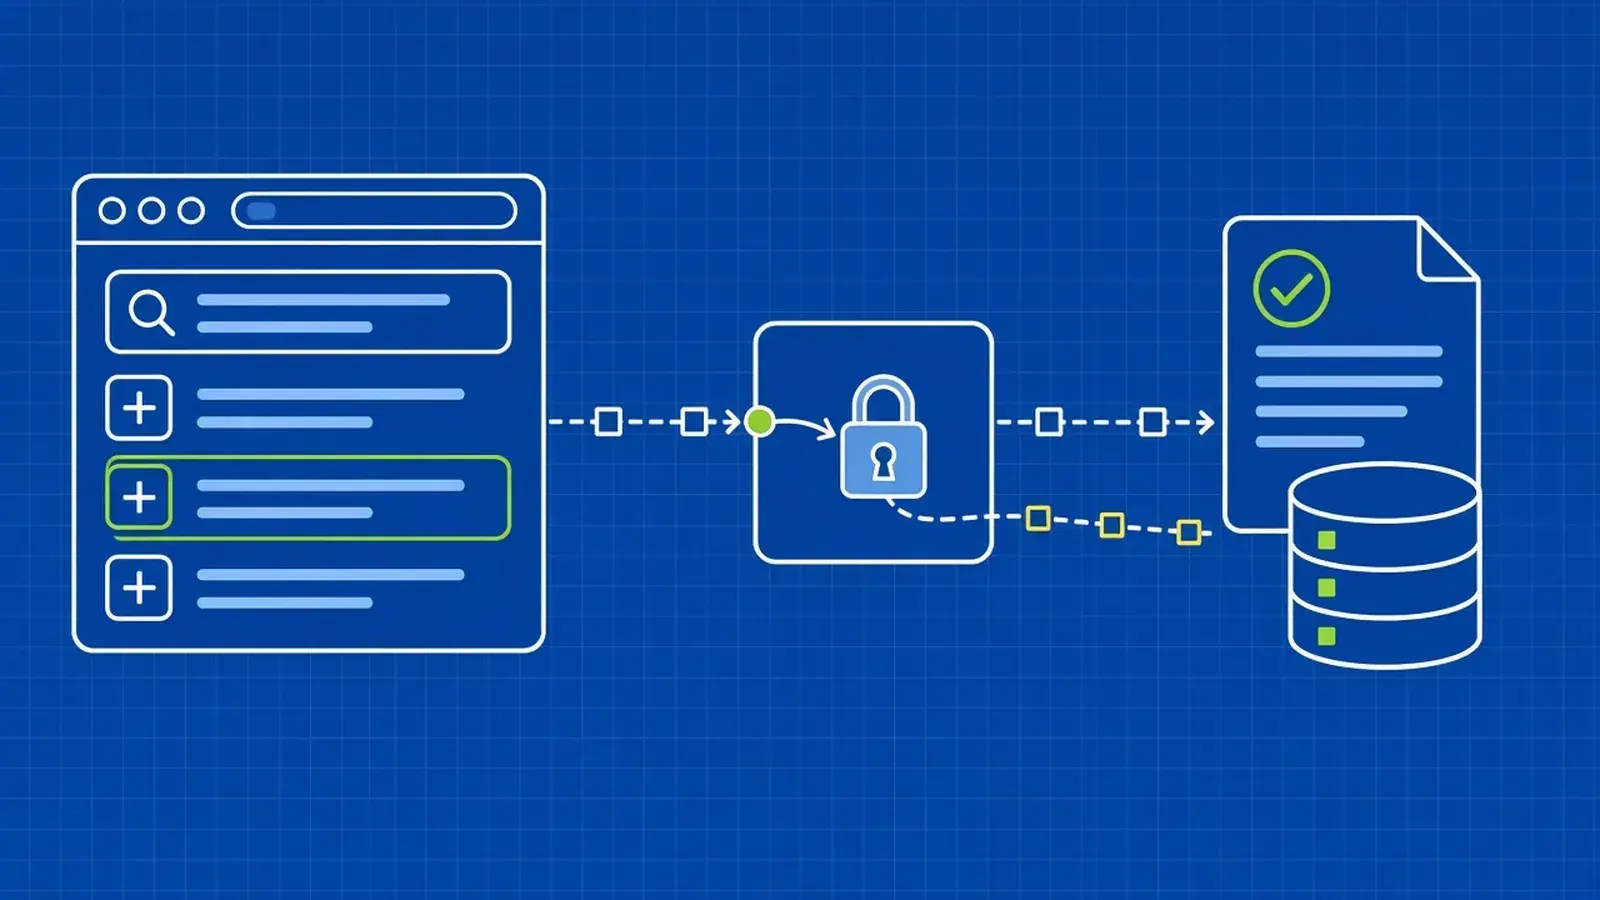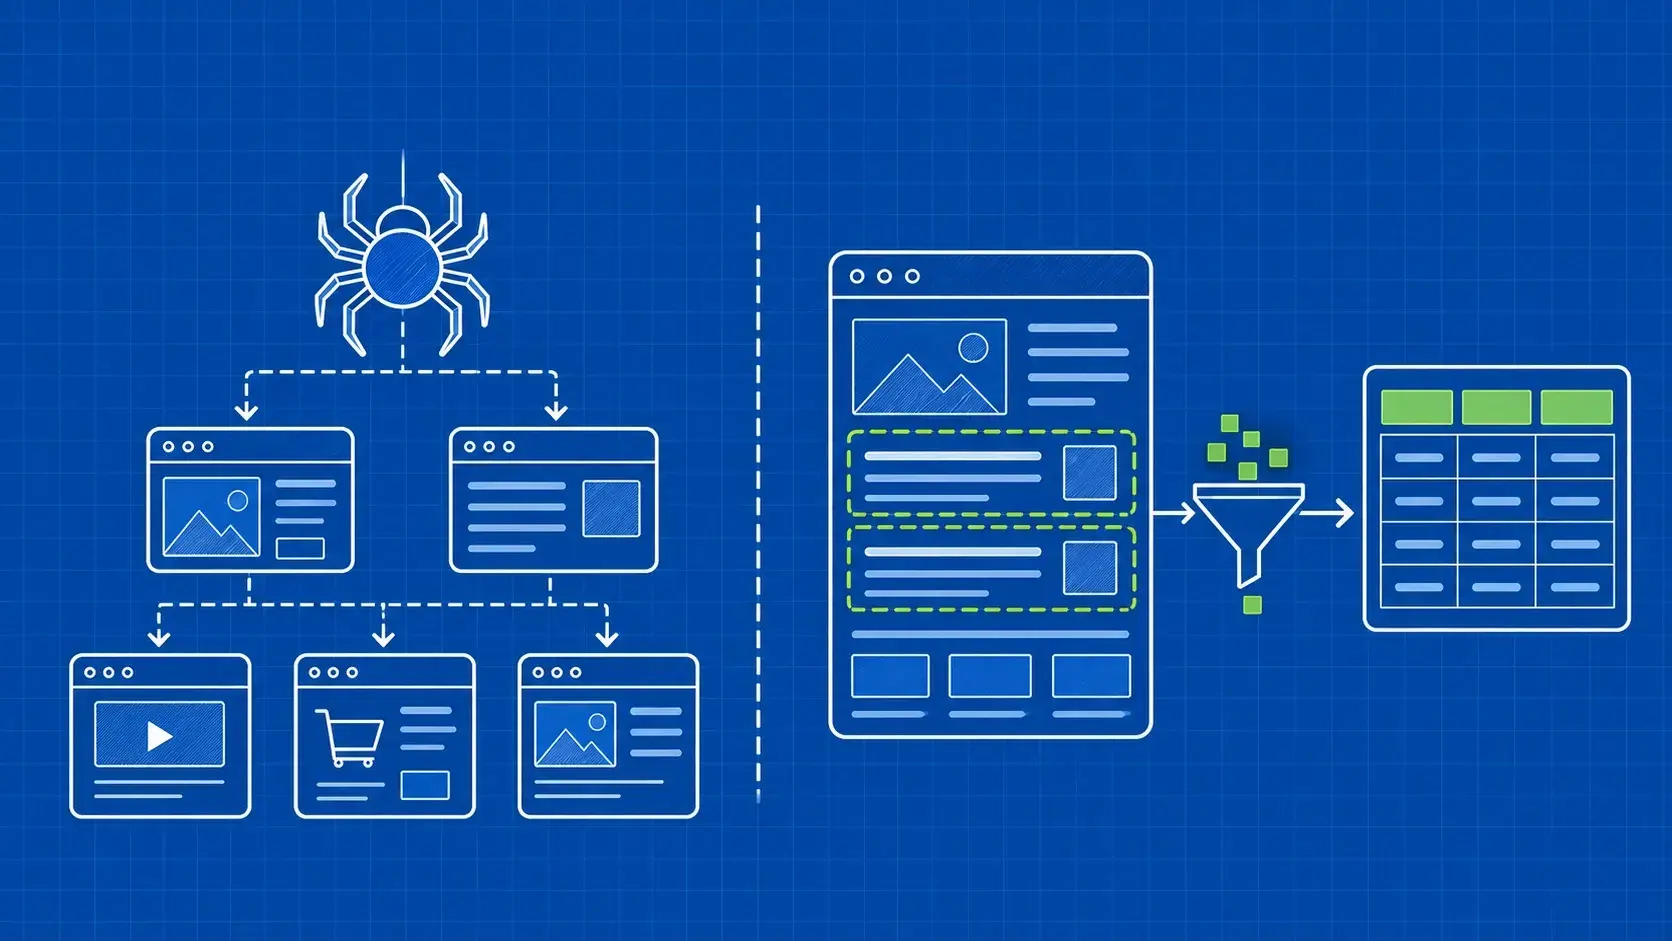
En resumen: el rastreo web descubre y visita páginas relevantes; el scraping web extrae información útil de su contenido. Si ya dispones de las URL, puedes empezar directamente con la extracción. Si necesitas encontrar páginas y recopilar sus datos, combina ambas tareas y comprueba los resultados por separado.
La diferencia entre el «web scraping» y el «web crawling» radica en extraer información de páginas web o descubrir qué páginas visitar. El «scraping» se utiliza para recopilar datos como títulos y precios de libros; el «crawling», para encontrar las páginas que los contienen.
Imagina que necesitas una hoja de cálculo con los libros de programación que vende una tienda online. La página de categorías te ofrece un punto de partida, pero puede enlazar a varias páginas de resultados. Encontrar las direcciones de los libros es una tarea. Leer el autor y el precio correctos en cada página de libro es otra.
Conocer la diferencia te ayuda a evitar dos resultados frustrantes: una larga lista de enlaces sin datos útiles, o datos precisos de unas pocas páginas mientras que el resto del catálogo pasa desapercibido. También te ayuda a comprender qué hace realmente una herramienta cuando se describe a sí misma como un «scraper», un «crawler», una «araña» o un servicio de extracción de datos.
Esta guía compara los resultados, explica el funcionamiento y sigue el proceso de una librería ficticia, desde el descubrimiento hasta la obtención de registros validados. Así dispondrás de una forma práctica de elegir un flujo de trabajo y probarlo en un pequeño lote antes de ampliarlo.