
Saltar al contenido
Empezar gratis
Volver al blog

Web scraping con Go: cómo crear un rastreador HTML fiable

Sorin-Gabriel MaricaÚltima actualización el 15 min read
Web scraping con Go: cómo crear un rastreador HTML fiable
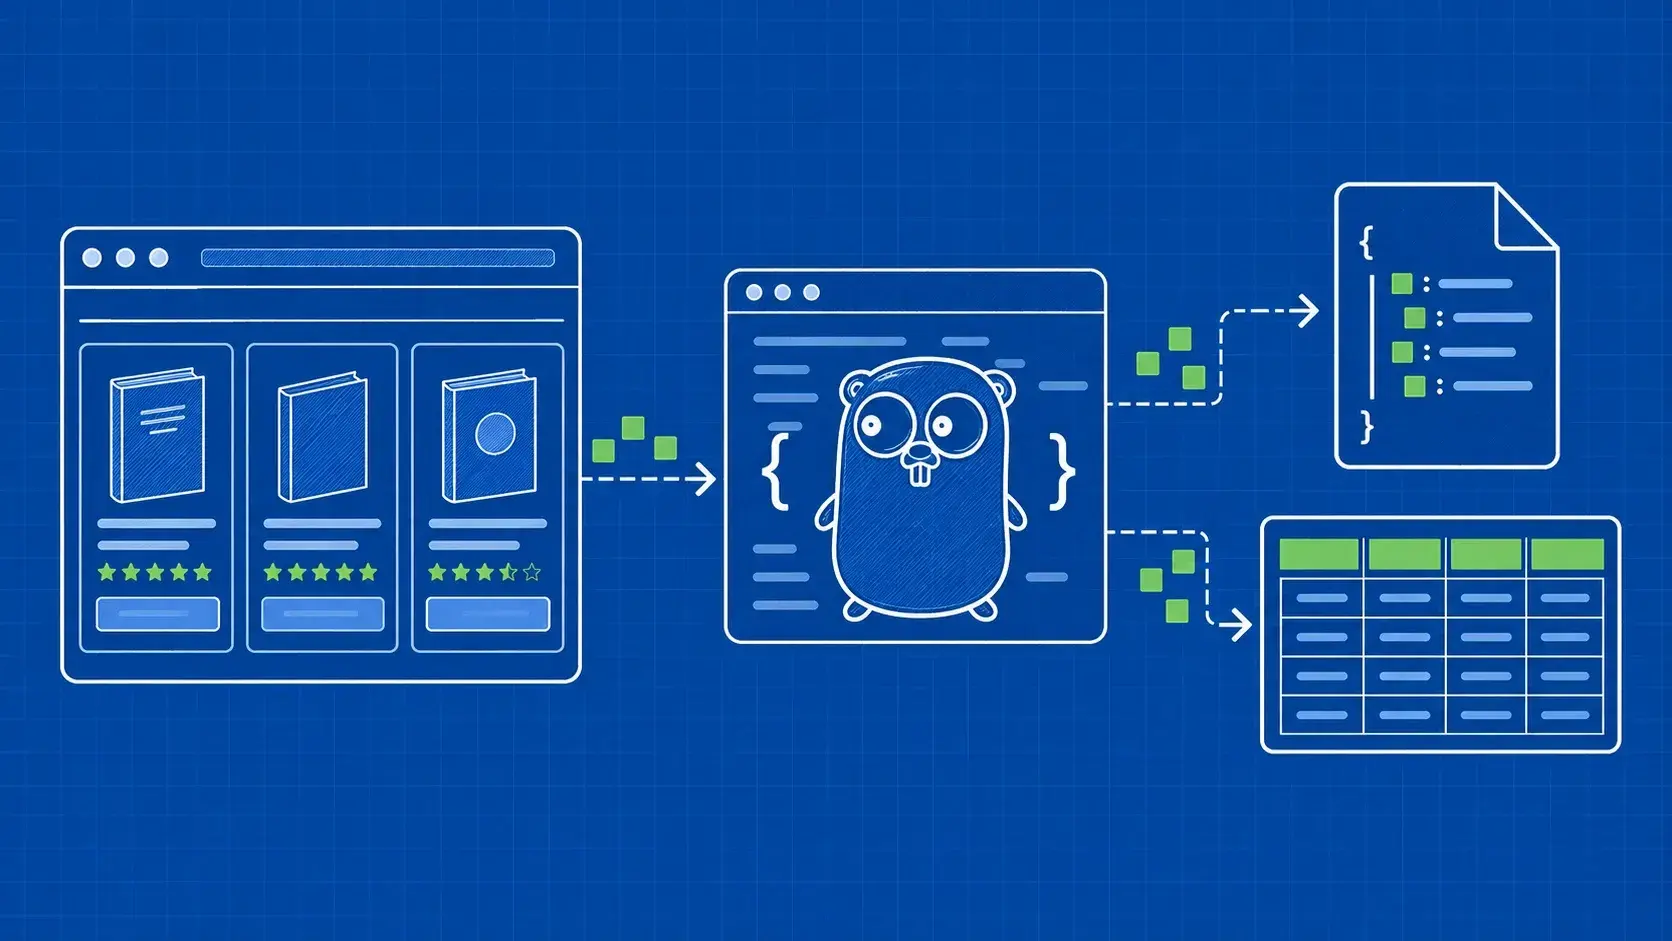
En resumen: Para extraer datos de la web con Go, utiliza net/http para obtener HTML estático y goquery para extraer campos con selectores CSS. Empieza con una página, valida cada registro y exporta a JSON. Añade Colly para programar el rastreo o un navegador para JavaScript solo cuando tu objetivo lo requiera. El ejemplo completo que aparece a continuación incluye tiempos de espera, límites de respuesta, comprobaciones de estado y errores de análisis explícitos.

Un rastreador que muestre un título una sola vez es fácil de demostrar. Un rastreador que te avise cuando una página cambia, una solicitud falla o un campo desaparece resulta mucho más útil en una aplicación en Go. La diferencia radica en los límites que establezcas en torno a la obtención, el análisis y la exportación de datos.

Esta guía te guía paso a paso por el proceso de extracción de datos web con Go utilizando una librería de ejemplo. Crearás un módulo, recuperarás una página del catálogo, extraerás registros de libros y escribirás un archivo JSON. El programa está completo, por lo que puedes ejecutarlo antes de adaptar los selectores a otra fuente. Ya deberías sentirte cómodo con las funciones, las estructuras, la devolución de errores y el manejo básico de la línea de comandos en Go.

El mismo enfoque se aplica a muchos proyectos de scraping web en Go: define primero los campos de salida, inspecciona el código HTML de origen y haz que los datos que faltan sean detectables. A continuación, analizaremos la paginación, Colly, la representación del navegador y las pruebas, para que puedas ampliar la primera versión sin perder el control sobre su comportamiento.

Mantén el criterio de éxito inicial concreto: una página solicitada genera un conjunto válido de registros de libros o, en su defecto, un error que explique por qué no ha sido posible. Esto te proporciona un indicador útil que evaluar antes de añadir más páginas o trabajadores.
Extracción de datos web con Go: elige la herramienta adecuada

Empieza por separar la recuperación de la página, el análisis del HTML y la ejecución en el navegador. Son tareas diferentes, incluso cuando una biblioteca agrupa varias de ellas. Para una página que ya contiene los registros deseados en su respuesta HTML, basta con un cliente HTTP y un analizador.

Herramienta

Responsabilidad

Un punto de partida útil

net/http

Enviar solicitudes y leer respuestas

Si quieres un control explícito sobre las solicitudes y los errores

goquery

Seleccionar y leer elementos HTML

Necesitas selectores CSS sobre el contenido descargado

Colly

Coordinar solicitudes y llamadas de retorno

Necesitas reglas de navegación y programación del rastreo

chromedp

Controlar un navegador a través de CDP

La página requiere la ejecución de JavaScript o alguna interacción

El ejemplo siguiente combina net/http con goquery. Esto permite que las funciones de obtención y análisis sean lo suficientemente pequeñas como para probarlas por separado. Un cambio en un selector no requiere una llamada de red para verificarse, y un error HTTP no se oculta dentro del código de extracción.

Utiliza Colly cuando la carga de trabajo de programación sea considerable. Recurre a un navegador tras inspeccionar la respuesta y confirmar que los campos no están presentes en el HTML inicial. El hecho de ejecutar un navegador no garantiza automáticamente que los valores extraídos sean correctos.

Para el web scraping con Go, esta elección suele ser más importante que comparar la velocidad de los lenguajes. Elige la herramienta menos complicada que devuelva el contenido que tu analizador realmente necesita y, a continuación, verifica los registros resultantes.

Configurar un módulo de Go reproducible

Crea un directorio fuera de cualquier módulo de Go existente e inicializa un pequeño proyecto:

mkdir go-book-scraper
cd go-book-scraper

go mod init example.com/book-scraper
go get github.com/PuerkitoBio/goquery@v1.13.0

El ejemplo se ha probado con Go 1.26.2 y goquery 1.13.0. Esta versión fijada de goquery declara Go 1.25.0 como su versión mínima en los metadatos del módulo. Utiliza una cadena de herramientas compatible en lugar de copiar lo que dice un tutorial antiguo sobre la última versión de Go.

Mantén go.mod y go.sum con el proyecto. La guía de gestión de dependencias de Go explica cómo los requisitos de los módulos y las sumas de comprobación permiten realizar compilaciones reproducibles. Actualiza las dependencias de forma deliberada y vuelve a ejecutar las pruebas del analizador tras cada actualización.

Nuestro objetivo es «Books to Scrape», una librería de ejemplo destinada a ejercicios de scraping. Su catálogo contiene fichas de productos con un título, un precio y un enlace. El ejemplo asume HTML en UTF-8 y procesa una página del catálogo por cada invocación. Ese alcance deliberadamente reducido facilita la inspección del scraping web con Go antes de añadir navegación o trabajadores concurrentes.

Crear un rastreador de HTML a JSON probado

Guarda el siguiente programa completo como main.go. Extrae el título completo de cada libro, el precio mostrado y la URL absoluta del producto. Mantiene los precios como cadenas de origen, incluyendo su símbolo monetario, en lugar de introducir una conversión numérica en el primer paso de extracción.

Los selectores son específicos de este sitio de prácticas. Cada article.product_pod es un contenedor de registros, h3 a contiene el enlace del libro y el atributo del título completo, y .price_color contiene el precio mostrado. Lee los campos dentro de cada «card» para que el título de un libro no se pueda emparejar accidentalmente con el precio de otro libro.

package main

import (
	"bytes"
	"context"
	"encoding/json"
	"fmt"
	"io"
	"log"
	"net/http"
	"net/url"
	"os"
	"strings"
	"time"

	"github.com/PuerkitoBio/goquery"
)

const maxBody = 2 << 20 // A 2 MiB limit chosen for this tutorial.

type Book struct {
	Title string `json:"title"`
	Price string `json:"price"`
	URL   string `json:"url"`
}

func parseBooks(r io.Reader, base *url.URL) ([]Book, error) {
	doc, err := goquery.NewDocumentFromReader(r)
	if err != nil {
		return nil, fmt.Errorf("parse HTML: %w", err)
	}
	cards := doc.Find("article.product_pod")
	if cards.Length() == 0 {
		return nil, fmt.Errorf("no book cards found")
	}
	books := make([]Book, 0, cards.Length())
	for _, node := range cards.Nodes {
		card := goquery.NewDocumentFromNode(node)
		link := card.Find("h3 a").First()
		title, _ := link.Attr("title")
		href, _ := link.Attr("href")
		price := strings.TrimSpace(card.Find(".price_color").Text())
		title = strings.TrimSpace(title)
		href = strings.TrimSpace(href)
		if title == "" || href == "" || price == "" {
			return nil, fmt.Errorf("book card has a missing required field")
		}
		target, err := base.Parse(href)
		if err != nil || (target.Scheme != "http" && target.Scheme != "https") {
			return nil, fmt.Errorf("book card has an invalid link")
		}
		books = append(books, Book{Title: title, Price: price, URL: target.String()})
	}
	return books, nil
}

func fetchBooks(ctx context.Context, client *http.Client, target string) ([]Book, error) {
	req, err := http.NewRequestWithContext(ctx, http.MethodGet, target, nil)
	if err != nil {
		return nil, err
	}
	req.Header.Set("User-Agent", "GoBookTutorial/1.0")
	resp, err := client.Do(req)
	if err != nil {
		return nil, fmt.Errorf("fetch page: %w", err)
	}
	defer resp.Body.Close()
	if resp.StatusCode != http.StatusOK {
		return nil, fmt.Errorf("unexpected HTTP status: %s", resp.Status)
	}
	body, err := io.ReadAll(io.LimitReader(resp.Body, maxBody+1))
	if err != nil {
		return nil, fmt.Errorf("read body: %w", err)
	}
	if len(body) > maxBody {
		return nil, fmt.Errorf("response exceeds 2 MiB")
	}
	return parseBooks(bytes.NewReader(body), resp.Request.URL)
}

func run(w io.Writer, target string) error {
	client := &http.Client{Timeout: 15 * time.Second}
	defer client.CloseIdleConnections()
	books, err := fetchBooks(context.Background(), client, target)
	if err != nil {
		return err
	}
	encoder := json.NewEncoder(w)
	encoder.SetIndent("", "  ")
	return encoder.Encode(books)
}

func main() {
	target := "https://books.toscrape.com/"
	if len(os.Args) > 1 {
		target = os.Args[1]
	}
	if err := run(os.Stdout, target); err != nil {
		log.Fatal(err)
	}
}

Ejecuta el programa y escribe su salida JSON solo después de que la extracción se haya realizado con éxito:

go run . > books.tmp.json && mv books.tmp.json books.json

En la primera página revisada, el primer registro era «A Light in the Attic», con un precio mostrado de «51,77 £» y una URL absoluta del producto. Comprueba esos tres campos en tu salida antes de adaptar el ejemplo. Un archivo JSON legible por sí solo no demuestra que los selectores hayan capturado los valores deseados.

El archivo de salida temporal evita que tu último conjunto de datos correcto sea sustituido por un archivo vacío si falla la siguiente solicitud. La salida estándar contiene el documento JSON; los errores se envían a la salida de error estándar y producen un estado de salida distinto de cero.

El cliente HTTP tiene un tiempo de espera de 15 segundos. La función `fetch` también limita la respuesta a 2 MiB, un límite elegido para este tutorial y no una recomendación universal sobre el tamaño de la página. Lee un byte adicional para que un documento de tamaño excesivo se convierta en un error explícito en lugar de truncarse silenciosamente en HTML.

El contexto de la solicitud se pasa al cliente. En un programa más grande, sustituye context.Background() en el límite de la llamada por el contexto del trabajo, de modo que la cancelación pueda detener el trabajo en curso. La documentación de HTTP de Go también establece una distinción importante: una respuesta como la 404 puede llegar sin que se produzca un error de transporte. Por eso la comprobación del estado está separada de err.

El análisis devuelve un error cuando desaparece la estructura de tarjeta esperada o un campo obligatorio. Este ejemplo rechaza la página en lugar de generar un resultado parcialmente completado. Se trata de una decisión de política que puedes modificar más adelante, pero hazlo de forma explícita: registra las filas rechazadas si tu pipeline de producción acepta resultados parciales.

Por último, los enlaces de los productos se resuelven en función de la URL de respuesta final. Esto es importante cuando una página redirige o utiliza enlaces relativos. El código valida los esquemas de enlaces antes de exportarlos; no sigue esas URL de productos.

Para el web scraping con Go, estos límites te proporcionan una referencia útil: los errores de solicitud, los límites de tamaño de página, los fallos de los selectores y los errores de salida siguen siendo visibles. Los registros resultantes aún necesitan comprobaciones específicas de la aplicación antes de que puedas tratarlos como un conjunto de datos completo.

Añadir paginación sin un rastreo ilimitado

El programa de una sola página no rastrea toda la librería. Para examinar la siguiente página del catálogo, pasa su URL de forma explícita:

go run . https://books.toscrape.com/catalogue/page-2.html

Ambas páginas del catálogo devolvieron 20 registros cuando se comprobaron para este tutorial. Se trata de un resultado observado en el sitio de prácticas, no de una garantía sobre futuros diseños de página u otros sitios web.

Para la paginación automática, haz que la detección sea un paso independiente de la extracción de registros. Analiza el enlace a la página siguiente del mismo documento descargado, resuélvelo en relación con la URL de respuesta y decide si debe incluirse en el siguiente lote de solicitudes. Evita cargar una página dos veces simplemente porque la extracción y la navegación son funciones independientes.

Un bucle de paginación acotado debería hacer lo siguiente:

  1. Comenzar con la URL del catálogo aprobada y un límite de páginas.
  2. Recuperar y validar la página actual.
  3. Extraer los registros e inspeccionar el enlace a la página siguiente.
  4. Resolver ese enlace y comprobar que cumple con el esquema, el host y la ruta esperados.
  5. Detener el proceso si no hay enlace a la página siguiente, si la dirección ya se ha visitado o si se ha alcanzado el límite de páginas.
  6. Espera según los límites operativos de la fuente antes de solicitar la página siguiente.

Comprueba los destinos de redireccionamiento, así como los enlaces descubiertos, si el rastreo debe permanecer en un único origen. Una comprobación de mismo origen solo en la dirección inicial no limita el destino al que un redireccionamiento HTTP envía al cliente.

Realiza un seguimiento de las URL de las páginas visitadas por separado de los identificadores de los registros. Una página de catálogo repetida y un libro repetido son problemas de duplicados distintos. Mantén ambas comprobaciones claras, en lugar de eliminar todos los parámetros de consulta y dar por sentado que las direcciones son equivalentes.

Nuestra guía de rastreo de GoSpider incluye un flujo de trabajo específico para el descubrimiento. Cuando el scraping web con Go va más allá de las direcciones conocidas, esa separación te ayuda a determinar si los registros que faltan se deben a un descubrimiento incompleto o a una extracción incorrecta.

Utiliza Colly cuando necesites programar el rastreo

Colly resulta útil cuando tienes que gestionar tú mismo numerosas llamadas de retorno de solicitudes, reglas de navegación y límites por dominio. Su colector coordina la recuperación y los controladores, como OnHTML, OnRequest, y OnError.

Para el módulo v2, utiliza la ruta del módulo con versión:

go get github.com/gocolly/colly/v2@v2.3.0

Import github.com/gocolly/colly/v2 en tu código fuente de Go. El /v2 sufijo es importante; un ejemplo anterior que importaba la ruta sin versionar no selecciona esta versión del módulo. Si añades Colly al proyecto de demostración más adelante, mantén la coherencia en las reglas de registro del analizador en lugar de cambiar el esquema de salida al mismo tiempo.

Configura AllowedDomains para restringir los destinos y utiliza un LimitRule para el dominio correspondiente. Comprueba el error devuelto por Limit. Establece un tiempo de espera para las solicitudes y registra OnError para que los errores en las solicitudes no se oculten tras las llamadas de retorno.

Si habilitas Async, llama a Wait antes de dar por finalizado el trabajo. Protege las «slices» compartidas y los escritores de salida, o pasa los registros a un escritor a través de un canal. Una llamada de retorno concurrente que añade datos a una «slice» compartida sigue siendo código concurrente y requiere una estrategia de sincronización.

La referencia de paquetes de Colly documenta estos controles. Ten en cuenta que MaxDepth los límites determinan la profundidad de los enlaces; no se trata de un presupuesto por página total. Una página poco profunda puede enlazar a muchos destinos.

Para el web scraping con Go, un marco de trabajo puede reducir el código de programación, pero no elige los selectores correctos, no valida los campos de negocio ni decide el grado de exhaustividad que debe tener un conjunto de datos. Mantén esas responsabilidades explícitas.

Gestiona JavaScript y las solicitudes fallidas de forma deliberada

Inspecciona la respuesta recibida antes de modificar tu pila de extracción. La ausencia de un campo puede indicar un cambio de selector, una página de respuesta diferente o contenido que JavaScript aún no ha renderizado.

Síntoma

Primera comprobación

Código HTTP 200 sin fichas de productos

Revisa el cuerpo devuelto y confirma que se trata de la página esperada

Los datos visibles del navegador no aparecen en el HTML de la respuesta

Comprueba si los proporciona JavaScript o una interacción

HTTP 429

Reducir la frecuencia de las solicitudes y respetar Retry-After cuando esté presente

HTTP 403

Revisa la respuesta y las condiciones de acceso

Tarjetas válidas con valores que faltan

Vuelve a comprobar los selectores de campos y la política de campos obligatorios

Un navegador sin interfaz gráfica puede ejecutar JavaScript y realizar interacciones. En Go, chromedp controla un navegador a través del protocolo Chrome DevTools. Su comportamiento predeterminado inicia Chrome sin interfaz gráfica; la ejecución del navegador sigue requiriendo un entorno de navegador adecuado.

No sustituyas todas las solicitudes HTTP por un navegador de forma predeterminada. Primero determina qué contenido requiere renderización y, a continuación, espera a que se produzca un elemento relevante o un estado de la página, en lugar de basarte únicamente en un tiempo de espera arbitrario.

Del mismo modo, no trates todas las solicitudes fallidas como si pudieran reintentarse. Establece un límite de reintentos, distingue los fallos temporales de los rechazos persistentes y respeta las instrucciones de rastreo de la fuente. Una cadena de agente de usuario identifica a este cliente del tutorial; no es una garantía de acceso.

Un scraping web fiable con Go comienza por diagnosticar en qué fase se ha producido el fallo. Cambiar los selectores no soluciona un tiempo de espera de transporte, y aumentar la concurrencia no repara una página que carece de los datos solicitados.

Prueba los registros antes de aumentar la concurrencia

Las funciones de obtención y análisis tienen entradas independientes, por lo que puedes probarlas sin depender de un sitio web cambiante. Introduce parseBooks un pequeño fixture HTML y una URL base. Comprueba el atributo «title» completo, la cadena del precio original y la dirección del producto resuelta comparándolas con los valores esperados explícitos.

A continuación, varía el archivo de prueba. Elimina un precio, cambia el nombre de la clase de la ficha, omite el atributo «title» y proporciona un enlace no válido. Cada variación debería producir el fallo que espera tu proceso. Incluye una página que devuelva un estado HTTP de éxito pero que no contenga fichas de productos.

Para el comportamiento de red, utiliza el paquete «httptest» de Go para servir respuestas controladas. Devuelve los códigos 404 y 429, retrasa una respuesta hasta que expire el tiempo de espera del cliente y envía un cuerpo que supere el límite de tamaño configurado. Estos casos revelan fallos que una sola solicitud real exitosa no puede detectar.

El ejemplo adjunto se comprobó con fixtures locales, go vety el detector de carreras. El conjunto de fixtures abarcó la salida JSON correcta y los casos de error anteriores, con una cobertura de sentencias del 84,3 %. Dos solicitudes directas al catálogo de práctica verificaron por separado los selectores en producción. Se trata de una validación funcional, no de una prueba de rendimiento.

Antes de añadir paralelismo, asegúrate de que la ruta de salida sea segura para múltiples trabajadores. Reutiliza un cliente HTTP configurado, limita el número de trabajadores y mantén un único propietario para la escritura de registros. Conserva los errores con suficiente contexto de la página para investigarlos, sin incluir las credenciales en los registros.

Para el web scraping con Go, aumenta un límite cada vez e inspecciona tanto el recuento de registros válidos como el de solicitudes. Un mayor número de solicitudes completadas solo resulta útil cuando producen los registros que necesita tu aplicación.

Puntos clave

  • Separa la recuperación de la extracción. Un cliente HTTP obtiene una respuesta; el analizador convierte su HTML en registros. Mantener estas funciones independientes te permite reproducir un fallo del selector a partir de un fixture guardado sin tener que realizar otra solicitud en tiempo real.
  • Define el comportamiento ante fallos junto con tu esquema de salida. Decide si la falta de un título, un precio vacío o una página inesperada debe rechazar una fila o todo el resultado. El ejemplo rechaza la página, lo que hace que un cambio en el diseño sea visible de inmediato.
  • Delimita la navegación antes de automatizarla. Los destinos permitidos, las direcciones visitadas, el recuento de páginas y el ritmo resuelven problemas distintos. Trátalos como controles explícitos cuando amplíes el comando de una sola página a un rastreo.
  • Añade concurrencia una vez que puedas confiar en los registros. Un límite de trabajadores y un único responsable de la salida facilitan la comprensión de la siguiente versión. Supervisa los registros aceptados y las páginas rechazadas junto con las solicitudes de red.

Preguntas frecuentes

¿Forma parte «golang.org/x/net/html» de la biblioteca estándar?

No. El analizador HTML se encuentra en el módulo independiente golang.org/x/net . El paquete estándar de Go html de Go y este analizador tienen rutas de importación y responsabilidades diferentes. goquery utiliza el analizador externo bajo su API de selección. Comprueba los requisitos de los módulos cuando sigas un tutorial, en lugar de dar por sentado que todos los paquetes mantenidos dentro del proyecto Go se incluyen con el conjunto de herramientas.

¿Puede goquery analizar HTML guardado en el disco?

Sí. Abre el archivo y pasa su lector a `goquery.NewDocumentFromReader`, comprobando ambos errores. Cierra el archivo en tu código de llamada; el analizador no se encarga de cerrarlo. Cuando necesites enlaces absolutos, conserva la URL original de la página por separado, ya que un nombre de archivo local no proporciona el contexto de resolución de la URL del sitio web.

¿Cómo se gestionan las páginas que no están en UTF-8?

Convierte la entrada antes de analizarla. El paquete golang.org/x/net/html/charset proporciona NewReader, que devuelve un lector que convierte el HTML a UTF-8 utilizando la detección de codificación y el tipo de contenido declarado. Gestiona los errores de configuración de la conversión y respeta los límites de tamaño de respuesta en tu capa de recuperación de datos. Un fixture que contenga caracteres acentuados ayuda a detectar problemas de codificación que una prueba solo con ASCII pasaría por alto.

¿Debo exportar los precios como números JSON?

Elige la representación adecuada para el usuario. Si necesitas realizar cálculos, define explícitamente la moneda y la escala decimal; un entero en unidades menores o una representación decimal pueden ser más adecuados que un número de coma flotante binario. Conserva el valor original mostrado como un campo independiente cuando la trazabilidad sea importante. No elimines la puntuación a ciegas: los separadores de agrupación y decimales dependen de las convenciones de formato de la fuente.

Conclusión

Una primera implementación útil del web scraping con Go tiene un contrato limitado y observable. Solicita una página conocida, valida la respuesta, extrae una estructura de registro definida e informa de los errores. El ejemplo de la librería te ofrece ese punto de partida con un programa ejecutable y selectores comprobados con el catálogo de prácticas.

Tu siguiente paso debe adaptarse al problema con el que te encuentres realmente. Añade paginación cuando los registros abarquen páginas conocidas del catálogo. Introduce Colly cuando la programación de solicitudes y las llamadas de retorno adquieran importancia. Utiliza la representación del navegador cuando el contenido requerido dependa de JavaScript o de la interacción. En cada caso, mantén el esquema de salida y las reglas de validación lo suficientemente estables como para comparar los resultados antes y después del cambio.

Si el mantenimiento de la recuperación de páginas se convierte en una carga operativa independiente, evalúa la API Scraper de WebScrapingAPI para esa parte del flujo de trabajo. Tu aplicación en Go puede seguir encargándose del análisis sintáctico, la validación de registros y el almacenamiento. Compara el contenido devuelto con los mismos fixtures y expectativas de campos que utilizas con las solicitudes directas.

Empieza por ejecutar el ejemplo, examinar su JSON y cambiar deliberadamente un selector para ver el error. Comprender esa ruta de error es una base práctica para ampliar el scraper con confianza.

Acerca del autor

Sorin-Gabriel Marica, Desarrollador full-stack @ WebScrapingAPI

Sorin-Gabriel Marica

Desarrollador full-stack

Sorin Marica es ingeniero Full Stack y DevOps en WebScrapingAPI, donde se encarga de desarrollar funciones para los productos y de mantener la infraestructura que garantiza el buen funcionamiento de la plataforma.

Extracción de datos web con AWS Lambda: guía para Python y Java 2026
Guías

Extracción de datos web con AWS Lambda: guía para Python y Java 2026

TL;DR: En resumen: el web scraping con AWS Lambda funciona mejor cuando cada invocación es breve, está delimitada y se puede reintentar de forma independiente. Empieza con HTTP directo, AWS SAM y S3, y añade SQS, contenedores, renderización en navegador, proxies o una capa de recuperación gestionada solo cuando la carga de trabajo demuestre que los necesita.

Suciu Dan33 min read
Leer artículo
Cómo utilizar GoSpider: rastrear, depurar URL y extraer datos
Guías

Cómo utilizar GoSpider: rastrear, depurar URL y extraer datos

TL;DR: En resumen: GoSpider es un rastreador de línea de comandos diseñado para descubrir URL, no un extractor completo de datos estructurados. Esta guía sobre cómo utilizar GoSpider muestra cómo realizar un rastreo limitado, gestionar correctamente los resultados, pasar los datos de Colly a CSV y seguir una ruta de diagnóstico para respuestas 403 o páginas que requieren renderización con JavaScript.

Suciu Dan24 min read
Leer artículo
Cómo raspar Redfin: Guía Python de Datos Inmobiliarios
Guías

Cómo raspar Redfin: Guía Python de Datos Inmobiliarios

TL;DR: Redfin expone puntos finales de API ocultos que devuelven JSON estructurado para los listados de propiedades, lo que permite omitir por completo el frágil análisis HTML. Esta guía te guía a través de la construcción de un raspador de Python que extrae datos de alquiler y venta, busca por ubicación, supervisa los nuevos listados a través de mapas de sitio XML y exporta resultados limpios a CSV o JSON.

Suciu Dan14 min read
Leer artículo

Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.