Saltar al contenido
Empezar gratis
Volver al blog

API para principiantes: solicitudes de lectura y recopilación de datos

Robert MunceanuÚltima actualización el 16 min read
API para principiantes: solicitudes de lectura y recopilación de datos
En resumen: una API es una interfaz que permite al software utilizar las capacidades de otro sistema. Para la recopilación de datos, aprende a leer el contrato de solicitud, a interpretar tanto el estado como el contenido de la respuesta, a proteger las credenciales y a comprobar que has recopilado los registros deseados antes de programar más solicitudes.

Un proveedor ofrece una página de productos y una API documentada para consultar ese mismo catálogo. Quieres obtener los nombres, los precios y los identificadores de los productos en un conjunto de datos. En ese momento, las API para principiantes se convierten en un tema práctico: necesitas comprender cómo un programa solicita datos, qué respuesta recibe y si el resultado significa lo que tú crees que significa.

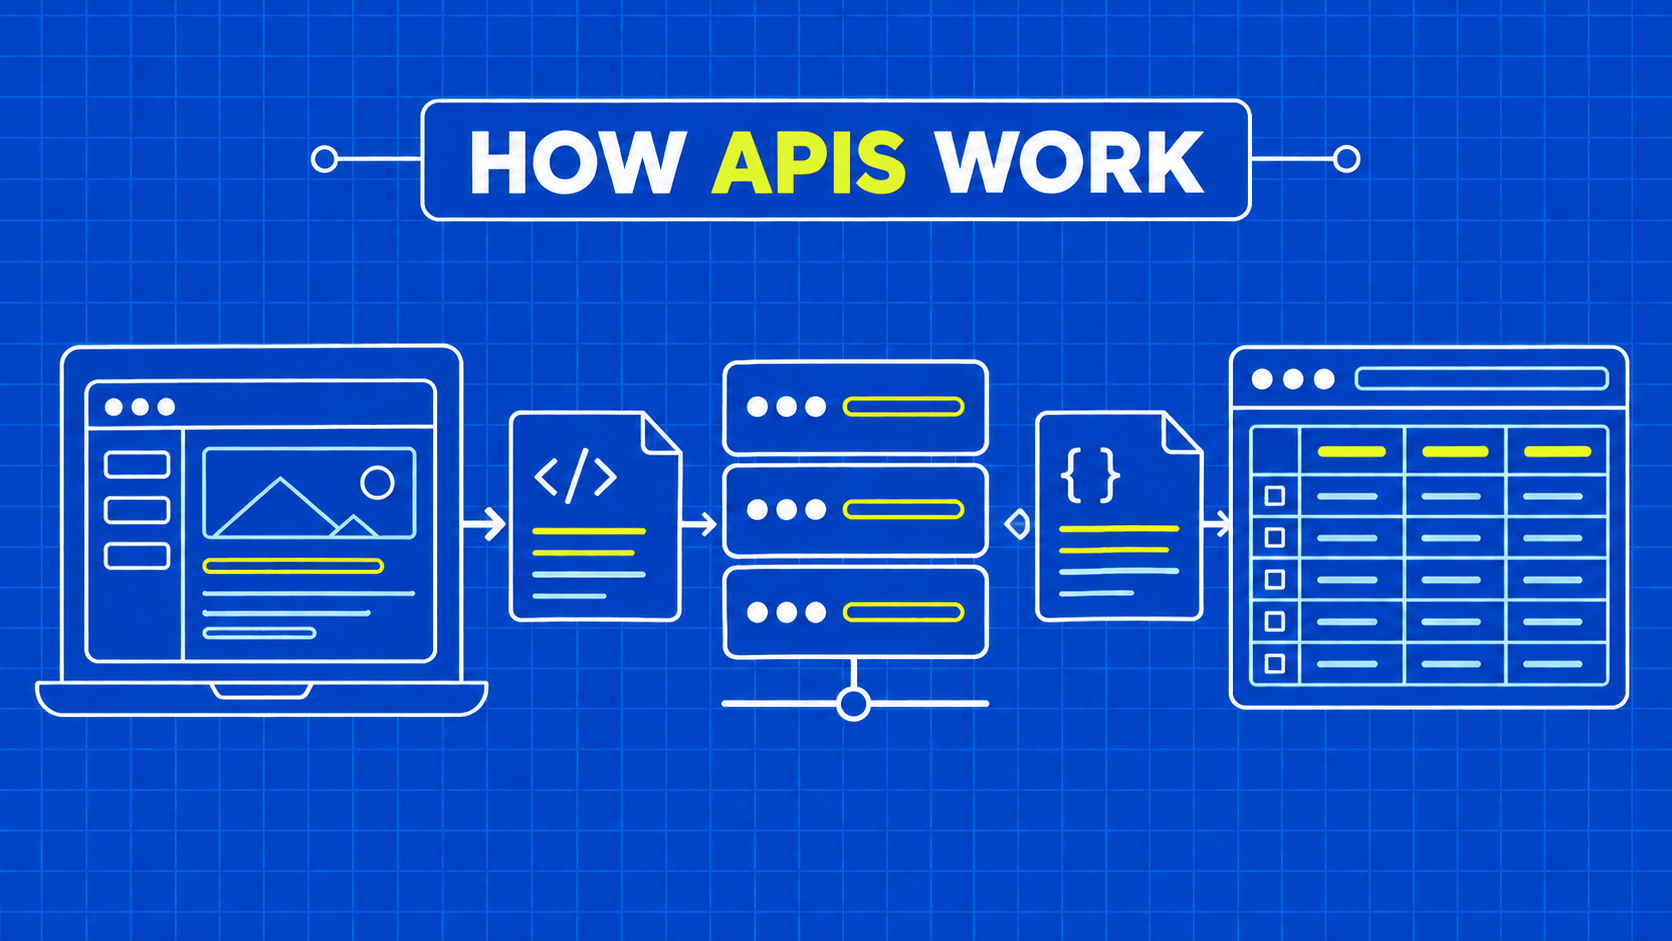
Una interfaz de programación de aplicaciones (API) define cómo el software puede interactuar con una funcionalidad. No se accede a todas las API a través de una red; una biblioteca de programación también expone una interfaz. Esta guía se centra en las API web utilizadas para recuperar datos, en las que tu programa envía una solicitud a un servicio e interpreta su respuesta. La introducción a las API de MDN explica esa distinción más amplia.

Empieza con una operación de lectura documentada y un registro esperado. Utilizaremos un catálogo ficticio y, a continuación, analizaremos un ejemplo de respuesta autónomo. No se requiere ninguna cuenta, clave de API, servicio externo ni instalación de software. El objetivo es formular las preguntas que hagan que tu primera integración real sea fiable.
Imagina que tu tarea consiste en registrar cada mañana el precio de catálogo de una lámpara de escritorio. Una persona puede abrir la página del producto y leerlo. Un programa necesita una forma repetible de identificar el producto y recuperar una representación que contenga los campos relevantes.

Una API documentada puede proporcionar esa interfaz. Su documentación debería indicarte qué operación lee los productos, cómo funcionan los identificadores, qué credenciales se necesitan y cómo interpretar los campos. Aún así, debes comprobar la cobertura: una API compatible puede omitir información que aparece en la página web o actualizarla con una periodicidad diferente.

Término

Significado sencillo

Ejemplo ficticio de catálogo

Cliente

Software que realiza una solicitud

Tu script de recopilación

Servidor

Software que gestiona la solicitud

El servicio de catálogo del proveedor

Punto final

Una dirección utilizada para una operación de API

La dirección de los productos documentados

Solicitud

El mensaje del cliente en el que solicita un trabajo o datos

Leer productos de una categoría

Respuesta

La respuesta del servidor

Estado, encabezados y un documento de producto

Esquema

Reglas que describen la estructura y el significado de los datos

ID del producto, nombre, precio, moneda

Las API para principiantes también deben distinguir entre las interfaces compatibles y los detalles de implementación secundarios. Las herramientas de desarrollo de un navegador pueden revelar las solicitudes que utiliza un sitio web, pero ese descubrimiento no establece un contrato público ni un permiso para reutilizarlas. Es preferible utilizar una interfaz documentada y seguir sus condiciones de acceso.

El scraping y el uso de una API pueden ser entradas para el mismo flujo de datos. El scraping extrae información de una presentación o un documento; el uso de una API documentada sigue un contrato de software publicado. Ninguno de los dos garantiza automáticamente que un campo esté actualizado, sea completo o sea adecuado para tu uso.

Antes de realizar solicitudes, define lo que se considera una observación válida: un producto conocido, un nombre no vacío, el precio en una unidad y moneda conocidas, y la hora en que lo has recopilado. Esa definición guiará todas las comprobaciones posteriores.

Lee la solicitud antes de elegir un cliente

Una solicitud HTTP es más que una URL. Incluye un método, un destino, encabezados y, en ocasiones, un cuerpo. Cada parte tiene una función. Lee la descripción de la operación del proveedor antes de decidir qué valores enviar o de copiar un ejemplo de otro servicio.

El método describe la semántica de la solicitud. GET se utiliza para la recuperación; otros métodos tienen fines distintos. No deduzcas los efectos de un punto final desconocido basándote únicamente en su nombre. El estándar de semántica HTTP define los significados comunes en los que se basan las implementaciones.

La URL identifica el destino de la solicitud. Una ruta puede identificar un producto o una colección, mientras que los parámetros de consulta pueden proporcionar filtros documentados o valores de paginación. Trata los identificadores y los cursores como datos. Utiliza las funciones de construcción de URL de tu cliente al implementar la solicitud, de modo que los espacios, los signos de puntuación y los caracteres reservados se codifiquen correctamente.

Los encabezados contienen metadatos. Dependiendo del contrato, pueden indicar los formatos aceptados, autenticar al cliente o establecer condiciones para una solicitud. El cuerpo contiene contenido adicional cuando la operación lo requiere. Colocar un campo en el lugar equivocado no equivale a proporcionarlo correctamente, aunque su nombre parezca correcto.

Para el catálogo ficticio, redacta una hoja de trabajo de la solicitud en lenguaje sencillo: operación de lectura, filtro de categoría, representación esperada, método de credenciales requerido, tiempo de espera y comportamiento de paginación documentado. Deja las entradas desconocidas como preguntas para la documentación. No las rellenes con convenciones de otro proveedor.

Mantén la herramienta cliente como algo secundario respecto a esta hoja de trabajo. Los clientes de línea de comandos, las bibliotecas de Python y los SDK construyen solicitudes con diferentes conveniencias y valores predeterminados. Nuestra guía del cliente HTTP de Python te ayuda a comparar la capa de solicitud cuando estés listo para implementarla.

Haz que la primera comprobación en producción sea pequeña y de solo lectura. Utiliza el entorno de pruebas del proveedor o un registro de ejemplo permitido, si está disponible, y luego examina la respuesta antes de ampliar el alcance de la solicitud.

Interpreta la respuesta como un estado y un contrato de datos

Una respuesta HTTP contiene un código de estado, encabezados y, posiblemente, un cuerpo. Una transferencia correcta y un registro empresarial válido son observaciones diferentes. Tu colector debe comprobar ambas cosas antes de aceptar los datos.

Un código de estado resume el resultado de la solicitud a nivel HTTP. Un estado de éxito no garantiza que el cuerpo contenga los campos exactos que necesita su tarea. Por el contrario, un estado de error puede incluir un cuerpo de error estructurado que explique la falta de un parámetro o una credencial caducada.

Observación

Qué comprobar a continuación

Qué no se debe dar por sentado

No hay respuesta HTTP

Indicios de problemas de conexión, DNS, TLS o tiempo de espera agotado

El catálogo estaba vacío

Error de autenticación

Requisitos de credenciales documentados

Repetir las mismas credenciales solucionará el problema

Denegación de permiso

Ámbito de la cuenta y acceso a los recursos

Cada denegación supone un bloqueo de red

Respuesta de limitación de frecuencia

Límites del proveedor y orientación sobre retrasos

Realizar más solicitudes en paralelo ayudará

Éxito con contenido inesperado

Tipo de medio, esquema e identidad de la página

Cualquier cuerpo devuelto se considera datos aceptables

Colección vacía válida

Filtros aplicados y estado de finalización

«Vacío» siempre significa que la colección ha fallado

Los encabezados ayudan a explicar el cuerpo. Un tipo de medio como application/json identifica un formato de representación, pero debes gestionar igualmente el contenido mal formado o inesperado. Un error generado por otro componente puede llegar en un formato diferente al que has solicitado.

JSON es un formato de texto que contiene valores como objetos, matrices, cadenas, números, valores booleanos y null. No es la propia API y no aporta automáticamente significado empresarial. El estándar JSON define el formato; el proveedor define si un campo concreto significa céntimos, euros, una fecha u otra cosa.

Al iniciarse en las API, evita equiparar «analizado correctamente» con «correcto». Comprueba los campos obligatorios, los tipos, las unidades y la identidad tras el análisis. Distingue también entre valores ausentes, nulos, cero y texto vacío. El contrato puede asignar a cada uno un significado diferente, y un valor predeterminado automático puede borrar esa distinción.

Trata las credenciales y el acceso como cuestiones independientes

Una clave de API es una credencial que utilizan algunos servicios para identificar o autenticar a quien realiza la llamada. Otras interfaces utilizan tokens de acceso, solicitudes firmadas u otros mecanismos. La documentación del proveedor debe especificar el método requerido y dónde debe introducirse la credencial.

La autenticación y la autorización responden a cuestiones diferentes. La autenticación establece quién o qué está realizando la llamada. La autorización determina si ese solicitante puede realizar esta acción sobre este recurso. Una clave válida no permite necesariamente el acceso a todos los puntos finales ni a los datos de todas las cuentas.

En el caso del catálogo ficticio, un proveedor podría permitir el acceso público a las descripciones de los productos, al tiempo que restringe las cantidades en almacén a determinados clientes. Si la operación de precio se realiza con éxito y la operación de almacén falla, comprueba primero los permisos documentados. No des por sentado que una credencial válida implica que la segunda solicitud también deba permitirse.

Mantén los secretos fuera de los ejemplos de artículos, los archivos controlados, las capturas de pantalla compartidas y los registros habituales. Utiliza una variable de entorno o el mecanismo de secretos aprobado en tu entorno de producción al implementar un cliente. Registra un identificador de credencial si es necesario para el diagnóstico, no el valor secreto en sí mismo.

Las API para principiantes deben dejar clara una distinción adicional: el entorno del navegador y un programa del lado del servidor presentan riesgos de exposición diferentes. Un secreto incrustado en código entregado por el navegador está al alcance de la persona que ejecuta dicho navegador. No lo trates como una credencial almacenada en el servidor simplemente porque la variable se denomine «private».

Lee el ciclo de vida de las credenciales antes de programar el trabajo. Determina cómo caducan o se rotan las credenciales, cómo se obtienen las sustituciones y qué responsable puede resolver los fallos de acceso. Un recopilador programado necesita un estado de fallo claro cuando la autenticación deja de funcionar, en lugar de un bucle que repita la misma solicitud rechazada.

Al compartir un informe de problemas, incluye la operación, el estado, la hora y los detalles del error anonimizados. Estos datos ayudan al proveedor a investigar sin exponer la credencial que da acceso a tus datos.

Practica la interpretación de una respuesta autónoma

Supongamos que el contrato ficticio del catálogo establece que price_minor es un número entero de céntimos, currency identifica la moneda, y next_cursor es un valor de continuación opaco o nulo cuando este resultado no tiene página siguiente. Estas reglas se han inventado para este ejercicio y no deben darse por sentadas en otra API.

Lo siguiente es un ejemplo de cuerpo de respuesta, no una solicitud que debas enviar a ningún sitio:

{
  "items": [
    {
      "id": "lamp-17",
      "name": "Desk lamp",
      "price_minor": 2400,
      "currency": "EUR"
    }
  ],
  "next_cursor": null
}

Empieza por la identidad. El artículo identifica lamp-17, por lo que tu registro debe conservar ese valor en lugar de utilizar su posición en la matriz como identificador del producto. El nombre es un campo independiente y podría cambiar sin que ello suponga la creación de un producto diferente.

A continuación, aplica la regla de unidad indicada. El importe es de 24,00 EUR porque este ejercicio define explícitamente el número entero como céntimos. Sin esa definición, dividir entre cien sería una suposición. Mantén el número entero y la moneda originales junto a cualquier valor de visualización formateado para que las transformaciones posteriores sigan siendo explicables.

A continuación, comprueba si hay continuación. Un valor nulo significa que no hay página siguiente en este contrato ficticio. Esto no demuestra que todo el inventario del proveedor contenga un solo producto; la solicitud podría haber seleccionado una categoría u otro filtro. La exhaustividad siempre se refiere a un ámbito de solicitud definido.

Por último, imagina mentalmente casos negativos: elimina el nombre, sustituye el número entero por una palabra o introduce una moneda inesperada. Decide qué casos rechazaría o pondría en cuarentena tu colector. Un cuerpo puede seguir siendo JSON válido aunque incumpla todas las reglas de negocio útiles.

Este ejercicio capta la esencia de las API para principiantes: la sintaxis, el significado y la aceptación son capas separadas. Una implementación real debería hacer que esas capas sean observables, de modo que una respuesta desconocida se convierta en un fallo clasificado en lugar de en un registro plausible pero incorrecto.

Recopila más de una página sin perder el significado

Las API suelen dividir las colecciones más grandes en páginas. El proveedor puede utilizar números de página, desplazamientos, cursores o enlaces. Aprende el mecanismo de continuación documentado en lugar de dar por sentado que al incrementar un número se recupera todo.

Un cursor suele ser opaco para el consumidor: se devuelve el valor proporcionado tal y como se indica, sin interpretarlo ni modificarlo. Puede codificar un estado que el proveedor puede cambiar. Del mismo modo, un enlace a la página siguiente permite que el servicio proporcione el destino. La guía de arquitectura REST explica por qué las transiciones admitidas son importantes en una interfaz orientada a recursos.

En el caso del catálogo ficticio, conserva los filtros de solicitud junto con el valor de continuación. Un cursor para una categoría puede no ser válido para otra. Registra las identidades de los elementos aceptados y define cómo se gestionan los duplicados, especialmente cuando un catálogo cambiante puede desplazar registros durante la recopilación.

Los límites de frecuencia restringen el volumen de solicitudes de acuerdo con la política del proveedor. Una 429 Too Many Requests respuesta indica una condición de límite de tasa, pero el estado no define cómo cuenta el proveedor el uso. La RFC 6585 describe el código 429 y señala que una respuesta puede incluir Retry-After orientaciones.

Sigue las orientaciones de retardo aplicables y limita el número de reintentos. Trata un error de permiso repetido de forma diferente a un fallo temporal del servicio. Ten en cuenta también el trabajo en su conjunto: varios trabajadores que realicen cada uno un número modesto de solicitudes pueden superar colectivamente la tasa permitida.

Las API para principiantes deben incluir una definición de «finalizado». ¿Se ha llegado a la última página documentada, se ha detenido por agotar el tiempo asignado o ha fallado tras aceptar algunos registros? Guarde esa clasificación con la ejecución. «Se han recopilado 500 productos» no revela si el alcance de la solicitud contenía 500 o muchos más.

Guarda el progreso una vez que los datos aceptados se hayan almacenado de forma permanente, y diseña el comportamiento de reinicio para evitar saltarse trabajo. Mantén la ventana de recopilación en la salida, ya que un recorrido prolongado por una fuente cambiante puede representar observaciones a lo largo del tiempo en lugar de una instantánea exacta.

Pasar de una solicitud satisfactoria a un trabajo fiable

Una respuesta satisfactoria demuestra que una interacción funcionó en unas condiciones concretas. Un recopilador programado también debe gestionar datos modificados, accesos caducados, ejecuciones parciales y fallos de salida. Añade esas responsabilidades de forma deliberada, en lugar de aumentar primero el volumen de solicitudes.

Empieza con un pequeño informe de aceptación. Incluye el alcance de la solicitud, la hora de recogida, el número de registros aceptados, el número de registros rechazados, el estado de continuación y la categoría de fallo, cuando proceda. Evita incluir secretos sin procesar o cuerpos de respuesta sin restricciones en ese informe.

Mantén la distinción entre la recuperación de la fuente y la entrega de datos. Si los registros se aceptaron localmente pero la exportación falló, la recuperación adecuada podría consistir en reenviar la salida guardada en lugar de volver a recuperar la fuente. Una segunda recuperación puede producir una observación diferente y no debe sustituir silenciosamente a la original.

Decide cómo funciona la actualidad de los datos. Una respuesta almacenada no es automáticamente actual solo porque fuera válida en su momento. El almacenamiento en caché HTTP tiene normas de reutilización y validación, documentadas en el RFC 9111. Para tu conjunto de datos, indica también la antigüedad de las observaciones que los consumidores posteriores pueden tolerar.

Prueba un conjunto breve de fallos antes de programar: una credencial no válida, un campo obligatorio que falta, un resultado válido pero vacío y una ejecución de paginación interrumpida. Utiliza entornos de prueba predefinidos o un entorno de pruebas autorizado, en lugar de generar tráfico innecesario hacia el proveedor. Cada caso debe dar lugar a un resultado explícito.

Las API para principiantes se convierten en ingeniería operativa cuando esos resultados tienen responsables. Designa quién se encarga de los problemas de acceso, quién actualiza la asignación de esquemas y quién decide si debe entregarse una ejecución incompleta. La guía de recopilación automatizada vincula estas comprobaciones con la programación y la recuperación.

Mantén el primer flujo de trabajo de producción limitado. Un colector pequeño con un alcance documentado y una validación fiable es más fácil de ampliar que uno amplio cuya finalización satisfactoria oculte datos que faltan.

Puntos clave

  • Lee el contrato de solicitud documentado antes de seleccionar un cliente, incluyendo el método, el destino, los parámetros, los encabezados y las credenciales necesarias.
  • Comprueba por separado el estado de la respuesta, el formato de representación y los campos de negocio; un JSON válido no garantiza que el registro del producto sea válido.
  • Conserva los identificadores, los valores originales, las unidades y el contexto de la recopilación para que las transformaciones de datos sigan siendo comprensibles y reversibles.
  • Define la finalización de la paginación, la gestión de los límites de frecuencia y el comportamiento de reinicio antes de dar por sentado que una solicitud exitosa puede convertirse en una tarea programada.
  • Utiliza categorías de error explícitas y protege los datos confidenciales para que el mantenimiento no dependa de copiar trazas de solicitud sensibles.

Preguntas frecuentes

¿Es una API lo mismo que una base de datos?

No. Una base de datos almacena y gestiona datos, mientras que una API expone una interfaz para utilizar capacidades o información. Un servicio puede combinar varias bases de datos o calcular un resultado sin exponer esos detalles. Los usuarios deben basarse en el contrato de la API publicado en lugar de adivinar a qué tabla interna corresponde una respuesta.

¿Necesito un navegador para llamar a una API?

No necesariamente. Muchas API web documentadas pueden utilizarse mediante un cliente HTTP del lado del servidor sin necesidad de renderizar una página. Los requisitos de autenticación e interacción del proveedor determinan qué se necesita. Un navegador puede resultar útil para explorar la documentación, pero su presencia no sustituye a la comprensión del contrato de solicitud ni al manejo correcto de la respuesta.

¿Todas las API cobran por solicitud?

No. Las condiciones de acceso varían según el proveedor y el servicio, por lo que conviene consultar el plan concreto y las condiciones de uso. No des por sentado que una solicitud fallida es gratuita ni que una versión de prueba tiene los mismos límites que otro plan. Anota las normas de uso pertinentes junto con la integración para que las tareas programadas se mantengan dentro del alcance previsto.

Conclusión

Tu primer hito es un registro que puedas explicar: qué operación lo generó, qué significa cada campo, cuándo se observó y por qué superó la validación. Eso es más útil que un script que imprima un cuerpo desconocido y finalice con éxito.

Para un proveedor real, repite el ejercicio ficticio del catálogo utilizando su documentación. Anota los datos de entrada de la solicitud, conserva el significado original de la respuesta e identifica la condición exacta que pone fin a la recopilación. A continuación, prueba un caso fallido antes de añadir más páginas o una programación. Esto hace que las API para principiantes se basen en un comportamiento que puedas inspeccionar.

Si la información que necesitas solo está disponible a través de páginas web, evalúa la API Scraper de WebScrapingAPI como opción de recopilación. Aplica los mismos hábitos a esos datos de entrada: protege las credenciales, inspecciona la respuesta, valida el registro extraído y conserva suficiente contexto para que otra persona pueda entender el resultado.

Acerca del autor

Robert Munceanu, Desarrollador full-stack @ WebScrapingAPI

Robert Munceanu

Desarrollador full-stack

Robert Munceanu es desarrollador full stack en WebScrapingAPI, donde colabora en todas las áreas del producto y ayuda a crear herramientas y funciones fiables que respaldan la plataforma.

Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.