Saltar al contenido
Empezar gratis
Volver al blog

Cómo extraer datos de Twitter (X) para el análisis de opiniones

Raluca PenciucÚltima actualización el 24 min read
Cómo extraer datos de Twitter (X) para el análisis de opiniones

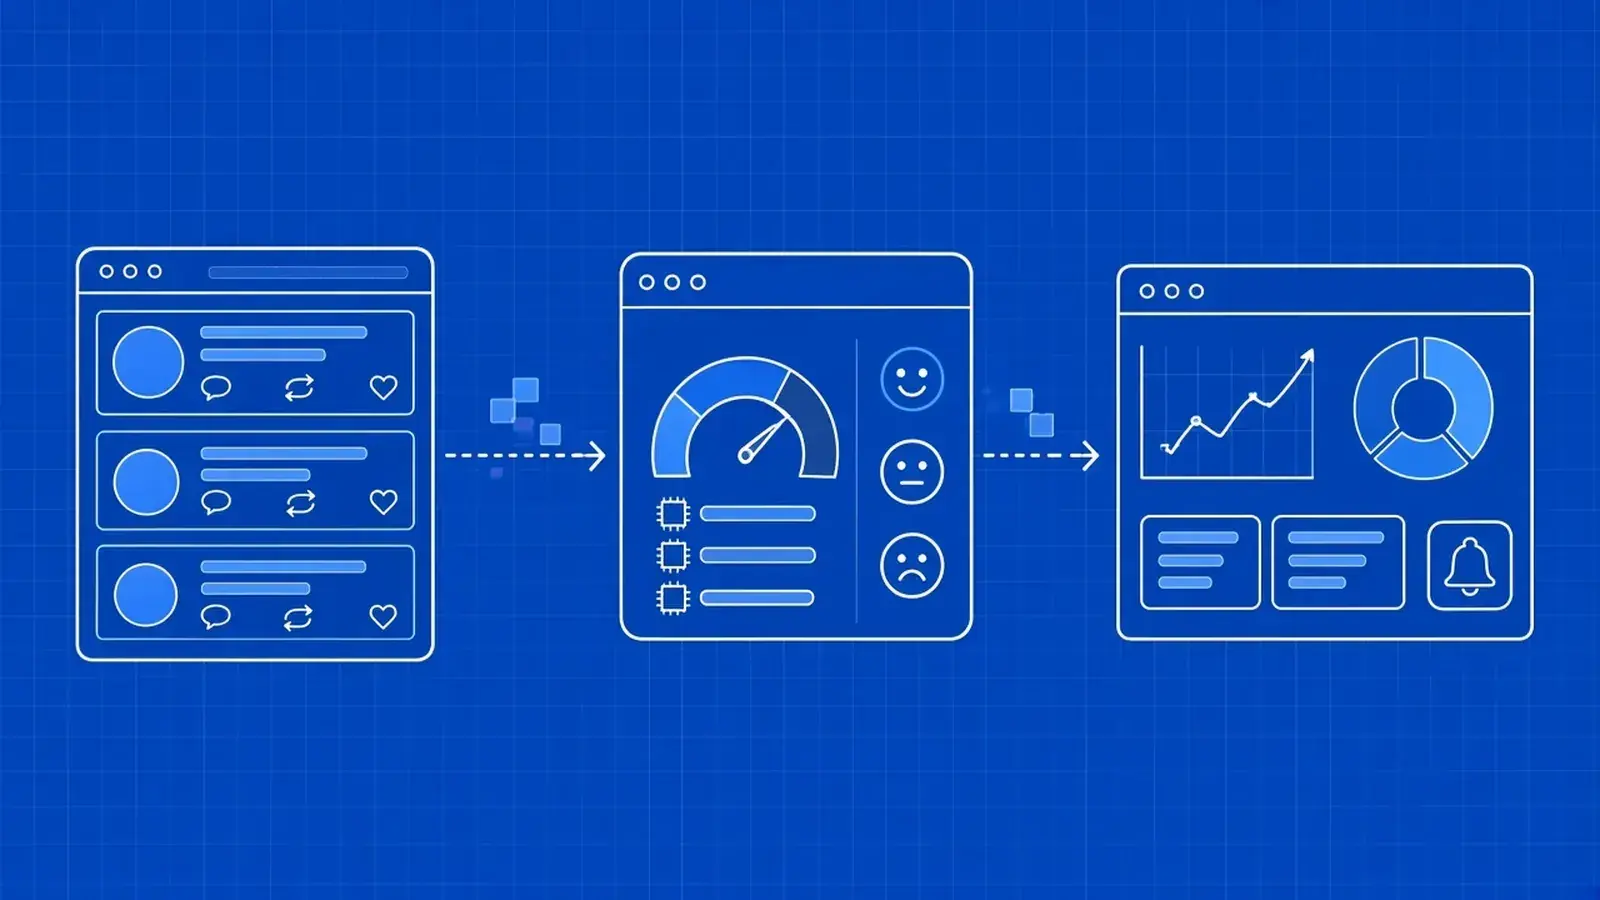
Un equipo de marketing quiere saber qué opinan los usuarios de X (Twitter) sobre su marca, un lanzamiento o un competidor, y alguien tiene que recopilar las publicaciones y puntuarlas. El scraping de datos de Twitter (X) consiste en recopilar de forma programada publicaciones públicas, perfiles y recuentos de interacción de X para poder analizarlos de forma masiva. Antes de realizar el scraping de Twitter, debes saber que X restringe esta práctica en sus propios términos de uso. Esta guía comienza explicando qué se puede recopilar y qué establecen las normas de X, compara la API oficial, los datos gestionados y las páginas públicas renderizadas, y luego aborda la parte que la mayoría de las guías omiten: la limpieza de las publicaciones, la puntuación del sentimiento en Python y la conversión de las puntuaciones en métricas que un equipo de marketing pueda utilizar.

Puntos clave

  • Las condiciones de X prohíben el rastreo o la extracción de datos sin su consentimiento previo por escrito, así que elige tu vía de acceso antes de escribir el código.
  • La API oficial de X es la vía documentada para la búsqueda por palabras clave y la monitorización continua.
  • Las páginas sin iniciar sesión muestran datos limitados. La búsqueda, las cronologías completas y las listas de seguidores están restringidas a usuarios registrados.
  • Almacena cada publicación con su ID y dos marcas de tiempo: cuándo se publicó y cuándo la recopilaste.
  • Empieza con una línea de base de VADER, pasa a un transformador optimizado para Twitter y, a continuación, agrega los resultados para obtener el sentimiento neto y la cuota de voz.
¿Qué datos de X (Twitter) puedes recopilar?

Twitter pasó a llamarse X en 2023, y twitter.com ahora redirige a x.com. La plataforma, los datos y la mayoría de las herramientas para desarrolladores se mantuvieron igual, por lo que las rutas de la API y las bibliotecas siguen utilizando el término «tweet». Esta guía utiliza la publicación (tweet) como unidad de datos y, a partir de ahora, se referirá a ella como «publicación».

Lo que puedas obtener depende de si estás consultando la página web sin haber iniciado sesión o si utilizas la API oficial:

Datos

Página web sin iniciar sesión

API oficial de X

Notas

Una sola publicación pública (texto, hora, recuentos, archivos multimedia)

Normalmente visible

Sí

Los recuentos son instantáneas que cambian constantemente.

Perfil público (biografía, ubicación, URL, fecha de registro, número de seguidores)

Normalmente visible

Sí

Los campos del perfil son datos personales.

Últimas publicaciones en un perfil

Un conjunto limitado

Sí (línea de tiempo del usuario)

Las vistas sin iniciar sesión solo muestran unas pocas.

Respuestas y conversaciones

En parte

Sí (búsqueda por conversation_id)

Cuando no se ha iniciado sesión, suelen mostrarse solo las primeras respuestas.

Búsqueda por palabra clave o hashtag

No (restricción de acceso)

Búsqueda reciente (últimos 7 días), archivo completo para los planes de pago por uso y Enterprise

La búsqueda es el núcleo del trabajo de análisis de opiniones.

Listas de seguidores y de personas a las que sigues

No

Sí (facturado por recurso)

Rara vez se necesitan para el análisis de opiniones.

Cuentas privadas y mensajes directos

No

No es aplicable a este caso de uso

Queda fuera del alcance de esta guía.

X cambia lo que pueden ver los visitantes que no han iniciado sesión sin previo aviso, por lo que hay que considerar la columna central como una tendencia, no como una garantía. En la práctica, el análisis de sentimiento requiere una búsqueda, y la búsqueda en el sitio web exige tener una cuenta. Esto lleva a la mayoría de los proyectos reales a recurrir a la API o a una fuente de datos gestionada.

Por qué los equipos recopilan datos de X: del análisis de sentimiento al marketing

X es uno de los pocos lugares donde clientes, críticos, periodistas y competidores hablan en público y en tiempo real, lo que lo convierte en una fuente habitual de datos públicos de redes sociales para los equipos de marketing e investigación. La tabla relaciona cada objetivo con una métrica y los campos que necesita dicha métrica.

Objetivo

Métrica

Campos necesarios

Sentimiento hacia la marca y la campaña

Sentimiento neto por día

text, created_at, lang

Análisis de la competencia y del mercado

Cuota de voz, combinación de temas

texto, ID del autor, consulta

Señales de asistencia y crisis

Pico de volumen negativo frente a la línea de base

texto, fecha de creación, recuento de respuestas

Descubrimiento de creadores y socios

Tasa de interacción por cuenta

Métricas del autor, número de publicaciones

Conjuntos de datos para PLN e IA

Tamaño del corpus etiquetado, equilibrio de clases

texto, idioma, URL de origen

Partir de la métrica permite que la recopilación sea reducida. Si solo necesitas el sentimiento neto por día, no necesitas listas de seguidores ni biografías de perfil, y recopilar menos datos resulta más barato y más fácil de justificar.

Sentimiento hacia la marca y las campañas

La tarea más habitual: hacer un seguimiento de cómo evoluciona día a día el tono de las publicaciones sobre tu marca, y si una campaña, un cambio de precio o el lanzamiento de un producto lo modifica. Necesitas el texto de la publicación, la hora en que se publicó y el idioma, para poder puntuar cada publicación y agrupar los resultados por día.

Análisis de la competencia y del mercado

Realiza las mismas consultas para tu marca y dos o tres competidores, y podrás comparar el volumen y el tono en paralelo. La cuota de voz (tu porcentaje respecto al total de publicaciones de todas las marcas analizadas) y los temas que la gente plantea sobre cada marca alimentan directamente el trabajo de investigación de mercado y posicionamiento.

Atención al cliente y señales de crisis

Un aumento repentino de publicaciones negativas suele aparecer en X antes de que llegue a la cola de atención al cliente. Compara el volumen negativo de hoy con una referencia móvil y activa una alerta cuando se supere el umbral. Este mismo seguimiento permite detectar cuentas falsas de atención al cliente y suplantadores que responden a tus clientes, que es donde los datos de X se solapan con la protección de la marca.

Descubrimiento de creadores y conjuntos de datos de PLN

Los equipos de marketing utilizan las tasas de interacción por cuenta para preseleccionar a los creadores y socios que ya hablan de su categoría. Los equipos de datos utilizan las publicaciones públicas como texto de entrenamiento y evaluación para los clasificadores. En ambos casos, conserva la URL de origen y el idioma en cada registro para poder auditar de dónde proceden los datos.

Esta sección contiene información general, no asesoramiento jurídico. Las condiciones de X establecen que «queda expresamente prohibido rastrear o extraer datos de los Servicios de cualquier forma y para cualquier fin sin nuestro consentimiento previo por escrito», por lo que las vías más seguras son la API oficial, una fuente con licencia o gestionada, o un uso que haya revisado tu abogado.

Condiciones de X. Las Condiciones de servicio de X (vigentes a partir del 9 de octubre de 2026, en el momento de redactar este artículo) limitan el acceso a «las interfaces publicadas y disponibles actualmente», y la cláusula anterior figura en la lista de usos prohibidos. El resumen que figura al principio de las condiciones añade que, «salvo que lo exija la legislación aplicable», no se puede extraer datos de los servicios sin el permiso expreso por escrito de X ni «intentar eludir ninguna de las limitaciones técnicas que impongamos».

robots.txt. El archivo robots.txt de X bloquea todas las rutas para los rastreadores genéricos (User-agent: * seguido de Disallow: /) e incluye una línea separada de preferencias de entrenamiento de IA que excluye el uso con fines de entrenamiento. El archivo robots.txt es una convención para indicar a los rastreadores qué rutas pueden recorrer, tal y como se describe en el RFC 9309. No es una ley, pero constituye una declaración clara de los deseos del propietario del sitio web.

Tribunales. Los tribunales estadounidenses han tratado el acceso a datos públicos en virtud de la legislación contra la piratería informática de forma distinta a las reclamaciones en las que se alega que un «scraper» ha incumplido los términos contractuales de un sitio web. Las sentencias del caso hiQ contra LinkedIn son el ejemplo más conocido. Los resultados dependen de los hechos, las alegaciones y la jurisdicción, por lo que nada de esto significa que esté permitido el «scraping» de X.

Datos personales. Las publicaciones y los perfiles describen a personas identificables, por lo que en la UE y el Reino Unido se consideran datos personales según el RGPD. Se necesita una base legal conforme al artículo 6 del RGPD, como los intereses legítimos, y solo se deben recopilar los campos que requiera tu métrica, además de establecer un plazo de conservación. El hecho de que sean públicos no exime de estas obligaciones.

Conclusión práctica. Utiliza la API oficial o una fuente con licencia o gestionada siempre que sea posible. Para cualquier otro caso, solicita un análisis jurídico de tu finalidad, fuente y volumen antes de empezar, y planifica una recopilación responsable de datos web en torno a una finalidad clara y al mínimo de información que necesites.

Cuatro formas de obtener datos de X (Twitter)

Existen cuatro vías realistas, que difieren más en cuanto a la posición y el mantenimiento que en el código:

Vía

Lo que se obtiene

Esfuerzo

Posición en los términos

Ideal para

API oficial de X

Publicaciones JSON, usuarios y resultados de búsqueda

Low-code, pago por uso

Interfaz documentada de X

Búsqueda y supervisión continua

Datos gestionados de X (API de datos WebScrapingAPI)

Registros estructurados y delimitados: ID, texto, recuentos, hilos, perfiles

No requiere ejecución

Ámbito acordado por proyecto

Equipos que quieren registros, no recopiladores

Páginas públicas renderizadas (API de Scraper o API de navegador)

HTML o campos seleccionados de una URL pública

Moderado

Sujeto a las condiciones de X. Obtener consentimiento o una revisión jurídica

Comprobaciones aleatorias de URL públicas específicas

Navegadores de desarrollo propio o bibliotecas de código abierto

Cualquier cosa que desarrolles y mantengas

Alto, falla a menudo

A menudo requiere cuentas registradas y entra en conflicto con los términos de X

Rara vez es la opción adecuada hoy en día

Para la búsqueda y el seguimiento de palabras clave, empieza por la API oficial, que se trata en la siguiente sección con ejemplos de código. Si tu equipo prefiere registros ya procesados en lugar de tener que mantener un recopilador, la API de datos de X (Twitter) proporciona publicaciones públicas estructuradas, perfiles, hilos, respuestas y resultados de búsqueda, mientras que WebScrapingAPI se encarga del acceso a las fuentes, la extracción, las actualizaciones del analizador sintáctico y la supervisión de la calidad. Acordas las páginas, los campos, el volumen y la frecuencia de actualización tras revisar una muestra. Para un pequeño número de URL públicas específicas que cubra tu revisión legal, la API de Scraper toma una URL y devuelve HTML, JSON o campos seleccionados, con renderización opcional en JavaScript para las páginas que lo necesiten.

Una breve nota sobre las bibliotecas gratuitas: los módulos de X de snscrape dejaron de funcionar en 2023, y twint está archivado. Las herramientas que aún funcionan dependen de cuentas con sesión iniciada y cookies de sesión, lo que añade un riesgo para la cuenta además del problema de los términos de uso. Puppeteer y Playwright también pueden abrir x.com, pero esa es la vía del «hazlo tú mismo», y esta guía no la aborda.

Si no estás seguro de qué opción te conviene, responde a tres preguntas. ¿Necesitas realizar búsquedas por palabras clave en todo X o solo en cuentas y publicaciones específicas? ¿Tu equipo quiere gestionar un recopilador o simplemente recibir registros? ¿Y con qué frecuencia deben actualizarse los datos? La búsqueda, junto con un pequeño equipo de ingeniería, suele apuntar hacia la API. El trabajo recurrente y de múltiples fuentes sin un equipo que mantenga los colectores apunta hacia los datos gestionados. Un puñado de URL públicas conocidas es el único caso en el que tiene sentido renderizar páginas.

Busca publicaciones recientes con la API oficial de X

La API oficial de X es la interfaz documentada a la que hacen referencia los términos de X, y sus puntos finales de búsqueda están diseñados precisamente para esta tarea: la propia documentación de X enumera la monitorización de marcas, el análisis de tendencias y la investigación como casos de uso.

Configura el acceso y conoce el modelo de precios de pago por uso

Crea un proyecto y una aplicación en la Consola de desarrolladores de X y copia el token de portador de la aplicación. Guárdalo en una variable de entorno en lugar de en tu código:

export X_BEARER_TOKEN="your-bearer-token"

La API de X utiliza un modelo de tarificación de pago por uso: se compran créditos por adelantado en la Consola de desarrolladores, y estos se deducen a medida que las solicitudes devuelven recursos, a diferentes tarifas por punto final. Solicitar la misma publicación de nuevo dentro del mismo día UTC no supone ningún coste adicional, ya que X deduplica los recursos dentro de una ventana de 24 horas UTC (X lo denomina «garantía blanda»). En este caso, hay dos puntos de conexión de búsqueda importantes:

  • Búsqueda reciente (GET /2/tweets/search/recent) abarca los últimos 7 días y está disponible para todos los desarrolladores, con un máximo de 100 publicaciones por solicitud.
  • La búsqueda en el archivo completo (GET /2/tweets/search/all) se remonta hasta 2006 y está disponible para clientes de pago por uso y de Enterprise.

Las tarifas varían, así que consulta las cifras actuales en la Consola de desarrolladores antes de realizar un presupuesto para un proyecto y establece un límite de gasto.

Antes de escribir cualquier código de recopilación, decide cómo debe ser una buena consulta, ya que esta controla tanto tus costes como la calidad de tus datos de sentimiento. Hay algunos hábitos que pueden ayudarte:

  • Ten en cuenta las formas en que la gente menciona realmente a tu marca: (AcmeCo OR "Acme Co" OR #acmeco).
  • Excluye las publicaciones de tu propia cuenta con -from:AcmeCo para que tu texto de marketing no infle el sentimiento positivo.
  • Añade -is:retweet para omitir las publicaciones compartidas, y considera -is:reply si solo quieres publicaciones originales.
  • Filtra por idioma con lang:en cuando tu modelo solo trabaje con inglés.

Las consultas de búsqueda recientes pueden tener una longitud de hasta 512 caracteres, así que divide las listas largas de nombres de productos en consultas separadas.

Busca publicaciones con Tweepy

Tweepy envuelve los puntos finales de la v2 en una Client clase. El script que aparece a continuación busca tuits recientes en inglés que mencionen una marca, omite las repeticiones y divide los resultados en páginas hasta un límite máximo, de modo que una consulta amplia no agote tus créditos:

import os
from datetime import datetime, timezone

import tweepy

client = tweepy.Client(
    bearer_token=os.environ["X_BEARER_TOKEN"],
    wait_on_rate_limit=True,  # sleep until the window resets on a 429
)

QUERY = '"AcmeCo" lang:en -is:retweet'
MAX_POSTS = 500  # hard cap: every returned post costs credits

records = []
collected_at = datetime.now(timezone.utc).isoformat()

for page in tweepy.Paginator(
    client.search_recent_tweets,
    query=QUERY,
    tweet_fields=["created_at", "lang", "public_metrics", "conversation_id", "author_id"],
    expansions=["author_id"],
    user_fields=["username", "public_metrics"],
    max_results=100,
):
    users = {user.id: user for user in (page.includes or {}).get("users", [])}
    for post in page.data or []:
        metrics = post.public_metrics or {}
        author = users.get(post.author_id)
        username = author.username if author else "i"
        records.append({
            "post_id": str(post.id),
            "author_id": str(post.author_id),
            "text": post.text,
            "lang": post.lang,
            "created_at": post.created_at.isoformat(),
            "collected_at": collected_at,
            "like_count": metrics.get("like_count", 0),
            "reply_count": metrics.get("reply_count", 0),
            "repost_count": metrics.get("retweet_count", 0),
            "quote_count": metrics.get("quote_count", 0),
            "conversation_id": str(post.conversation_id),
            "source": "x_api",
            "source_url": f"https://x.com/{username}/status/{post.id}",
            "query": QUERY,
        })
    if len(records) >= MAX_POSTS:
        break

records = records[:MAX_POSTS]
print(f"Collected {len(records)} posts")

Hay tres detalles importantes. Los operadores de consulta (lang:en, -is:retweet, frases exactas entre comillas) se ejecutan en el lado de X, por lo que filtrar allí cuesta menos que filtrar tras la descarga. Campos como created_at y public_metrics solo se devuelven cuando se solicitan en tweet_fields. Además, la author_id expansión devuelve los objetos de usuario coincidentes en page.includes, que es la forma de obtener los nombres de usuario sin necesidad de realizar una segunda solicitud por cada publicación.

Gestionar los límites de frecuencia

Los límites de frecuencia se establecen por punto final y por intervalo de tiempo, normalmente de 15 minutos o 24 horas. Cada respuesta incluye tres encabezados: x-rate-limit-limit, x-rate-limit-remaining, y x-rate-limit-reset (una marca de tiempo Unix que indica cuándo se reinicia el intervalo). Si se supera el límite, se devuelve un código HTTP 429 hasta que se reinicie el intervalo.

Tweepy wait_on_rate_limit=True se encarga de esto por ti. Si llamas directamente al punto final, lee tú mismo los encabezados:

import os
import time

import requests

URL = "https://api.x.com/2/tweets/search/recent"
HEADERS = {"Authorization": f"Bearer {os.environ['X_BEARER_TOKEN']}"}


def get_page(params, max_retries=3):
    for _ in range(max_retries):
        resp = requests.get(URL, headers=HEADERS, params=params, timeout=30)
        if resp.status_code != 429:
            resp.raise_for_status()
            print("Requests left in this window:", resp.headers.get("x-rate-limit-remaining"))
            return resp.json()
        reset_at = int(resp.headers.get("x-rate-limit-reset", time.time() + 60))
        time.sleep(max(reset_at - time.time(), 1) + 1)
    raise RuntimeError("Still rate limited after retries")


page = get_page({"query": '"AcmeCo" lang:en -is:retweet', "max_results": 100})

Esperar a que se reinicie es el comportamiento previsto según la documentación. No repartas una tarea entre varias aplicaciones o tokens para eludir el límite. Ese es precisamente el tipo de solución alternativa que excluyen las condiciones de X.

Por qué una solicitud HTTP simple devuelve una página vacía en X

Si solicitas una URL de publicación en x.com con un cliente HTTP sencillo, obtendrás una página que casi no contiene texto de la publicación. x.com es una aplicación renderizada por el cliente: la primera respuesta HTML es un esqueleto, y las publicaciones llegan después a través de solicitudes JSON en segundo plano que realiza el JavaScript de la página. Para ver el contenido se necesita un motor de navegador real que ejecute los scripts —que es lo que hace un navegador sin interfaz gráfica— y esperar a que el elemento de la publicación exista.

Muchos tutoriales de scraping de X se saltan el navegador y llaman directamente a esos puntos finales JSON en segundo plano, utilizando tokens de invitado e ID de consulta internos copiados del tráfico de red del sitio. Esta guía no hace eso. Esos puntos finales no son una interfaz publicada, y realizar ingeniería inversa en ellos es precisamente el tipo de solución alternativa a las «limitaciones técnicas» que prohíben los términos de X. Si necesitas datos a gran escala, la API oficial y los datos gestionados son las vías más fiables.

Otras vías: datos gestionados y páginas públicas renderizadas

Si la API oficial no te conviene, hay otras dos opciones, y ninguna de ellas requiere que escribas código. Los equipos que deseen registros completos pueden solicitar datos de X gestionados y con un ámbito específico a través de la API de datos de X (Twitter) mencionada anteriormente. Para URL públicas específicas que cuenten con el consentimiento de X o que hayan sido revisadas legalmente por ti, la API del navegador muestra la página y devuelve los campos seleccionados en formato JSON. Funciona como una llamada de solicitud/respuesta, en lugar de una sesión de navegador en vivo que mantengas abierta. Envías la URL, un wait_for_css selector que debe aparecer antes de que la página se considere lista, y extract_rules esa asignación de nombres de campos a selectores CSS. A cambio, recibes el HTML renderizado, JSON, los campos seleccionados o una captura de pantalla. WebScrapingAPI ejecuta el navegador.

La API del navegador está destinada únicamente a páginas públicas que cumplan los requisitos, y WebScrapingAPI te pide que revises los términos de la fuente, los requisitos aplicables y su Acuerdo de servicio antes de utilizarla. Las condiciones de X prohíben el scraping sin consentimiento previo por escrito, así que obtén primero ese consentimiento o un dictamen jurídico, mantén un volumen bajo y nunca inicies sesión ni transmitas cookies. Para búsquedas y supervisión, vuelve a la API.

Atributos «data-testid» de X (solo a título de referencia)

Además de los nombres de clase generados que cambian con frecuencia, el marcado de X incluye data-testid atributos, que son puntos de anclaje más estables. Si los ves, esto es lo que significan los más comunes:

Campo

Atributo

Contenedor de la entrada

article[data-testid="tweet"]

Texto de la entrada

[data-testid="tweetText"]

Nombre y nombre de usuario del autor

[data-testid="User-Name"]

Hora de la publicación

time[datetime]

Botones de «Responder», «Compartir» y «Me gusta» (se contabilizan en aria-label)

[data-testid="reply"], [data-testid="retweet"], [data-testid="like"]

Imágenes

[data-testid="tweetPhoto"] img

Descripción del perfil

[data-testid="UserDescription"]

Ubicación del perfil, URL y fecha de registro

[data-testid="UserLocation"], [data-testid="UserUrl"], [data-testid="UserJoinDate"]

Estos son ganchos de prueba internos de X, no forman parte de un contrato público y pueden cambiar sin previo aviso. La hora de publicación se encuentra en el datetime atributo porque la etiqueta visible es relativa («2h») y está localizada. Para conocer la sintaxis del selector que hay detrás de la coincidencia de atributos, consulta nuestra hoja de referencia de selectores CSS.

Almacena las publicaciones en un registro limpio

Independientemente de la ruta que utilices, normaliza cada publicación en el mismo registro antes de analizar nada. La mayoría de los paneles de control de sentimiento que fallan lo hacen aquí, debido a publicaciones contadas por duplicado o marcas de tiempo mezcladas, no en el modelo.

Campo

Significado

post_id

ID de la publicación de X y tu clave de deduplicación

author_id

ID de cuenta estable (los nombres de usuario pueden cambiar)

text, lang

Texto de la publicación y etiqueta de idioma de X

created_at

Fecha y hora de publicación de la entrada, en UTC

collected_at

Fecha y hora en que la recopilaste, en UTC

like_count, reply_count, repost_count, quote_count

Instantánea a las collected_at. No dejan de cambiar

conversation_id

Agrupa una publicación con sus respuestas

source, source_url, query

De dónde procede el registro y qué consulta lo encontró

Conservar created_at y collected_at separados. El sentimiento diario debería agruparse según la fecha de publicación de las entradas, mientras que los recuentos de interacción solo tienen sentido en relación con el momento en que se leen. Almacena los registros como líneas JSON, una entrada por línea, y conserva solo la última instantánea de cada entrada:

import json
from pathlib import Path


def upsert_jsonl(path, new_records):
    path = Path(path)
    latest = {}
    if path.exists():
        with path.open(encoding="utf-8") as f:
            for line in f:
                rec = json.loads(line)
                latest[rec["post_id"]] = rec
    for rec in new_records:
        old = latest.get(rec["post_id"])
        if old is None or rec["collected_at"] >= old["collected_at"]:
            latest[rec["post_id"]] = rec
    with path.open("w", encoding="utf-8") as f:
        for rec in latest.values():
            f.write(json.dumps(rec, ensure_ascii=False) + "\n")
    return len(latest)


total = upsert_jsonl("posts.jsonl", records)
print(f"{total} unique posts stored")

Las marcas de tiempo ISO 8601 en UTC se comparan correctamente como cadenas de caracteres, lo que simplifica la comprobación de las instantáneas. Si eres nuevo en este formato, aquí tienes cómo analizar JSON en Python. Por último, elimina los campos que tu métrica no utilice y establece un periodo de retención, para que el conjunto de datos no se convierta silenciosamente en un archivo de perfiles.

Realiza un análisis de sentimiento en X publicaciones

El análisis de sentimiento asigna a cada publicación una etiqueta (positiva, negativa o neutra) o una puntuación. Los ejemplos que aparecen a continuación utilizan publicaciones inventadas sobre una marca ficticia, AcmeCo, para que puedas ejecutarlos sin conexión y sin recopilar ningún dato.

Limpia primero el texto

Las publicaciones son breves y contienen ruido. Una pequeña limpieza hace que las puntuaciones sean más consistentes:

  • Sustituye las URL por http y los @nombres de usuario por @user. Esto se ajusta al preprocesamiento con el que se entrenó el modelo optimizado para Twitter que se muestra a continuación, y mantiene los nombres de usuario fuera del texto de análisis.
  • Mantén los emojis. Tanto VADER como el modelo Transformer los utilizan como señales.
  • Elimina los duplicados exactos y las simples republicaciones, que repiten una misma opinión muchas veces.
import re

URL_RE = re.compile(r"https?://\S+")
HANDLE_RE = re.compile(r"@\w+")


def clean_text(text):
    text = URL_RE.sub("http", text)
    text = HANDLE_RE.sub("@user", text)
    return " ".join(text.split())


samples = [
    "Just tried the new AcmeCo cold brew and wow, I'm hooked 😍",
    "@acmeco_help my refund request has been ignored for 9 days. Not great.",
    "AcmeCo is opening a store near the station next month https://example.com/news",
    "Oh great, another AcmeCo app update that logs me out. Love that for me.",
]
cleaned = [clean_text(s) for s in samples]

Empieza con una referencia de VADER

VADER es una herramienta de análisis de sentimiento basada en reglas, diseñada para textos de redes sociales. Es rápida, funciona en cualquier entorno y no necesita datos de entrenamiento, lo que la convierte en una buena referencia. Su compound puntuación oscila entre -1 y 1, y según la documentación de VADER se considera que: 0,05 o más es positivo, -0,05 o menos es negativo, y cualquier valor intermedio es neutro.

from vaderSentiment.vaderSentiment import SentimentIntensityAnalyzer

analyzer = SentimentIntensityAnalyzer()


def vader_label(text):
    compound = analyzer.polarity_scores(text)["compound"]
    if compound >= 0.05:
        return "positive", compound
    if compound <= -0.05:
        return "negative", compound
    return "neutral", compound


for text in cleaned:
    label, score = vader_label(text)
    print(f"{label:8} {score:+.3f}  {text}")

Ejecútalo y fíjate bien en la cuarta muestra. Frases como «Oh, genial» y «Me encanta» hacen que una puntuación basada en el léxico se incline hacia lo positivo, aunque la publicación sea una queja. Mantén ese ejemplo en tu conjunto de prueba: el sarcasmo es difícil para todos los modelos, incluido el transformador del siguiente paso, y es un recordatorio útil de que ninguna puntuación sustituye a la lectura de una muestra de las publicaciones.

Cambia a un Transformer optimizado para Twitter

cardiffnlp/twitter-roberta-base-sentiment-latest es un modelo basado en RoBERTa entrenado con unos 124 millones de tuits de 2018 a 2021 y ajustado para la detección de sentimiento con el benchmark TweetEval. Devuelve negative, neutral, o positive con una puntuación de confianza, y su ficha del modelo lo describe como adecuado para el inglés.

from transformers import pipeline

sentiment = pipeline(
    "sentiment-analysis",
    model="cardiffnlp/twitter-roberta-base-sentiment-latest",
    truncation=True,
)

for text, result in zip(cleaned, sentiment(cleaned, batch_size=32)):
    print(f"{result['label']:8} {result['score']:.3f}  {text}")

El transformador lee las palabras en su contexto, por lo que suele manejar mejor las expresiones informales, la jerga y los emojis que una lista de palabras. La contrapartida es la velocidad: es mucho más lento que VADER en una CPU, y para lotes grandes resulta útil una GPU. Una práctica habitual es utilizar VADER como una rápida comprobación de coherencia y emplear el Transformer para las cifras que se presentan. Si ambos difieren mucho en tus datos, esa información también resulta útil: revisa una muestra de las discrepancias, ya que a menudo apuntan a sarcasmo, nombres de productos que el léxico interpreta erróneamente o publicaciones que no tienen nada que ver con tu marca.

En qué se equivocan los modelos de sentimiento

Presta atención a estos errores antes de incluir cifras en un panel de control:

  • Sarcasmo e ironía. «Me encanta eso» después de una queja se interpreta como positivo en muchos modelos.
  • Publicaciones con citas. Una publicación con una cita puede invertir el significado de la publicación que cita, y la puntuación del texto por sí sola no lo detecta.
  • Bots y picos de spam. Los sorteos, las campañas coordinadas y las respuestas copiadas y pegadas pueden saturar los resultados de un día. Filtra los casi duplicados y analiza el volumen por cuenta.
  • Publicaciones que no estén en inglés. Ambos modelos mencionados anteriormente están optimizados para el inglés. Filtra por el lang campo o utiliza un modelo multilingüe.
  • Muestras pequeñas. Un día con 12 publicaciones puede oscilar de muy positivo a muy negativo. Muestra el volumen junto al sentimiento y utiliza categorías más amplias cuando los recuentos sean bajos.

Antes de confiar en cualquiera de los modelos para tu tema, etiqueta manualmente unas 200 publicaciones de tus propios datos y compáralas. Los nombres de marcas, la jerga de los productos y los términos del sector alteran la interpretación del texto, y una comprobación rápida te indicará qué modelo y qué umbrales son los adecuados.

Convierte el sentimiento en métricas de marketing

Las puntuaciones de publicaciones individuales no ayudan a un equipo de marketing. Los totales diarios sí lo hacen. Suponiendo que cada registro tenga ahora una label columna del modelo, este script de pandas calcula cuatro métricas por cada consulta rastreada: sentimiento neto, cuota de voz, sentimiento ponderado por interacción y un indicador de alerta para picos negativos.

import numpy as np
import pandas as pd

df = pd.read_json("posts_scored.jsonl", lines=True)
df["day"] = pd.to_datetime(df["created_at"], utc=True).dt.floor("D")
df["polarity"] = df["label"].map({"positive": 1, "neutral": 0, "negative": -1})
df["engagement"] = df[["like_count", "reply_count", "repost_count", "quote_count"]].sum(axis=1)
df["weight"] = 1 + np.log1p(df["engagement"])
df["weighted_polarity"] = df["polarity"] * df["weight"]

daily = df.groupby(["query", "day"]).agg(
    posts=("post_id", "count"),
    pos=("polarity", lambda s: (s == 1).sum()),
    neg=("polarity", lambda s: (s == -1).sum()),
    weighted_polarity=("weighted_polarity", "sum"),
    weight=("weight", "sum"),
)
daily["net_sentiment"] = (daily["pos"] - daily["neg"]) / daily["posts"]
daily["share_of_voice"] = daily["posts"] / daily.groupby(level="day")["posts"].transform("sum")
daily["weighted_sentiment"] = daily["weighted_polarity"] / daily["weight"]

daily["neg_share"] = daily["neg"] / daily["posts"]
by_query = daily.groupby(level="query")["neg_share"]
baseline = by_query.transform(lambda s: s.rolling(14, min_periods=7).mean().shift(1))
spread = by_query.transform(lambda s: s.rolling(14, min_periods=7).std().shift(1))
daily["alert"] = daily["neg_share"] > baseline + 2 * spread

print(daily[["posts", "net_sentiment", "share_of_voice", "weighted_sentiment", "alert"]].tail(10))

El sentimiento neto se calcula restando las publicaciones negativas de las positivas y dividiendo el resultado entre el total de publicaciones, por lo que oscila entre -1 y 1. La cuota de voz solo tiene sentido cuando todas las consultas de la comparación se han recopilado de la misma forma, con los mismos filtros. La ponderación logarítmica evita que una publicación viral eclipse todo lo demás, y la alerta compara cada día con los 14 días anteriores para esa consulta, en lugar de con un número fijo. Recuerda que las cifras de interacción son instantáneas: una publicación recopilada una hora después de su publicación parecerá menos activa que otra recopilada un día después, así que recopila los datos según un calendario fijo o vuelve a recopilar las cifras de las publicaciones recientes antes de comparar días.

Cuando presentes estas cifras, incluye el recuento de publicaciones junto a cada dato de sentimiento y vincula cada pico a una muestra de las publicaciones subyacentes para que la gente pueda leer qué lo provocó. Un panel de control que muestre «el sentimiento neto cayó 0,3» sin las publicaciones que lo respaldan invita a sacar conclusiones erróneas. Anota los eventos conocidos, como lanzamientos, interrupciones del servicio, cambios de precios y campañas, para que el equipo pueda distinguir una reacción real del ruido. Y vuelve a revisar tu muestra etiquetada manualmente cada pocos meses, ya que la forma en que la gente habla de una marca cambia, y un modelo que se ajustaba a las publicaciones del último trimestre puede desviarse.

FAQ

Las condiciones de uso de X prohíben el rastreo o la extracción de datos sin su consentimiento previo por escrito, y su archivo robots.txt no permite el uso de rastreadores genéricos. Los tribunales han tratado de forma diferente el acceso a datos públicos y las reclamaciones contractuales, y los resultados dependen de los hechos concretos. Utiliza la API oficial o una fuente con licencia siempre que sea posible, y busca asesoramiento legal antes de intentar cualquier otra cosa.

¿Se puede extraer datos de X sin la API?

Las páginas públicas renderizadas muestran algunas publicaciones y perfiles, pero la búsqueda, las cronologías completas y las listas de seguidores están protegidas por un inicio de sesión, y las condiciones de uso de X restringen el scraping sin consentimiento. Para la búsqueda por palabras clave y la monitorización, la API oficial de X o una fuente de datos gestionada es la vía más fiable, y te proporciona campos estructurados en lugar de código HTML que analizar.

¿Se pueden ver las publicaciones de X sin iniciar sesión?

Los visitantes que no han iniciado sesión suelen poder abrir una sola publicación pública y un perfil público con un conjunto limitado de publicaciones recientes. La búsqueda y la mayoría de las listas requieren una cuenta, y X cambia lo que es visible sin previo aviso. Comprueba qué está realmente disponible antes de crear nada que dependa del acceso sin iniciar sesión, y ten en cuenta que esto puede cambiar.

¿Sigue funcionando snscrape para Twitter?

No. Los módulos de Twitter de snscrape dejaron de funcionar en 2023, y twint está archivado. Las alternativas que se mantienen dependen de cuentas con sesión iniciada y de cookies de sesión, lo que añade un riesgo para la cuenta además del problema de los términos de uso. La API oficial de X, con sus puntos finales de búsqueda de publicaciones recientes y del archivo completo, es el sustituto documentado para la búsqueda por palabras clave.

¿Es X lo mismo que Twitter a la hora de extraer datos?

Sí. Twitter pasó a llamarse X en 2023, y twitter.com redirige a x.com. La plataforma, los datos y la API son los mismos, y muchas rutas de puntos de acceso, métodos de bibliotecas y nombres de modelos siguen utilizando «tweet». Busca ambos nombres cuando consultes la documentación, ya que las guías más antiguas utilizan «Twitter» en todo momento.

¿Cuál es el mejor modelo de análisis de sentimiento para los tuits?

Empieza con VADER para obtener una referencia rápida basada en reglas que funcione en cualquier lugar. Para obtener mejores resultados en publicaciones informales, utiliza un modelo entrenado con tuits, como el Twitter RoBERTa de cardiffnlp. Elijas el que elijas, compáralo con unos cientos de publicaciones etiquetadas manualmente de tu propio tema antes de presentar los resultados obtenidos con él.

¿Cuánto cuesta la API de X?

La API de X utiliza un modelo de pago por uso. Se compran créditos en la Consola de desarrolladores, y cada solicitud deduce créditos en función de los recursos que devuelve, a tarifas diferentes por cada punto final. Las tarifas varían, así que consulta la página de precios para desarrolladores de X y establece un límite de gasto antes de estimar el coste de un proyecto.

Conclusión

Pasar de las publicaciones de X a una respuesta de marketing es un proceso encadenado: elige una vía de acceso que se ajuste a los términos de X, almacena cada publicación como un registro limpio con un ID y dos marcas de tiempo, evalúala con un modelo de referencia y luego con un modelo optimizado para Twitter, y agrega las puntuaciones para obtener el sentimiento neto diario, la cuota de voz y las alertas. La API oficial cubre la búsqueda; los datos gestionados, a los equipos que desean registros ya procesados; y la visualización se limita a páginas públicas específicas que estén cubiertas por tu revisión legal. Los pasos de análisis son los mismos independientemente de la ruta que elijas, por lo que puedes cambiar de ruta más adelante sin tener que reconstruir tu panel de control.

Visualiza páginas públicas y obtén campos limpios

Envía una URL pública a la API de Scraper y obtén el código HTML o los campos seleccionados en formato JSON, con renderización en JavaScript cuando la página lo requiera. Empieza con 5.000 solicitudes gratuitas. Las solicitudes fallidas no se facturan y no hay créditos adicionales por la renderización en JavaScript ni por la geolocalización.

Consulta los precios de la API de Scraper

Acerca del autor

Raluca Penciuc, Desarrollador full-stack @ WebScrapingAPI

Raluca Penciuc

Desarrollador full-stack

Raluca Penciuc es desarrolladora full stack en WebScrapingAPI, donde se dedica a crear rastreadores, mejorar las técnicas de evasión y buscar formas fiables de reducir la detección en los sitios web de destino.

Extracción de datos web con AWS Lambda: guía para Python y Java 2026
Guías

Extracción de datos web con AWS Lambda: guía para Python y Java 2026

TL;DR: En resumen: el web scraping con AWS Lambda funciona mejor cuando cada invocación es breve, está delimitada y se puede reintentar de forma independiente. Empieza con HTTP directo, AWS SAM y S3, y añade SQS, contenedores, renderización en navegador, proxies o una capa de recuperación gestionada solo cuando la carga de trabajo demuestre que los necesita.

Suciu Dan33 min read
Leer artículo
Cómo utilizar GoSpider: rastrear, depurar URL y extraer datos
Guías

Cómo utilizar GoSpider: rastrear, depurar URL y extraer datos

TL;DR: En resumen: GoSpider es un rastreador de línea de comandos diseñado para descubrir URL, no un extractor completo de datos estructurados. Esta guía sobre cómo utilizar GoSpider muestra cómo realizar un rastreo limitado, gestionar correctamente los resultados, pasar los datos de Colly a CSV y seguir una ruta de diagnóstico para respuestas 403 o páginas que requieren renderización con JavaScript.

Suciu Dan24 min read
Leer artículo
Cómo raspar Redfin: Guía Python de Datos Inmobiliarios
Guías

Cómo raspar Redfin: Guía Python de Datos Inmobiliarios

TL;DR: Redfin expone puntos finales de API ocultos que devuelven JSON estructurado para los listados de propiedades, lo que permite omitir por completo el frágil análisis HTML. Esta guía te guía a través de la construcción de un raspador de Python que extrae datos de alquiler y venta, busca por ubicación, supervisa los nuevos listados a través de mapas de sitio XML y exporta resultados limpios a CSV o JSON.

Suciu Dan14 min read
Leer artículo

Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.