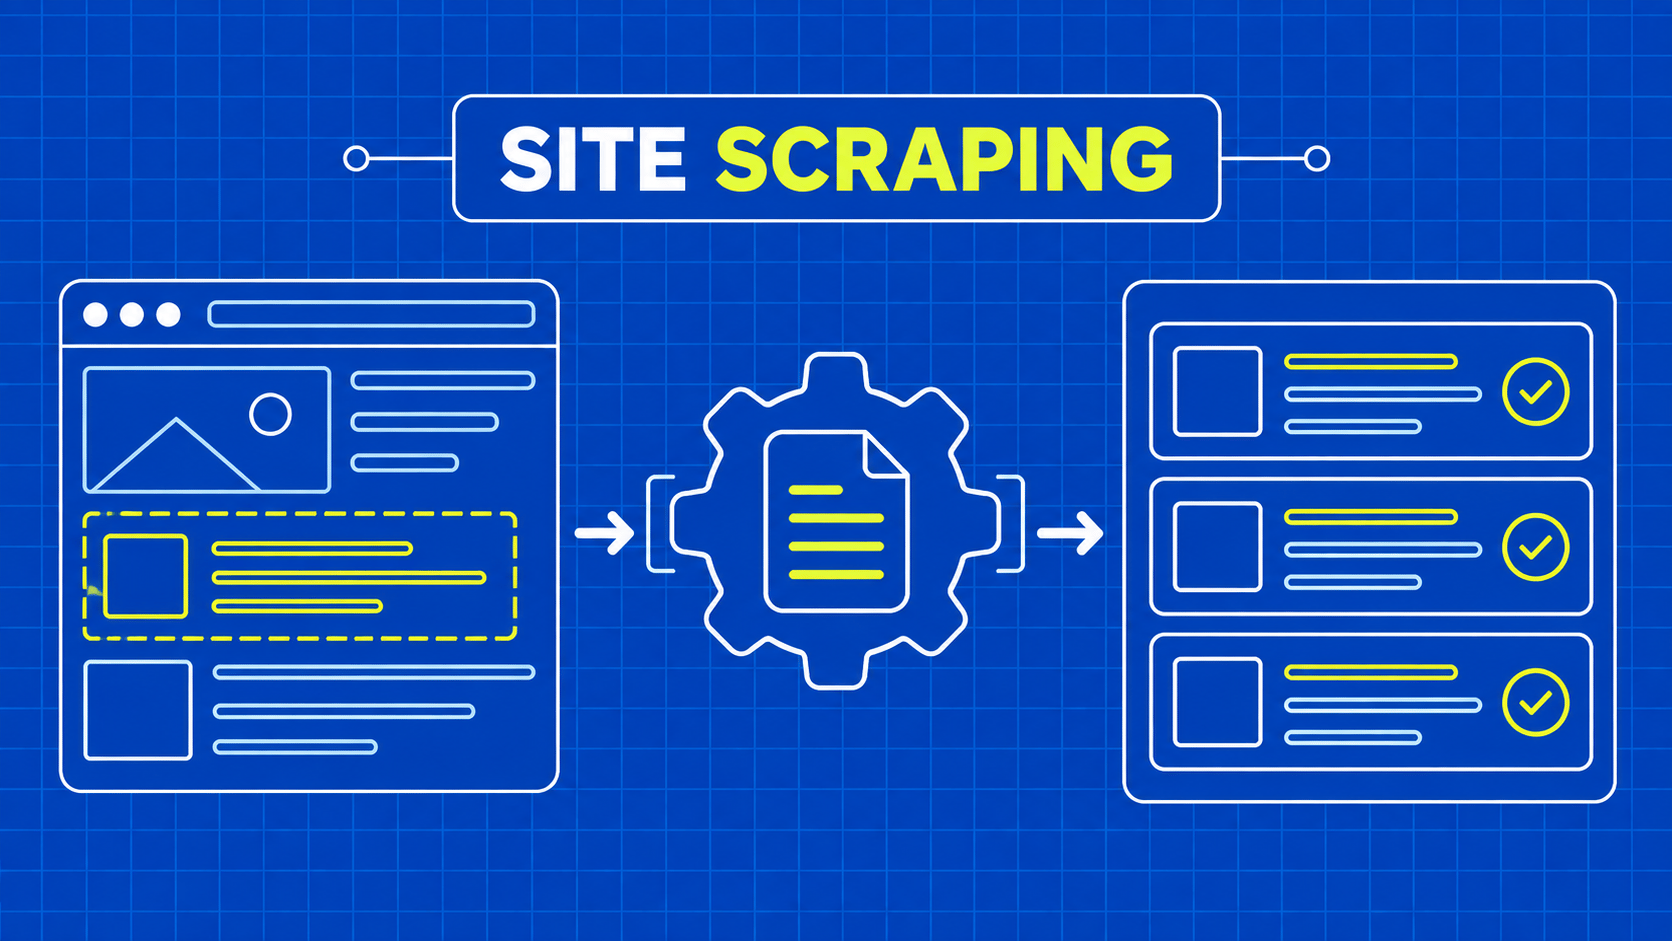
En resumen: un rastreador web útil convierte un conjunto de páginas autorizadas en registros con un significado definido, comprueba dichos registros y genera un lote identificable. Empieza por definir el alcance de los registros y la recopilación, elige un modelo de ejecución que permita acceder a los datos y comprueba la navegación, los valores que faltan y la recuperación antes de programarlo.
Supongamos que necesitas un directorio semanal de organizaciones de un sitio web del que tienes autorización para recopilar datos. Cada fila debe contener un nombre, una dirección, una URL de origen y la hora en que se observó. Un rastreador web es el flujo de trabajo de software que visita las páginas pertinentes y extrae esos campos, pero un recopilador fiable también comprueba si las filas resultantes son utilizables.
Extraer texto de una página es solo el primer problema. Debes decidir qué páginas entran en el ámbito de la recopilación, si varias entradas describen a la misma organización, cómo representar una dirección que falta y qué debe hacer el usuario si la siguiente ejecución se detiene a mitad de camino. Esas decisiones determinan si el resultado puede servir para la elaboración de informes o para funciones de la aplicación.
Esta guía sigue el ejemplo del directorio desde el diseño de los registros hasta su entrega. Se trata de una guía práctica de diseño y selección, más que de una clasificación de productos intercambiables. Puedes aplicar el método a una herramienta visual, a un recopilador basado en HTTP o a la automatización del navegador, siempre que la implementación elegida ofrezca los controles y la información que tu flujo de trabajo necesite.
Empieza con una pequeña muestra aprobada que alguien pueda verificar manualmente. Amplía el proceso solo cuando el recopilador pueda explicar qué sitios ha visitado, qué datos ha aceptado y qué aspectos siguen sin estar claros.