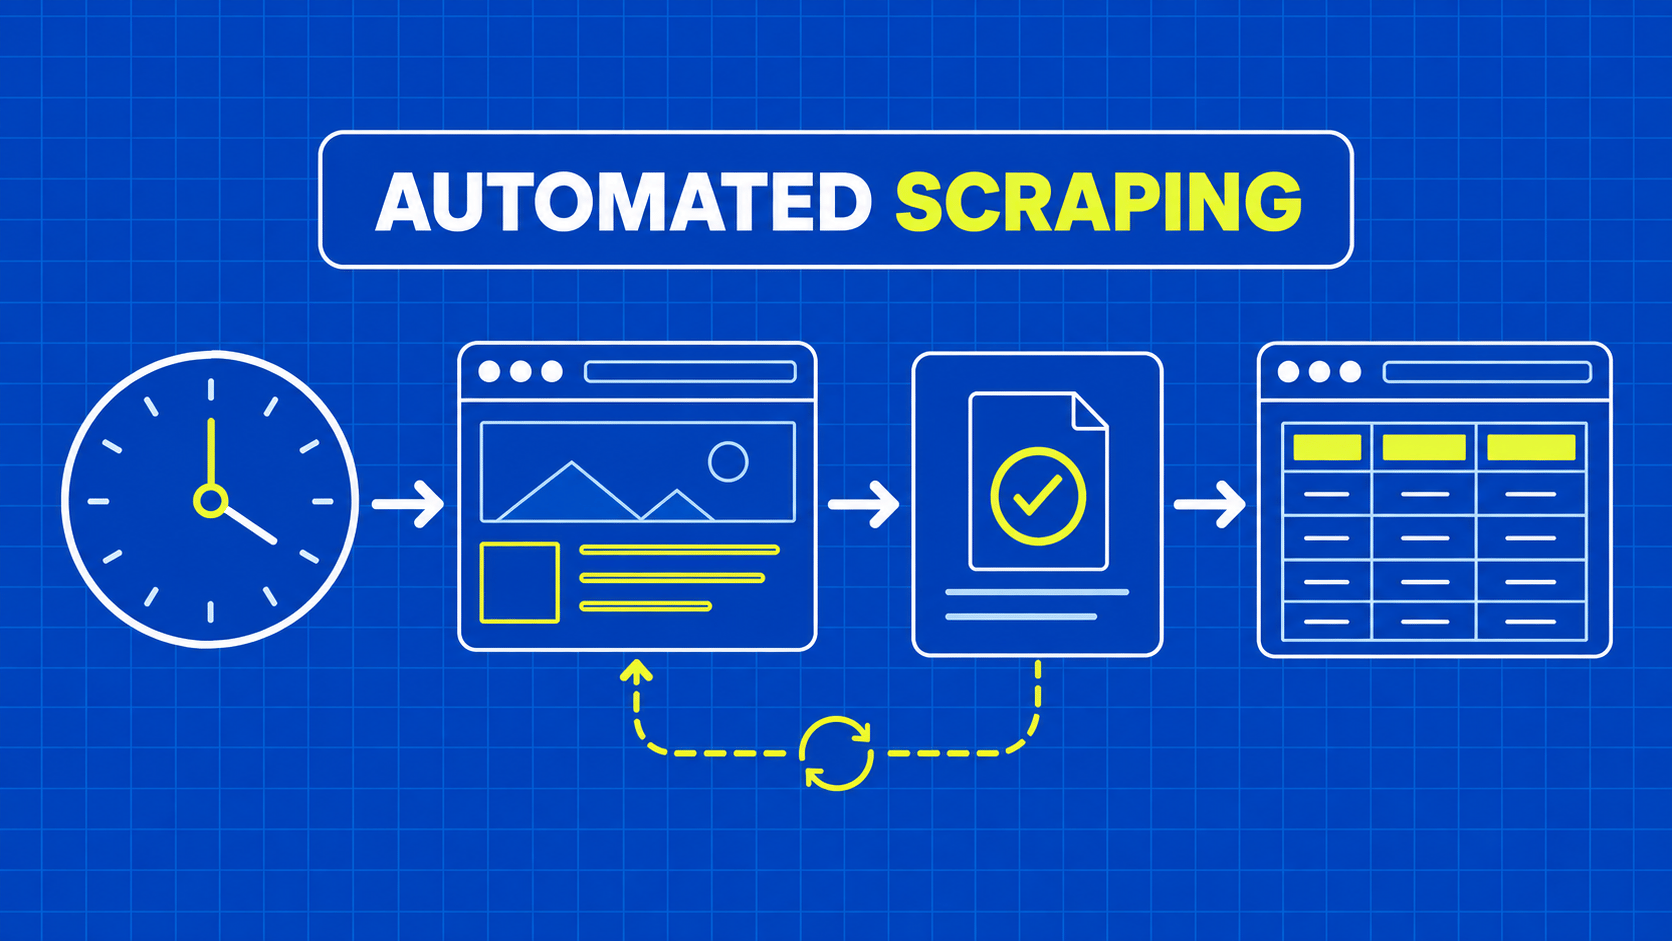
En resumen: El scraping web automatizado requiere algo más que un temporizador para un script. Hay que separar la programación, la recopilación, la validación y la entrega; asignar una identidad a cada ejecución; y diseñar los reintentos de manera que los fallos no dupliquen registros ni borren la cobertura sin que se detecte. Mide los datos utilizables y su actualidad, no solo las solicitudes que se han realizado con éxito.
Un recopilador programado finaliza sin excepciones, pero su exportación contiene los datos de ayer y la mitad de los productos esperados. El script se ejecutó. La tarea de datos falló. Esa distinción debe marcar el diseño del sistema antes de añadir más fuentes o aumentar la concurrencia.
El scraping web automatizado consiste en la recopilación y transformación repetidas de datos de sitios web a través de un flujo de trabajo definido y desatendido. Un trabajo en producción también necesita una forma de reconocer resultados incompletos, recuperar el trabajo interrumpido y explicar qué se ha entregado. De lo contrario, la automatización solo hace que la misma incertidumbre se repita según un calendario.
Para los desarrolladores, el punto de partida más útil es un «contrato de ejecución»: qué fuentes están incluidas, qué se considera una observación válida, dónde van los resultados y qué fallos deben detener la entrega. Un recopilador con esos límites es más fácil de manejar que un rastreador más grande cuya única señal de éxito es un código de salida.
Esta guía recorre esa arquitectura utilizando como ejemplo una recopilación periódica de catálogos. Los patrones también se aplican a directorios públicos, listados de ofertas de empleo y conjuntos de datos de seguimiento de cambios. Se hace hincapié en la semántica de la programación y la recuperación, no en la promesa de que cualquier sitio web pueda ser rastreado automáticamente ni en que la automatización elimine la necesidad de revisión.