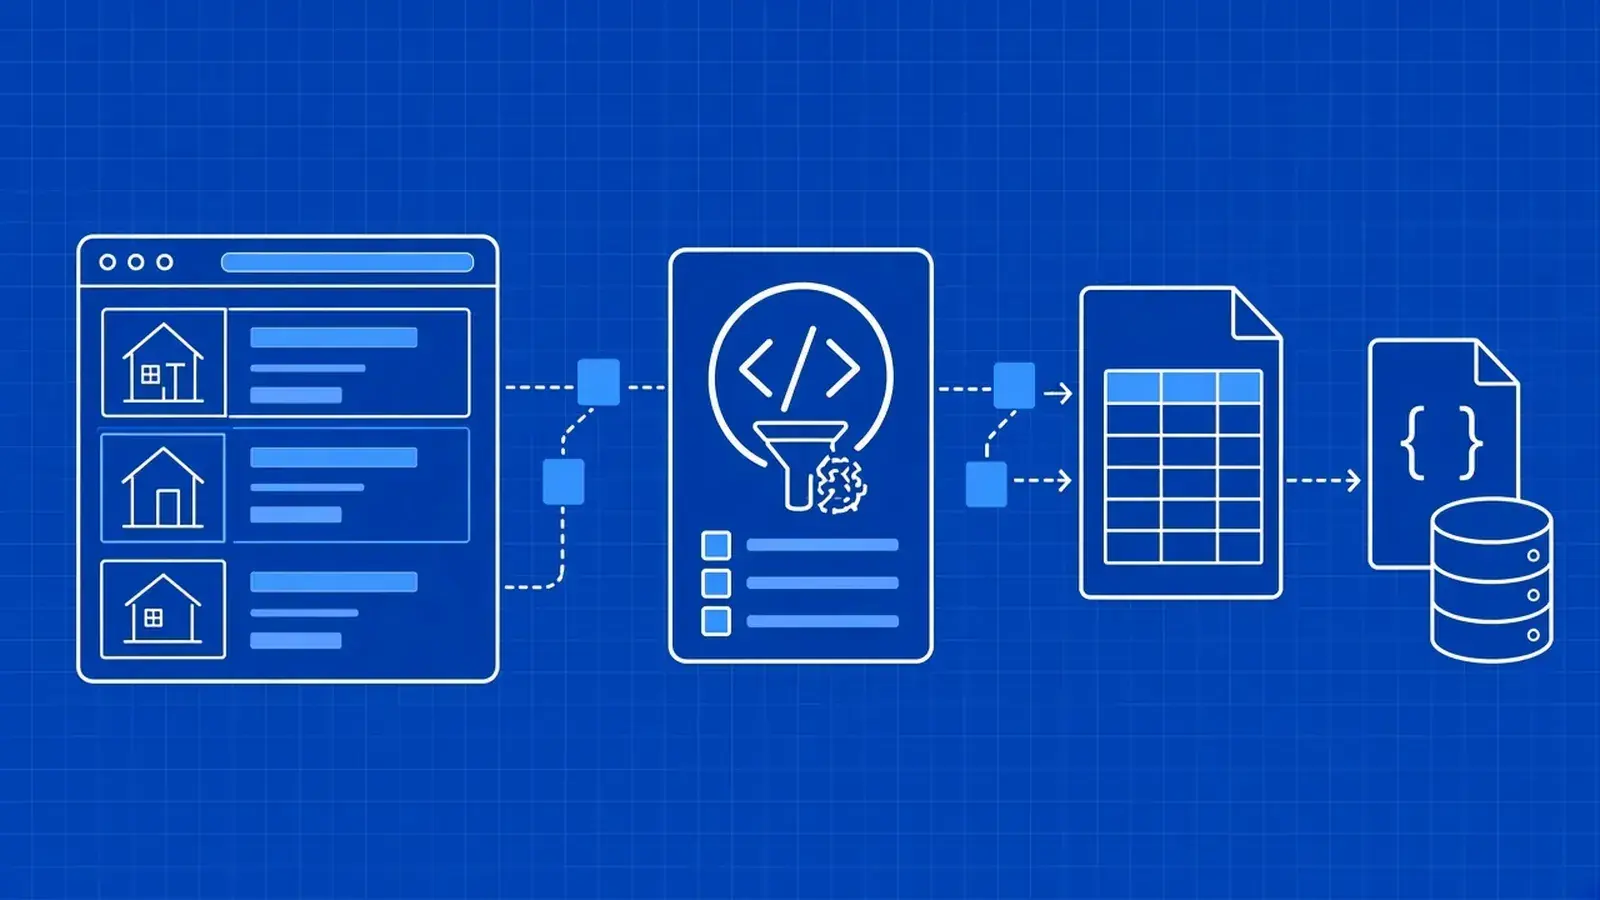
En resumen: el web scraping inmobiliario recopila anuncios, precios y características de propiedades de sitios web y los convierte en datos estructurados. Antes de hacer scraping, busca datos abiertos, un feed de MLS o una API de datos, porque Zillow, Realtor.com y Redfin prohíben la recopilación automatizada en sus términos. Esta guía cubre el modelo de datos, las fuentes, los límites legales, el código en Python y los controles de calidad.
Tarde o temprano alguien te pide "conseguir datos inmobiliarios" de un mercado: precios de oferta para comparables, el inventario para un informe o un feed de anuncios nuevos. Los datos inmobiliarios están por toda la web, así que el scraping parece la respuesta obvia. Pero dos errores hunden la mayoría de estos proyectos. El primero es hacer scraping de un portal cuyos términos lo prohíben. El segundo es tratar un precio de oferta como un precio de venta y construir el análisis sobre la cifra equivocada.
Empieza por la decisión: qué datos existen, qué fuente encaja con cada tarea y qué permiten los grandes portales. Después, crea un scraper en Python con requests, BeautifulSoup y pandas sobre una página de ejemplo que controlas y obtén precios reales de vivienda de un archivo de datos abiertos gratuito.