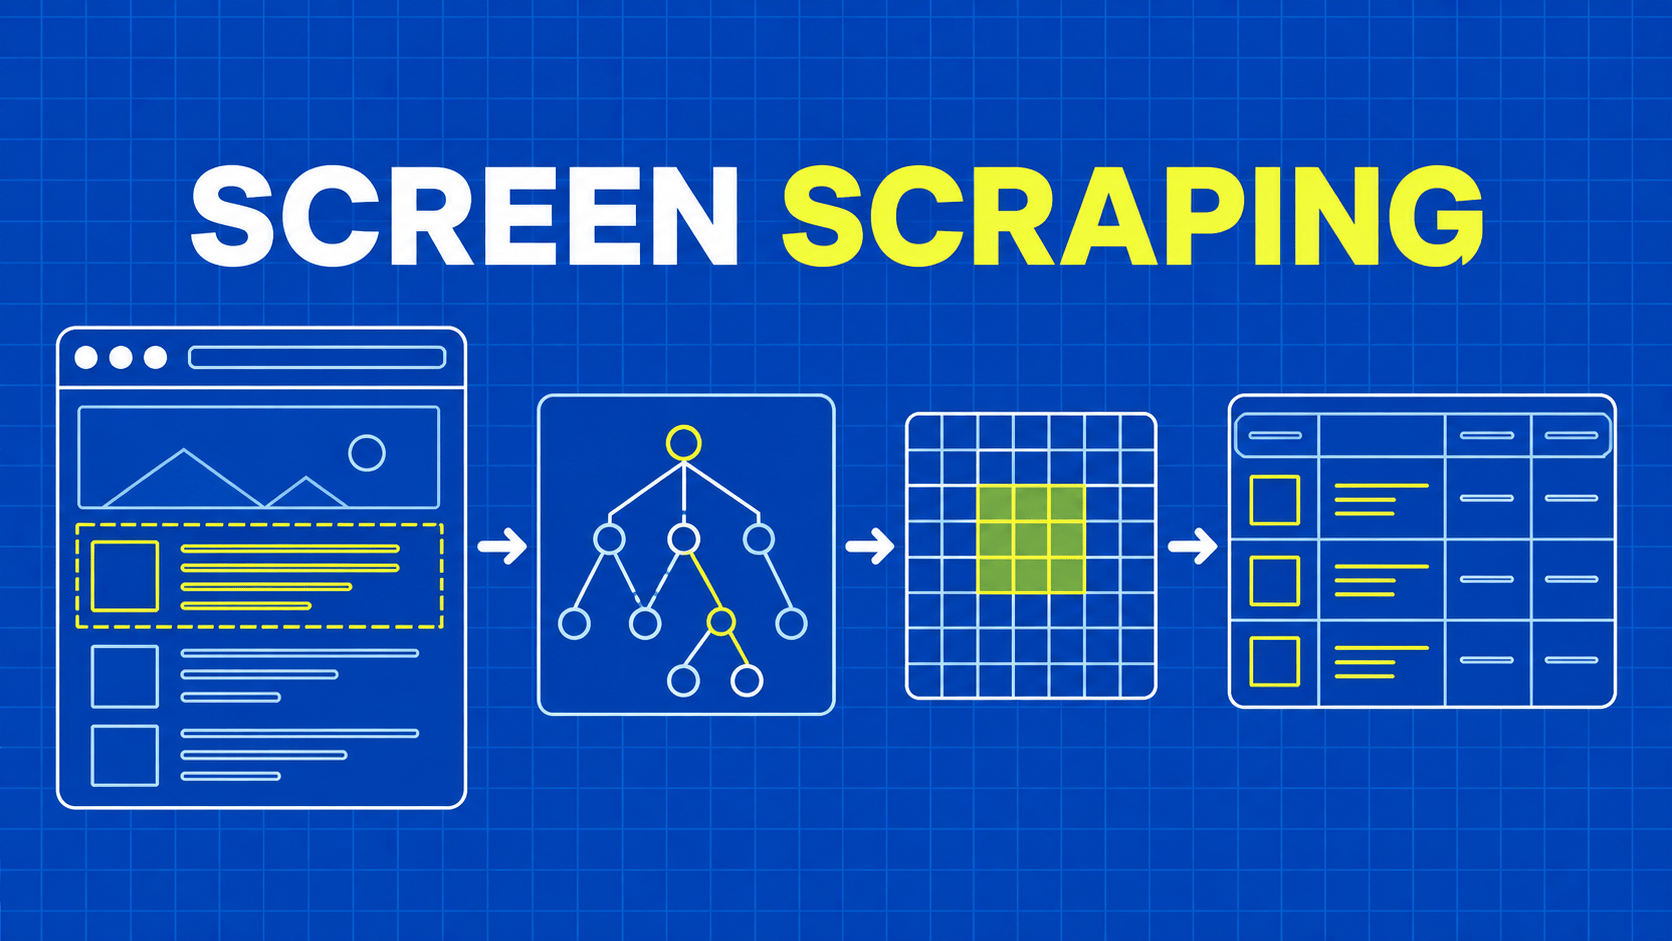
En resumen: El «screen scraping» de sitios web consiste en extraer información de la capa de presentación de un sitio. En el caso de las páginas web normales, lee el DOM renderizado antes de recurrir a capturas de pantalla y al OCR; a continuación, valida los registros y comprueba que la recopilación ha llegado a un punto de parada definido.
Una ficha de producto muestra un nombre y un precio, pero el código HTML que ha descargado tu script solo contiene un contenedor vacío. El «screen scraping» de sitios web resuelve esa discrepancia recopilando datos de la página una vez que el navegador ha realizado el trabajo necesario para mostrarla. El reto práctico consiste en decidir qué representación contiene la información que necesitas y cuándo está lista dicha representación.
La expresión también puede referirse a la lectura de píxeles a partir de capturas de pantalla. Se trata de problemas de ingeniería distintos. Un navegador puede mostrar elementos estructurados, atributos y texto sin reconocer ninguna imagen. El OCR parte de los píxeles y estima qué caracteres contienen, perdiendo muchas de las relaciones que el HTML ya proporciona.
Esta guía presenta un pequeño ejercicio controlado de extracción con el navegador y, a continuación, amplía su razonamiento a trabajos de recopilación reales. Definirás un registro, elegirás localizadores, esperarás a que se alcance un estado significativo, identificarás resultados incompletos y conservarás las pruebas cuando falle la extracción. El ejemplo utiliza una página creada dentro del navegador, por lo que no depende de un sitio web de terceros ni genera tráfico hacia él. Aplica el mismo flujo de trabajo únicamente a las páginas y los datos que estés autorizado a recopilar.