
Saltar al contenido
Empezar gratis
Volver al blog

Herramientas de extracción de contenido: elige en función de la fidelidad del texto

Robert MunceanuÚltima actualización el 16 min read
Herramientas de extracción de contenido: elige en función de la fidelidad del texto
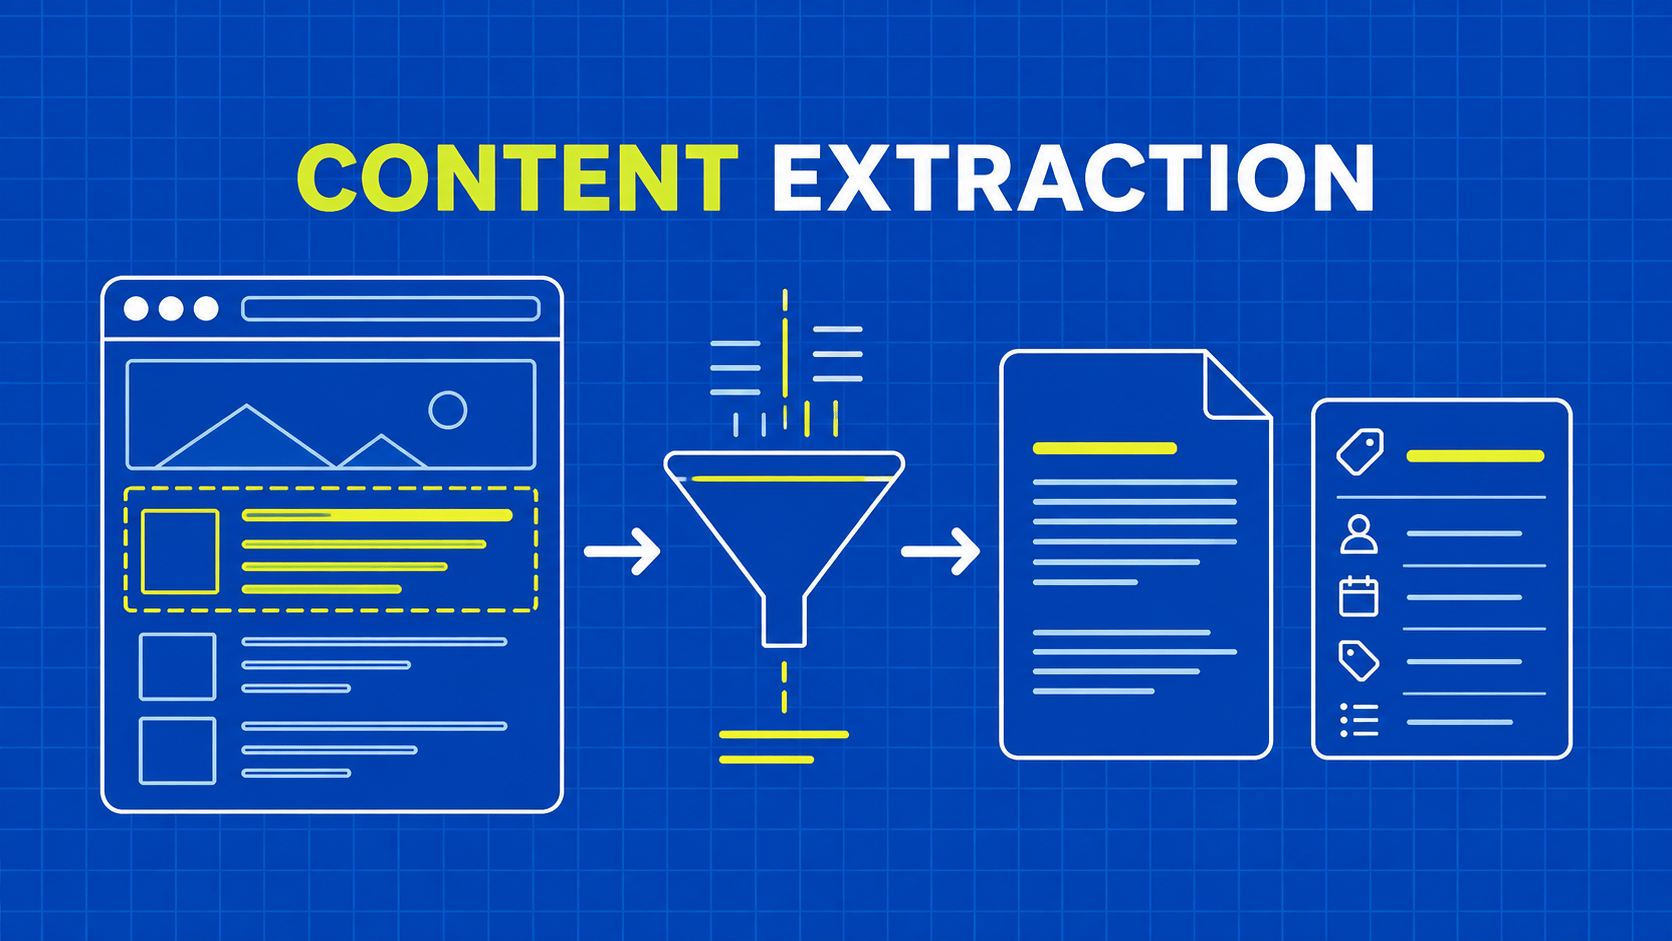
En resumen: Elige un extractor de contenido principal para artículos de distintos sitios web y una biblioteca de selectores cuando controles las reglas de extracción para plantillas conocidas. Evalúa por separado los párrafos que faltan, el texto repetitivo no deseado, la precisión de los metadatos y la estructura conservada antes de adoptar una herramienta.

Un artículo extraído que pierda su calificación final puede resultar más engañoso que un resultado vacío. Las herramientas de extracción de contenido ayudan a convertir el marcado de una página web en texto útil, pero la calidad de esa transformación depende de lo que tu proyecto necesite conservar. Un índice de búsqueda, una interfaz de lectura y un archivo de investigación no necesitan necesariamente el mismo resultado.

Empieza por el documento que necesitas generar. Si deseas obtener el artículo principal de múltiples editores, la extracción automática del contenido principal es un punto de partida útil. Si necesitas una descripción exacta, una tabla de especificaciones o la firma del autor a partir de una plantilla conocida, los selectores explícitos te ofrecen un mayor control. Ninguno de estos enfoques soluciona una respuesta de origen que contenga una pantalla de consentimiento en lugar de la página solicitada.

Esta guía compara cuatro bibliotecas consolidadas en función de sus responsabilidades reales. A continuación, desarrolla un proceso de evaluación repetible que puedes utilizar con tus propias páginas. El objetivo es una elección justificable para tu corpus, con una gestión clara de los errores, en lugar de una clasificación universal o una afirmación sin fundamento de que un extractor entiende todos los sitios web.
Compara las herramientas de extracción de contenido según la tarea que realizan

La extracción del contenido principal intenta identificar el material central de un documento, excluyendo los elementos de interfaz que lo rodean. Una biblioteca de análisis sintáctico de HTML expone el árbol del documento para que puedas implementar tus propias reglas de selección. Ambas pueden generar texto, pero responden a preguntas diferentes: dónde se encuentra probablemente el artículo, frente a qué elementos coinciden con las reglas que has proporcionado.

Herramienta

Enfoque principal

Punto de partida útil

Responsabilidad que asumes

Trafilatura

Extracción automática de texto y metadatos

Un proceso en Python que recopila artículos con diferentes diseños

Validar el texto conservado, configurar los elementos opcionales y gestionar las recuperaciones fallidas

Mozilla Readability

Extracción de artículos orientada al lector a partir de un documento DOM

Una aplicación en JavaScript que genera contenido de artículos legible

Proporciona un documento, valida el resultado y depura el código HTML antes de mostrarlo

Beautiful Soup

Interfaz de Python para buscar y navegar por el código marcado analizado

Plantillas conocidas que requieren reglas personalizadas precisas

Definir los límites del contenido y la política de selección de metadatos

Cheerio

Análisis de código de JavaScript con recorrido basado en selectores

Pipelines de Node.js que extraen elementos específicos

Definir reglas de extracción y obtener cualquier contenido renderizado necesario

Se trata de una comparación de responsabilidades, no de una prueba de rendimiento. La elección adecuada puede variar dentro de un mismo proyecto. Un extractor automático puede gestionar un corpus general de noticias, mientras que un pequeño conjunto de reglas personalizadas procesa páginas de documentación con barras laterales repetidas y ejemplos de código importantes.

En el caso de las herramientas de extracción de contenido, el primer filtro más útil es el coste que supone gestionar las excepciones. Un feed de alcance limitado puede justificar el uso de selectores detallados, ya que el conjunto de plantillas es reducido. Un rastreo amplio puede requerir una extracción automática con una cola de revisión, ya que cada nuevo editor introduce un marcado desconocido. La preferencia de lenguaje es importante, pero la capacidad del equipo para diagnosticar un resultado erróneo lo es aún más.

Mantén la recuperación por separado al evaluar estas opciones. Nuestra guía sobre clientes HTTP de Python ayuda con la capa de solicitudes; las bibliotecas que aquí se comparan deben juzgarse por lo que hacen con el documento que reciben.

Utiliza la extracción automática cuando los diseños varíen

Trafilatura ofrece un paquete de Python y una interfaz de línea de comandos para extraer el texto principal y los metadatos. Su documentación describe la conservación opcional de elementos como enlaces, imágenes y tablas, además de formatos de salida que incluyen texto sin formato, Markdown, JSON y XML. Esos controles la convierten en una opción útil cuando un corpus debe admitir varias representaciones posteriores. Documentación de Trafilatura.

Una prueba sensata comienza con la salida más sencilla que pueda utilizar tu aplicación. Para un índice de palabras clave, el texto sin formato puede ser suficiente. Para un sistema de respuestas que necesite el contexto de la sección, conserva los encabezados y los límites de los párrafos. Para un archivo, conserva una representación más rica junto con el texto, en lugar de dar por sentado que el formato más compacto es siempre el mejor.

Mozilla Readability es la biblioteca de extracción independiente utilizada para la vista «Reader View» de Firefox. Acepta un documento DOM y puede devolver HTML procesado, texto, título, firma y otras propiedades del artículo. Su documentación también explica que el análisis sintáctico modifica el documento proporcionado, por lo que debes pasar una copia cuando necesites el árbol original para otros procesos. Documentación de Readability.

Estos datos sugieren un caso de uso práctico de JavaScript: una interfaz de lectura puede conservar un documento sin modificar para la inspección de metadatos, al tiempo que pasa una copia al extractor de artículos. Tu validación debería seguir comprobando si se conservan los pies de foto, las listas y los breves párrafos de conclusión. Un resultado visualmente plausible no es prueba de que se haya conservado cada pasaje significativo.

Las herramientas automáticas de extracción de contenido necesitan una política de respaldo explícita. Si la extracción no devuelve nada, no sustituyas en silencio todo el texto visible de la página. Eso puede convertir la navegación, las solicitudes de inicio de sesión o los mensajes de error en contenido aparente del artículo. Conserva el estado de error, examina la respuesta de origen y decide si la página requiere una recuperación diferente, una regla específica para la plantilla o su exclusión del corpus.

Utiliza selectores cuando se conozca el límite del contenido

Beautiful Soup ofrece métodos en Python para buscar y navegar por árboles HTML o XML. Su documentación explica cómo la elección del analizador sintáctico puede afectar al árbol generado a partir de un marcado mal formado. Ese detalle es importante cuando una regla funciona en un entorno pero selecciona material diferente tras su implementación. Documentación de Beautiful Soup.

Utiliza esta categoría de herramientas cuando el contenido requerido tenga un límite bien definido: un contenedor de artículo designado, una descripción de producto concreta o una sección de documentación. Anota por qué ese límite es fiable. Un contenedor semántico que albergue de forma consistente el material requerido es un punto de partida más sólido que un nombre de clase generado observado en una sola página.

Cheerio proporciona una API de JavaScript para recorrer y seleccionar el código de marcado analizado. No aplica CSS, no carga recursos externos de la página como lo hace un navegador ni ejecuta el JavaScript de la página. Si el contenido solo aparece tras la ejecución del lado del cliente, el HTML requerido debe proceder de una etapa adecuada de recuperación o representación antes de que las reglas de selección puedan verlo. Introducción a Cheerio.

Las herramientas de extracción de contenido basadas en selectores te ofrecen una ruta de inspección clara: encuentra el contenedor seleccionado, inspecciona sus elementos hijos y compara el resultado con los requisitos. Ese control resulta valioso para tablas y otro material estructurado. También genera trabajo de mantenimiento cada vez que los editores modifican la relación entre el elemento seleccionado y el contenido significativo.

Evita definir el éxito como una selección no vacía. Un sitio web puede reutilizar una clase antigua para un widget de recomendaciones, lo que hace que tu regla sea técnicamente correcta pero semánticamente errónea. Valida el texto representativo, los encabezados obligatorios y la relación entre el título y el cuerpo. Mantén un estado explícito de «plantilla desconocida» cuando esas comprobaciones fallen. Añadir un segundo selector amplio debería ser una excepción sujeta a revisión, no una respuesta automática ante cada campo que falte.

Conserva el significado antes de reducir el documento

Imagina un artículo ficticio sobre una póliza con un título, una fecha de entrada en vigor, tres condiciones y una frase final que limita dichas condiciones a una región específica. Una extracción de texto sin formato que conserve las condiciones pero pierda la frase final ha alterado el significado práctico. Por lo tanto, tus criterios de aceptación deben ir más allá del recuento de palabras.

Elemento

Qué puede salir mal

Comprobación de aceptación útil

Párrafos

Desaparece una salvedad breve pero importante

Marca los pasajes necesarios y confirma que todos se mantengan

Encabezados

Los límites de las secciones se fusionan en un único bloque de texto

Comprueba el orden de los encabezados y el grupo de párrafos que hay debajo de cada uno de ellos

Listas

Las alternativas independientes se convierten en una secuencia aparente

Mantén los límites de las listas y distingue los elementos ordenados de los no ordenados

Tablas

Los valores pierden sus etiquetas de columna o fila

Verificar las asociaciones entre etiquetas y valores en la representación exportada

Enlaces

Los destinos relativos ya no se resuelven correctamente

Almacena o resuelve los destinos en función de la URL de la página de origen

Leyendas

Una explicación se separa de su imagen

Mantén una asociación explícita cuando las imágenes sean relevantes para el caso de uso

Considera esta tabla como un diseño de prueba sugerido, no como una afirmación de que alguna biblioteca concreta falle en estos casos. Algunos proyectos excluyen deliberadamente imágenes o tablas. Esto es aceptable cuando la omisión forma parte del contrato de salida documentado y no socava el uso previsto.

Markdown puede conservar una estructura legible, pero no garantiza la fidelidad. Comprueba cómo las listas anidadas, las celdas multilínea y la sangría del código se mantienen tras la conversión. El texto sin formato puede ser adecuado para la clasificación, aunque resulte insuficiente para una interfaz de lectura. Almacena el nombre de la representación y la versión de la conversión junto con el resultado, para que los usuarios sepan qué han recibido.

Las herramientas de extracción de contenido también deben distinguir entre un documento vacío y un documento no compatible. Un breve comunicado puede ser contenido válido incluso cuando tenga menos palabras que una noticia típica. Una página de referencia compuesta únicamente por tablas puede requerir una ruta de extracción diferente. Define estas categorías antes de elegir un filtro universal de longitud mínima.

Cuando más adelante desarrolles un rastreador centrado en la extracción, mantén estas políticas de documentos separadas de la programación y el descubrimiento de enlaces. La guía de flujo de trabajo de Scrapy aborda esa capa de recopilación más amplia.

Trata los metadatos como pruebas con una fuente

Un título extraído de una página es un valor candidato, no un hecho incuestionable. El título de un navegador puede contener un sufijo del sitio web, un encabezado visible puede estar abreviado y un título de datos estructurados puede describir un objeto relacionado. Establece una política de prioridad basada en el corpus y registra qué fuente proporcionó el valor seleccionado.

En el caso de los autores, mantén la distinción entre una persona, una redacción y una editorial. El nombre de una organización que aparece en un pie de página no debe convertirse en el autor simplemente porque falte la firma real. Mantén un valor en blanco cuando no puedas establecer la relación. Un conjunto de datos de aspecto limpio pero lleno de valores por defecto inventados es difícil de corregir posteriormente.

Las fechas merecen campos separados para la publicación, la modificación y la recuperación. La hora de recuperación forma parte de tu proceso de recopilación y nunca debe sustituir a una fecha de publicación que falte. Conserva la cadena de fecha original junto con un valor normalizado cuando la ambigüedad sea relevante. Una fecha escrita con el mes y el día en formato numérico puede requerir un contexto del que un analizador sintáctico genérico no dispone.

Registra la URL de origen, la URL de respuesta final, la marca de tiempo de extracción y la versión del extractor para cada documento. Añade cualquier URL canónica disponible como una opción independiente, en lugar de sustituir inmediatamente la identidad de la observación. Esto te permite investigar redireccionamientos y páginas duplicadas sin perder de vista dónde se recuperó realmente el contenido.

La pregunta relevante para las herramientas de extracción de contenido no es simplemente si devuelven metadatos, sino si tu proceso de trabajo puede explicar cada campo importante. Los registros de muestra con autores que faltan, fechas múltiples, títulos traducidos y etiquetas canónicas incoherentes deben formar parte del conjunto de evaluación. Revisa esos casos por separado de la calidad del texto del cuerpo, para que un buen extractor de artículos no oculte decisiones erróneas en los metadatos.

Crea un pequeño conjunto de evaluación que ponga de manifiesto los errores

Utiliza código HTML guardado de páginas que estés autorizado a procesar, con un contexto de recuperación registrado. Incluye las páginas habituales con las que tu sistema se encontrará con mayor frecuencia y, a continuación, añade deliberadamente ejemplos difíciles: anuncios breves, artículos largos, listas anidadas, tablas, reportajes con muchas leyendas y páginas con varios bloques similares a artículos. Mantén un conjunto separado de errores de recuperación.

Para cada documento, anota los pasajes que deben conservarse y las regiones que deben eliminarse. No necesitas una plataforma de puntuación sofisticada para empezar. Una hoja de cálculo con la URL de origen, la familia de plantillas, los pasajes necesarios, el material no deseado y las notas de revisión puede hacer que la comparación sea repetible.

Ejecuta cada candidato con la misma entrada guardada. Esto aísla la calidad de la extracción de la variación de la red. Si un candidato recibe HTML renderizado y otro recibe una respuesta mínima, el resultado compara las estrategias de adquisición, además de los extractores. Eso puede resultar útil más adelante, pero no responde a la pregunta de qué biblioteca procesa mejor un documento determinado.

Mide las omisiones y la contaminación por separado. Omitir una cualificación y conservar una invitación de suscripción son errores distintos con consecuencias diferentes. Añade comprobaciones de estructura para los documentos cuyo significado dependa de encabezados, listas o tablas. Evalúa los campos de metadatos individualmente, en lugar de dar por válido un registro en su conjunto solo porque su título parezca correcto.

Incluye una revisión manual de los fallos y una muestra aleatoria de los casos aparentemente correctos. Una comprobación de la longitud mínima del texto puede rechazar resultados vacíos y, al mismo tiempo, aprobar un menú de navegación extenso. El muestreo de registros correctos es la forma de descubrir errores que las reglas automatizadas no habían previsto.

Por último, mantén algunas páginas fuera del conjunto de ajuste. Ajustar cada regla hasta que una muestra minúscula la supere puede dar lugar a una configuración frágil. Un conjunto excluido te ofrece una indicación más útil de si las decisiones son generalizables. Informa de la composición de tu corpus de prueba junto con los resultados; no presentes una evaluación local como una clasificación universal de herramientas de extracción de contenido.

Realiza la extracción con estados de fallo visibles

Separa la adquisición, la extracción, la validación y la entrega en tus registros de ejecución. Una solicitud fallida no debe notificarse como un defecto del extractor, y una solicitud satisfactoria no debe notificarse como contenido utilizable antes de que finalice la validación. Esta separación reduce el tiempo dedicado a depurar el componente equivocado.

Conserva la entrada sin procesar solo cuando tu política de retención lo permita, y mantén una referencia o un hash que te permita asociar una salida con su fuente. Cuando cambie una dependencia, vuelve a procesar una muestra controlada y compara las diferencias significativas antes de ampliar el despliegue. Presta atención a los párrafos eliminados y a los metadatos modificados, no solo al tamaño del archivo.

Nunca des por sentado que el HTML extraído es seguro para su visualización. Readability excluye explícitamente la sanitización de su propósito y recomienda utilizar un sanitizador para el contenido no fiable. Su guía para Node.js también recomienda mantener desactivada la ejecución de scripts de origen. Se trata de cuestiones independientes de la selección del artículo principal. Guía de seguridad de Readability.

En el caso de una interfaz de lectura pública, haz que la sanitización y la gestión de enlaces sean etapas explícitas. Para un flujo de trabajo de texto interno, limita el tamaño de entrada aceptado y registra los fallos de procesamiento, de modo que un documento inusualmente grande no bloquee silenciosamente la cola. Adapta estos controles a tu implementación real, en lugar de dar por sentado que una extracción local satisfactoria está lista para su uso sin supervisión.

Establece desencadenantes de revisión en torno a los cambios observados. Un aumento repentino de cuerpos vacíos, párrafos duplicados, fechas que faltan o fallos específicos de las plantillas merece ser investigado. Las herramientas de extracción de contenido se vuelven fiables gracias a la combinación de reglas de extracción, pruebas representativas y retroalimentación operativa. La biblioteca por sí sola es solo una parte de ese sistema.

Puntos clave

  • Selecciona la extracción automática de artículos para diseños variados y selectores explícitos para límites de contenido conocidos.
  • Evalúa la falta de significado, las plantillas repetitivas no deseadas, los metadatos y la estructura como dimensiones independientes.
  • Compara los candidatos con una entrada guardada idéntica antes de probar sus procesos de recuperación más amplios.
  • Conserva la procedencia y los estados de fallo para que se pueda rastrear y corregir cualquier resultado incorrecto.
  • Vuelva a probar los ejemplos difíciles cuando cambien las plantillas, las dependencias o las políticas de extracción.

Preguntas frecuentes

¿Se pueden deduplicar los artículos extraídos entre diferentes URL?

Sí, pero elige la regla de identidad adecuada para tu caso de uso. Las coincidencias exactas de texto normalizado permiten identificar cuerpos idénticos, mientras que los artículos revisados requieren un tratamiento que tenga en cuenta las versiones. Mantén las URL de origen asociadas a un registro de contenido compartido en lugar de descartar la procedencia. El material sindicado, las ediciones traducidas y las noticias actualizadas pueden requerir registros separados, incluso cuando gran parte de su texto se solapa.

¿Debo traducir el texto antes o después de la extracción?

Por lo general, extrae primero el contenido en el idioma de origen y, a continuación, traduce el material seleccionado. Mantén el original junto a la traducción y registra el paso de traducción por separado. Esto permite comprobar si un error se debe a la extracción o a la traducción. En el caso de corpus multilingües, comprueba los límites de los párrafos y el orden de lectura en idiomas representativos, en lugar de basarte únicamente en muestras en inglés.

¿Puede un modelo de IA reconstruir los pasajes que faltan?

Un modelo no puede reconstruir de forma fiable un pasaje que tu proceso de trabajo nunca haya recopilado. Vuelve a consultar la fuente o marca el documento como incompleto. Si utilizas un modelo para clasificar o resumir el texto extraído, conserva el contenido original y distingue el resultado generado del material observado. No permitas que frases generadas que parezcan plausibles se hagan pasar por pruebas recuperadas de la fuente.

Elige un extractor que puedas explicar

Empieza con un contrato de salida concreto y un conjunto representativo de documentos. A un proceso de corpus en Python le puede resultar útil un extractor automático; una interfaz de lectura en JavaScript puede preferir una salida orientada al lector; un conjunto reducido de plantillas puede funcionar mejor con selectores explícitos. Trata estos aspectos como hipótesis iniciales y deja que la evaluación decida.

La mejor opción es aquella cuyos errores tu equipo pueda reconocer, explicar y corregir. Examina los pasajes que desaparecen, el texto de la interfaz que permanece y los metadatos cuyo significado es incierto. Esas observaciones te dirán más que un recuento de funciones o una demostración en una página conveniente.

Mantén la recuperación y la extracción sustituibles de forma independiente a medida que el proyecto crezca. Si obtener HTML utilizable es la parte que consume tu tiempo de ingeniería, evalúa la API Scraper de WebScrapingAPI como capa de recuperación y, a continuación, ejecuta el extractor elegido y las comprobaciones de validación en el documento devuelto. Toma la decisión utilizando tus propias páginas representativas y criterios de aceptación, y conserva las pruebas que expliquen por qué el proceso los cumple.

Acerca del autor

Robert Munceanu, Desarrollador full-stack @ WebScrapingAPI

Robert Munceanu

Desarrollador full-stack

Robert Munceanu es desarrollador full stack en WebScrapingAPI, donde colabora en todas las áreas del producto y ayuda a crear herramientas y funciones fiables que respaldan la plataforma.

Extracción de datos web con AWS Lambda: guía para Python y Java 2026
Guías

Extracción de datos web con AWS Lambda: guía para Python y Java 2026

TL;DR: En resumen: el web scraping con AWS Lambda funciona mejor cuando cada invocación es breve, está delimitada y se puede reintentar de forma independiente. Empieza con HTTP directo, AWS SAM y S3, y añade SQS, contenedores, renderización en navegador, proxies o una capa de recuperación gestionada solo cuando la carga de trabajo demuestre que los necesita.

Suciu Dan33 min read
Leer artículo
Cómo utilizar GoSpider: rastrear, depurar URL y extraer datos
Guías

Cómo utilizar GoSpider: rastrear, depurar URL y extraer datos

TL;DR: En resumen: GoSpider es un rastreador de línea de comandos diseñado para descubrir URL, no un extractor completo de datos estructurados. Esta guía sobre cómo utilizar GoSpider muestra cómo realizar un rastreo limitado, gestionar correctamente los resultados, pasar los datos de Colly a CSV y seguir una ruta de diagnóstico para respuestas 403 o páginas que requieren renderización con JavaScript.

Suciu Dan24 min read
Leer artículo
Cómo raspar Redfin: Guía Python de Datos Inmobiliarios
Guías

Cómo raspar Redfin: Guía Python de Datos Inmobiliarios

TL;DR: Redfin expone puntos finales de API ocultos que devuelven JSON estructurado para los listados de propiedades, lo que permite omitir por completo el frágil análisis HTML. Esta guía te guía a través de la construcción de un raspador de Python que extrae datos de alquiler y venta, busca por ubicación, supervisa los nuevos listados a través de mapas de sitio XML y exporta resultados limpios a CSV o JSON.

Suciu Dan14 min read
Leer artículo

Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.