Saltar al contenido
Empezar gratis
Volver al blog

La mejor API para extraer datos de Amazon: 5 opciones y cómo elegirla

Robert SfichiÚltima actualización el 17 min read
La mejor API para extraer datos de Amazon: 5 opciones y cómo elegirla
En resumen: La mejor API de extracción de datos de Amazon depende del resultado que necesites. Elige un punto final específico de Amazon para campos predefinidos de productos, búsquedas u ofertas; plantéate la recuperación general de páginas si ya dispones de un analizador sintáctico. Compara las opciones utilizando los mismos productos, ubicaciones, campos obligatorios y coste por registro aceptado. La lista de finalistas que figura a continuación se basa en la documentación actual e incluye un plan de prueba práctico para comprobar si se ajusta a tus necesidades.

Imagina dos servicios que devuelven el mismo producto. Uno proporciona una página que tu equipo debe analizar. Otro devuelve JSON, pero su precio corresponde a una variante o una ubicación de entrega diferentes. Ambas solicitudes pueden parecer correctas, aunque solo una —o ninguna— cumpla tus requisitos.

La elección de la mejor API de scraping de Amazon comienza por definir la información que desea recopilar. Un rastreador de precios necesita un contexto coherente de productos y ofertas. Una herramienta de descubrimiento necesita resultados de búsqueda y cobertura de páginas. Un proyecto de investigación programado necesita lotes completos que lleguen dentro de su ventana de recopilación.

Esta guía compara cinco opciones en función de sus capacidades documentadas y explica cómo evaluarlas sin considerar el número de solicitudes anunciado como conjuntos de datos completos. No es necesario ser desarrollador para seguir el proceso de selección: empieza con una muestra de productos, anota los campos que necesitas e inspecciona lo que devuelve cada servicio.

Las descripciones de los proveedores se basan en la documentación consultada en septiembre de 2026. No hemos realizado una evaluación comparativa de los servicios de pago, por lo que el artículo no designa al proveedor más rápido ni al más fiable. En su lugar, te ofrece una lista de finalistas, un cálculo de costes y una lista de verificación de aceptación que puedes aplicar a tu propia carga de trabajo.

La mejor API para extraer datos de Amazon: empieza por el resultado

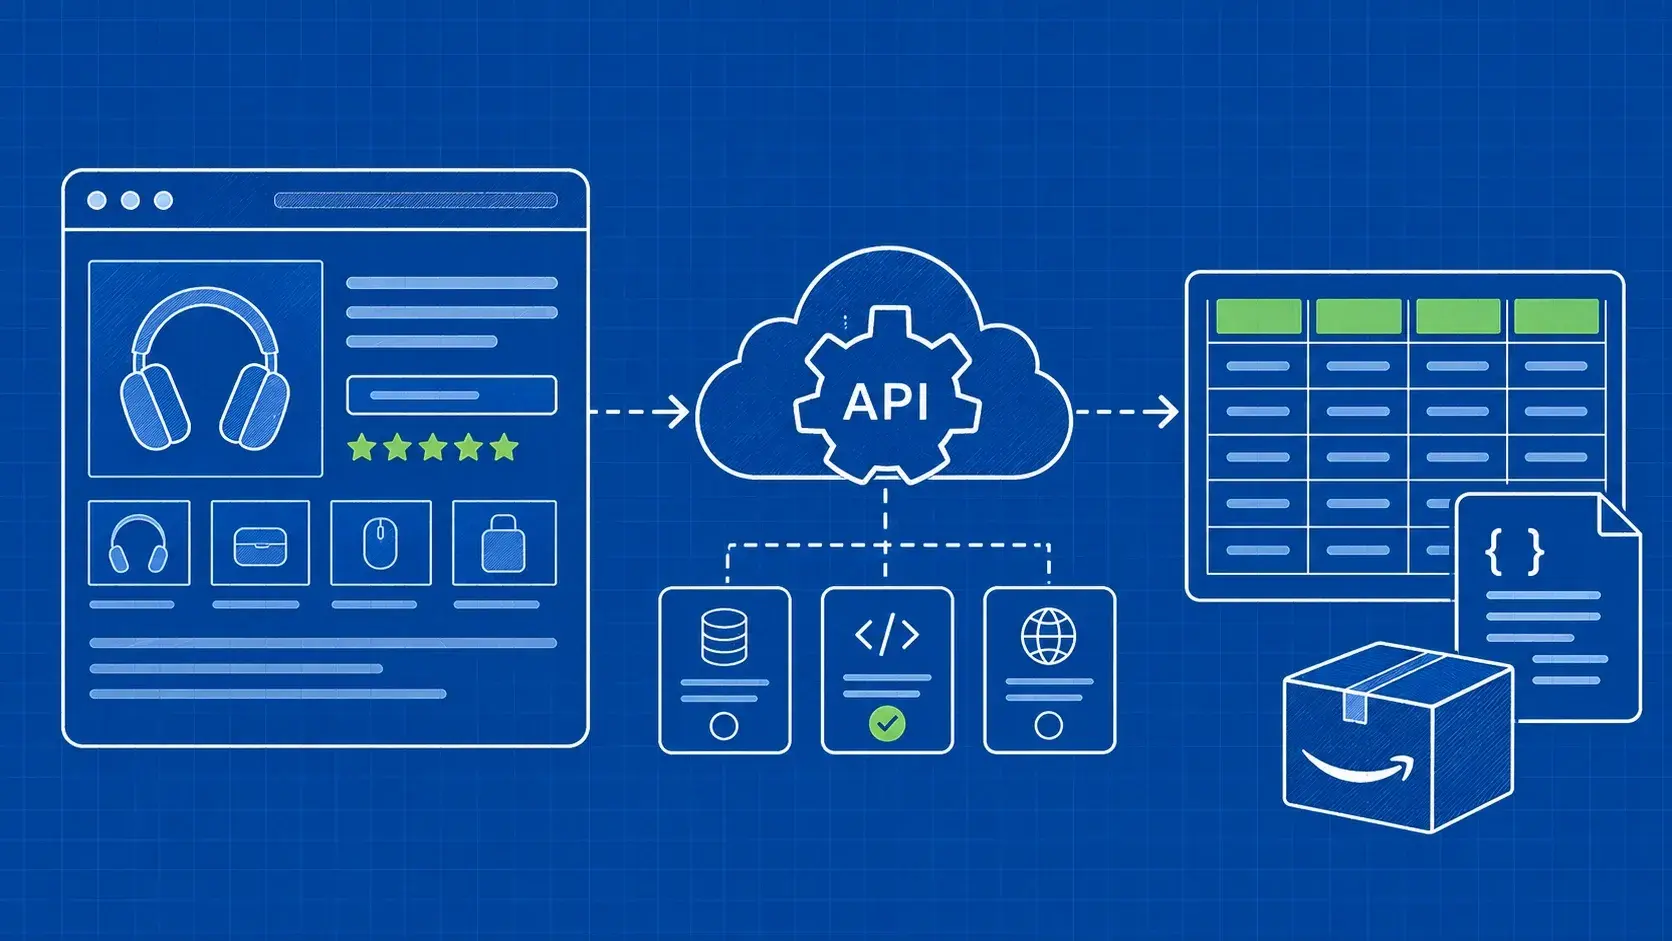
Supongamos que quieres una hoja de cálculo diaria con los precios de los productos. Una página de Amazon descargada te sigue dejando trabajo de extracción. Una respuesta analizada puede proporcionarte campos con nombre, pero debes comprobar qué representa cada precio y si el producto coincide con tu solicitud.

Hay tres puntos de partida útiles:

Enfoque

Lo que recibes

Lo que gestiona tu equipo

API general de recuperación de páginas

Contenido de la página para una URL proporcionada

Análisis, definiciones de campos, validación y almacenamiento

Punto de conexión dedicado de Amazon

Un esquema documentado de producto, búsqueda u oferta

Asignación de ese esquema a tu aplicación y comprobación de registros

Flujo de trabajo de recopilación gestionado

Tareas, programaciones y entrega en torno a la extracción

Definición de la carga de trabajo y aceptación del conjunto de datos entregado

Estas categorías pueden solaparse dentro de un mismo proveedor. Selecciona el punto final y el flujo de trabajo, no solo el nombre de la empresa. Un servicio que admita la representación en navegador también puede contar con un analizador de Amazon, pero esas capacidades no son intercambiables.

Para un primer proyecto de monitorización de precios, empieza con un punto final de producto específico si sus campos cubren tus necesidades. Para un analizador existente que gestione varios minoristas, la recuperación gestionada de páginas puede ser más adecuada. Para las recopilaciones nocturnas, comprueba el seguimiento de los trabajos y la entrega de resultados antes de optimizar el tiempo de respuesta.

Por lo tanto, la mejor API de scraping de Amazon es aquella que produce los resultados que necesitas con un trabajo de integración manejable. Nuestra comparativa de API de acceso web explica estas responsabilidades operativas con más detalle.

Cinco opciones de API que debes evaluar

Esta lista selecta refleja la documentación pública de los productos consultada en septiembre de 2026. Se trata de una comparación de las capacidades documentadas, no de una clasificación práctica basada en la velocidad o la tasa de éxito. Las recomendaciones de idoneidad que figuran a continuación son valoraciones editoriales; confírmalas con tu propia carga de trabajo de prueba.

WebScrapingAPI: recuperación gestionada para tu propio analizador sintáctico

La API de scraping acepta una URL de destino y gestiona la recuperación de la página, incluyendo el enrutamiento a través de proxy y la renderización opcional de JavaScript. Es una buena opción si ya extraes tú mismo los datos de productos de Amazon o si deseas una única interfaz de recuperación para varios sitios web.

Trata la respuesta como entrada para tu proceso de extracción. No des por sentado que el punto final de recuperación general devuelve un registro de producto de Amazon estandarizado. Tu aplicación seguirá teniendo que identificar el producto, interpretar los precios y validar los campos que falten.

La cuestión principal a la hora de elegir es la propiedad: ¿quieres mantener las reglas de análisis sintáctico mientras externalizas las operaciones de acceso? En caso afirmativo, prueba URL representativas de Amazon con tu analizador sintáctico actual y mide la proporción que se convierte en registros útiles. Si quieres campos de Amazon predefinidos de inmediato, incluye puntos finales específicos en la misma prueba.

ScrapingBee: puntos finales de producto, búsqueda y precios

La documentación actual de la API de Amazon enumera puntos finales independientes para productos, búsquedas y precios. La búsqueda de productos utiliza un ASIN, mientras que los parámetros de ubicación y mercado te permiten especificar el contexto de la solicitud. La documentación también distingue entre solicitudes ligeras y aquellas que obligan a la representación mediante JavaScript.

Esta es una opción ideal para una aplicación que desee respuestas de Amazon analizadas sin tener que partir de selectores HTML. Durante la evaluación, comprueba los campos exactos que devuelve cada punto final, en lugar de dar por sentado que una búsqueda de productos incluye todas las ofertas o detalles de búsqueda.

Presta atención al modo solicitado. Una solicitud más costosa puede merecer la pena cuando proporciona el contenido necesario, pero la representación debe tener un propósito cuantificable. Prueba la configuración adecuada menos costosa según tus reglas de aceptación antes de ampliarla.

Scrape.do: recopilación diferenciada de productos y ofertas de vendedores

La documentación del complemento de Amazon describe rutas específicas para detalles de productos, listados de ofertas y búsquedas, además de una ruta de HTML sin procesar. Esa separación resulta útil cuando necesitas distinguir la información del producto mostrada de las ofertas de los vendedores asociadas a él.

Considera esta opción cuando tu carga de trabajo incluya tanto la comparación de ofertas como el seguimiento de productos. La documentación de «Todas las ofertas» proporciona el contrato de respuesta relevante; revisa los campos de vendedor, envío y disponibilidad en función del uso que le vayas a dar.

Un punto final con nombre no elimina la necesidad de comprobar la cobertura. Incluye en la prueba productos con diferentes patrones de oferta y comprueba cómo aparecen los resultados vacíos o no disponibles. Verifica también la configuración de ubicaciones de entrega admitidas para cada mercado que realmente necesites.

Scrapingdog: flujos de trabajo de productos y búsquedas

La documentación actual sobre productos describe solicitudes basadas en ASIN con parámetros de mercado y localización. Su documentación sobre búsquedas abarca un punto final de búsqueda independiente. Los ejemplos de respuesta de productos incluyen texto de precio formateado y un símbolo de precio, lo que sirve como recordatorio útil de que la salida analizada puede seguir requiriendo normalización.

Esta es una opción recomendable cuando tu primer flujo de trabajo sea la búsqueda de productos o el descubrimiento basado en palabras clave y desees evaluar directamente una respuesta documentada de Amazon. Comprueba los nombres actuales de los parámetros; los ejemplos más antiguos pueden remitir a rutas de documentación diferentes.

Aprovecha tu periodo de prueba para examinar los identificadores de variantes, los precios que faltan y la ubicación solicitada. Un esquema con muchos campos solo resulta útil cuando los campos que necesita tu aplicación están presentes y se interpretan correctamente. Anota esos requisitos antes de comparar los tamaños de las respuestas.

ScraperAPI: tareas asíncronas de productos estructurados

La documentación sobre productos asíncronos describe cómo enviar un ASIN o varios ASIN, recibir información sobre el trabajo y recuperar el resultado una vez finalizado. También documenta las llamadas de retorno de webhooks, que pueden notificar a tu aplicación sobre un trabajo en lugar de mantener una solicitud abierta durante toda la recopilación.

Considera esta opción cuando tu flujo de trabajo se ejecute de forma natural por lotes. Evalúa tanto los datos como el ciclo de vida del trabajo: envío, finalización, fallo, recuperación de resultados y gestión de entregas duplicadas.

Un trabajo aceptado no es un conjunto de datos completo. Su aplicación debe conservar el identificador del trabajo y comprobar si la respuesta final cumple con sus reglas de registro. Para una actualización programada del catálogo, compare el tiempo total de finalización y los registros aceptados, no solo la rapidez con la que responde el punto final de envío.

Comprueba el mercado, las ofertas y el significado de los campos

Una observación útil de los precios necesita contexto. Registra el mercado de Amazon, la ubicación de entrega solicitada, la identidad del producto y la hora de recogida junto con el valor extraído. De lo contrario, un cambio en la configuración de la solicitud puede parecer un cambio de precio.

La localización de la entrega merece una comprobación independiente de la ubicación geográfica del proxy. Un parámetro de país puede seleccionar el origen de una solicitud; un parámetro de código postal puede controlar el contexto de entrega que muestra la página. Lee la documentación del punto final para saber qué comportamiento controla cada configuración. No des por sentado que dos proveedores utilizan nombres o significados idénticos para los parámetros.

Define tu registro antes de elegir la mejor API de scraping de Amazon. Para una tarea de supervisión sencilla, a continuación se muestra un formato interno ilustrativo, no una respuesta real de ningún proveedor:

{
  "marketplace": "amazon.com",
  "requested_asin": "EXAMPL1234",
  "resolved_asin": "EXAMPL1234",
  "delivery_postcode": "10001",
  "observed_at": "2026-09-10T10:00:00Z",
  "price_text": "$24.99",
  "currency": "USD",
  "availability": "in_stock",
  "seller_id": null
}

El ASIN y los valores anteriores son ficticios y sirven para mostrar la estructura. Mantén el identificador solicitado separado del identificador resuelto, de modo que una variante redirigida o seleccionada no se convierta silenciosamente en el mismo registro. Conserva el precio original mostrado al convertirlo a una cantidad numérica.

Para comparativas de ofertas, añade la identidad del vendedor, los gastos de envío, el estado del artículo y el contexto de la oferta que necesites. En el caso de los resultados de búsqueda de Amazon, conserva el contexto de la consulta, la página y la posición. Una respuesta con los detalles del producto y una fila de resultados de búsqueda describen observaciones diferentes.

Decide qué significa un valor ausente. Un precio nulo puede representar datos no disponibles; no debe convertirse en una oferta de cero dólares. Del mismo modo, el recuento de valoraciones no es el mismo campo que el número de reseñas escritas devueltas.

Estas definiciones facilitan la evaluación de la mejor API de extracción de datos de Amazon, ya que todos los candidatos deben cumplir el mismo contrato de registros.

Compara el coste por registro utilizable

La asignación de créditos indicada en un plan no equivale al recuento de registros de productos completos. La elección del punto final, la configuración de visualización, las solicitudes de ofertas adicionales y tus propias salidas rechazadas pueden alterar la cantidad útil que obtienes.

Por ejemplo, la solicitud de productos ligeros documentada en la lista de preselección cuesta cinco créditos, mientras que forzar la representación completa cuesta quince. Se trata de una diferencia de configuración dentro de un mismo servicio. Los créditos de distintos proveedores no son unidades de valor intercambiables.

Utiliza dos cálculos en tu comparación:

API cost per accepted record = API spend / accepted records
Effective cost per accepted record =
  (API spend + storage + allocated operating work) / accepted records

He aquí un ejemplo hipotético, no se trata de los precios de ningún proveedor. La opción A cuesta 30 $ por una prueba que genera 8 000 registros aceptados. Su coste de API es de 3,75 $ por cada 1 000 registros aceptados. La opción B cuesta 40 dólares y genera 12 000 registros aceptados, lo que supone unos 3,33 dólares por cada 1 000. En este ejemplo, el importe total más elevado supone un coste unitario menor.

Mantén el denominador constante. Comparar las páginas de productos de un proveedor con cada fila de resultados de búsqueda de otro da lugar a una cifra engañosa. Define si estás comprando una observación de producto, una oferta o un resultado de búsqueda, y cuenta solo los registros que cumplan las mismas reglas.

Antes de comprometerte, revisa la facturación por punto final, el tratamiento de las solicitudes fallidas, la concurrencia, los créditos no utilizados y las condiciones de exceso de consumo. Pregunta cómo se cobra una página recuperada con éxito pero incompleta. Comprueba los detalles del plan actual en lugar de reutilizar precios de un resumen anterior.

La mejor API de scraping de Amazon para tu presupuesto minimiza el coste de los datos utilizables con la frescura que necesitas. No tiene por qué ser la que ofrezca la suscripción mensual más barata ni la mayor asignación anunciada.

Realiza una pequeña prueba antes de decidirte

Aplica a cada candidato la misma carga de trabajo. Una prueba basada en un solo producto popular no te permitirá saber si un servicio gestiona tus categorías, mercados y casos extremos.

Crea una muestra que refleje el proyecto: productos comunes, productos con variantes, artículos no disponibles y las páginas de búsqueda u ofertas que necesites. Incluye cada mercado y contexto de entrega requerido. Elige un tamaño de muestra manejable para la inspección manual y tu límite de prueba disponible; no existe una cifra universal que garantice la fiabilidad.

Utiliza esta ficha de evaluación para seleccionar la mejor API de scraping de Amazon:

Comprobar

Aceptar cuando

Investigar cuando

Identidad

Los productos solicitados y devueltos coinciden con tu regla

Una variante o una redirección modifica el artículo

Ubicación

El mercado y el contexto de entrega coinciden

El resultado refleja una ubicación predeterminada

Campos obligatorios

Los valores están presentes y tienen sentido

Un precio está en blanco o una oferta carece de contexto

Actualidad

La observación se ajusta al intervalo de recopilación requerido

Los resultados almacenados en caché o retrasados no son adecuados

Finalización

Los trabajos previstos alcanzan un estado final registrado

Los envíos o los lotes parciales siguen sin resolverse

Coste

La facturación puede vincularse a las observaciones aceptadas

El recuento de solicitudes oculta los datos rechazados

Aplica la misma validación a todas las respuestas. Distingue entre errores de transporte, contenido inesperado de la página, errores de análisis sintáctico y errores de reglas de negocio. Una respuesta que llegue correctamente pero que contenga un producto erróneo debería fallar en la comprobación de identidad, aunque sea un JSON válido.

Inspecciona un subconjunto comparándolo con la página mostrada, utilizando una configuración de ubicación equivalente y una hora de recopilación cercana. Guarda suficiente contexto para explicar las diferencias más adelante. En el caso de valores que cambian rápidamente, una página vista mucho más tarde es una prueba poco sólida de que el registro anterior fuera erróneo.

Mide el tiempo de finalización desde el inicio de la recopilación hasta que se disponga de registros utilizables. En el caso de los sistemas asíncronos, incluye el tiempo de cola y la recuperación de resultados. Si informas sobre la latencia, incluye la carga de trabajo, la ventana de observación y el comportamiento de la cola lenta, en lugar de limitarte a un promedio.

Repite la muestra en otro momento relevante antes de considerar el resultado como estable. Considera los resultados de las pruebas como observaciones sobre esa carga de trabajo, no como garantías para todas las páginas de Amazon. Esta es la forma práctica de identificar la mejor API de scraping de Amazon para un proyecto específico sin basarte en las afirmaciones generales de clasificación de un proveedor.

Planifica el flujo de trabajo de recopilación

Una vez que la prueba genere registros fiables, define cómo se ejecutará la tarea periódica. Separa el descubrimiento de la actualización: encontrar nuevas URL de productos o ASIN es una tarea diferente a revisar una lista ya conocida.

Para la supervisión de precios, asigna un intervalo de actualización que se ajuste a la decisión que respaldan los datos. Agrupa el trabajo por mercado y contexto de solicitud para que la configuración sea clara. Evita aumentar la frecuencia simplemente porque haya más capacidad de concurrencia disponible.

Mantén un registro de cada observación programada y de su resultado final. Un reintento debería actualizar el estado de la tarea sin crear de forma silenciosa observaciones comerciales duplicadas. Limita los reintentos, conserva el contexto útil del error y haz que las tareas agotadas sean visibles para la persona que gestiona la recopilación.

Si un proveedor entrega resultados mediante callbacks, planifica notificaciones repetidas y una finalización retrasada. Almacena el identificador de tarea del proveedor junto a tu identificador de tarea interno. Esa conexión ayuda a los equipos de soporte a investigar un lote fallido sin tener que adivinar qué solicitud lo provocó.

Asigna versiones a tus reglas de normalización. Un cambio en la asignación de campos debe distinguirse de un cambio en los datos de origen. Conserva el contexto necesario para la depuración, al tiempo que estableces una política de retención deliberada para las respuestas almacenadas.

Por último, asigna la responsabilidad de los cambios en el analizador, la revisión de la facturación y los trabajos incompletos. La mejor API de scraping de Amazon reduce el trabajo de obtención de datos, pero alguien sigue teniendo que decidir si las observaciones resultantes son adecuadas para la aplicación. Incorpora esa decisión al flujo de trabajo antes de ampliar la recopilación.

Puntos clave

  • Elige primero el contrato de salida. El contenido de la página, los campos de producto analizados, las ofertas de los vendedores y los trabajos de recopilación completados resuelven diferentes partes de la tarea. Compara los puntos finales que abordan el mismo requisito.
  • Mantén el contexto del producto y la ubicación en cada observación. Un registro de precios útil necesita algo más que un valor; el artículo solicitado, la variante seleccionada, el mercado y el momento de la recopilación lo hacen interpretable.
  • Calcula el coste utilizando los registros aceptados. Incluye en la evaluación los cambios de configuración y los resultados rechazados; a continuación, ten en cuenta el trabajo que tu equipo seguirá realizando.
  • Considera una prueba como evidencia de una carga de trabajo definida. Utiliza los mismos datos de entrada y comprobaciones para cada candidato, analiza los fallos y repite la muestra antes de dar por válidos los resultados.

Preguntas frecuentes

¿Puedo recuperar precios históricos con un nuevo rastreo?

Una nueva observación no puede determinar lo que mostraba una página el mes pasado. Si necesitas una serie histórica, recopila observaciones y márcalas con la fecha a lo largo del tiempo, o evalúa un conjunto de datos históricos independiente con cobertura documentada. Distingue entre el momento en que un proveedor recopiló un valor y el momento en que lo descargaste. No rellenes las fechas que faltan presentando el precio de hoy como una observación anterior.

¿Cómo debo proteger mis credenciales de API?

Guarda las credenciales en un almacén de secretos del lado del servidor o en la configuración del entorno. Evita incrustarlas en el código del navegador, hojas de cálculo compartidas, capturas de pantalla o repositorios públicos. Oculta las credenciales en los registros de solicitudes, especialmente cuando una API utilice autenticación mediante cadena de consulta. Limita el acceso a las personas y servicios que ejecutan la recopilación, y sustituye una clave si se ha visto expuesta.

¿Pueden los recuentos de valoraciones extraídos indicarme las ventas exactas?

No. Los recuentos de valoraciones y los totales de ventas son medidas diferentes. La relación que se deduce entre ellos es un modelo de estimación, no un registro de ventas extraído. Si utilizas un modelo de este tipo, indica que el resultado es una estimación y explica sus supuestos. Mantén los campos de origen observados separados de las métricas calculadas para que los lectores puedan distinguir qué valores proceden directamente de la colección.

¿Cómo puedo facilitar el cambio de proveedor?

Mantén los parámetros de solicitud y las asignaciones de respuesta específicos de cada proveedor dentro de un pequeño ámbito de integración. Almacena un formato de registro interno estable y comprueba cada asignación con respuestas representativas guardadas. Al sustituir un proveedor, compara el significado de los campos, además de sus nombres. Documenta las diferencias de forma explícita en lugar de forzar una nueva respuesta en un campo antiguo que tenga otro significado.

Conclusión

La mejor API de scraping de Amazon es aquella que proporciona las observaciones que tu proyecto necesita con un coste y un modelo operativo que puedas mantener. Empieza por el resultado: un registro de producto, una oferta de vendedor, un resultado de búsqueda o el contenido de una página para un analizador sintáctico existente. A continuación, haz explícitos el contexto de la solicitud y las reglas de aceptación.

Utiliza la lista de preseleccionados para elegir un pequeño número de candidatos que se ajusten a esos requisitos. Ejecuta la misma muestra en cada uno de ellos, examina los registros devueltos y calcula el coste de los resultados aceptados. Mantén las capacidades documentadas separadas de lo que demuestra la prueba. Esa distinción te ayudará a tomar una decisión fundamentada a medida que aumente tu volumen de trabajo.

Si la recuperación gestionada de páginas se adapta a tu arquitectura, evalúa la API Scraper de WebScrapingAPI con URL representativas de Amazon y tus propias reglas de extracción. Utiliza la misma lista de verificación de aceptación que aplicas a los puntos finales dedicados de Amazon, de modo que la decisión refleje el trabajo que tu aplicación realmente necesita.

Antes de ampliar el trabajo, guarda la muestra, su configuración y las reglas de validación. Esos elementos se convertirán en tu referencia cuando cambie un punto de conexión, desaparezca un campo o se incorpore un nuevo proveedor a la comparación.

Acerca del autor

Robert Sfichi, Desarrollador full-stack @ WebScrapingAPI

Robert Sfichi

Desarrollador full-stack

Robert Sfichi forma parte del equipo de WebScrapingAPI, donde contribuye al desarrollo del producto y ayuda a crear soluciones fiables que dan soporte a la plataforma y a sus usuarios.

Raspado alternativo de datos para las finanzas: Cómo los datos web dan ventaja a los inversores
Casos de uso

Raspado alternativo de datos para las finanzas: Cómo los datos web dan ventaja a los inversores

TL;DR: El scraping de datos alternativos utiliza técnicas de recopilación web para reunir conjuntos de datos no tradicionales (precios de productos, opiniones, ofertas de empleo, registros normativos) que revelan señales del mercado antes de que aparezcan en los informes de resultados. Esta guía le guiará a través de las fuentes de datos de mayor valor, cómo crear canales de calidad financiera, la validación de la calidad de los datos y las salvaguardas de cumplimiento que necesita para mantenerse en el lado correcto de la ley.

Mihnea-Octavian Manolache20 min read
Leer artículo
¿Qué son los datos financieros? Tipos, métodos de recopilación y herramientas de análisis
Casos de uso

¿Qué son los datos financieros? Tipos, métodos de recopilación y herramientas de análisis

TL;DR: Los datos financieros son la recopilación de registros cuantitativos (ingresos, gastos, activos, pasivos, flujo de caja) que las organizaciones y los particulares utilizan para tomar decisiones económicas fundamentadas. Esta guía desglosa los cuatro estados financieros básicos, compara las fuentes de datos tradicionales y alternativas, recorre los métodos de recopilación modernos y cubre las herramientas en las que se basan los profesionales para el análisis.

Suciu Dan16 min read
Leer artículo
XPath vs Selectores CSS: Elegir el correcto
Casos de uso

XPath vs Selectores CSS: Elegir el correcto

TL;DR: Tanto XPath como los selectores CSS localizan elementos DOM, pero resuelven problemas diferentes. Los selectores CSS son más rápidos y más legibles para selecciones sencillas. XPath gana cuando se necesita recorrer el DOM en cualquier dirección, hacer coincidir contenido de texto o manejar lógica condicional compleja. La mayoría de los proyectos de producción se benefician del uso estratégico de ambos.

Mihai Maxim15 min read
Leer artículo

Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.