Saltar al contenido
Empezar gratis

Perfil del autor

Sergiu Inizian

Redactor de contenidos técnicos6 artículos

Sergiu Inizian es redactor de contenidos técnicos en WebScrapingAPI, donde elabora contenidos claros y prácticos que ayudan a los desarrolladores a comprender el producto y a utilizarlo de forma eficaz.

Sergiu Inizian, Redactor de contenidos técnicos @ WebScrapingAPI

Artículos publicados

6 artículos

proxy infrastructurenews and media monitoringScience of Web ScrapingOtherUse Cases

Artículos publicados

Cheerio vs Titiritero: Cómo elegir la herramienta adecuada
Guías

Cheerio vs Titiritero: Cómo elegir la herramienta adecuada

TL;DR: Cheerio es un analizador HTML ligero; Puppeteer maneja un navegador Chromium real. Usa Cheerio cuando los datos ya estén en el HTML crudo, Puppeteer cuando JavaScript los renderice, y combínalos cuando una página con mucho JS tenga muchos campos que extraer por visita.

Sergiu Inizian9 min read
Leer artículo
Los mejores proxies móviles para web scraping en 2026: 9 proveedores clasificados
La ciencia del web scraping

Los mejores proxies móviles para web scraping en 2026: 9 proveedores clasificados

TL;DR: Compara 9 proveedores de proxies móviles para scraping por precio por GB o por puerto, segmentación por operador y ASN, 5G, sesiones fijas y pruebas, a octubre de 2026.

Sergiu Inizian26 min read
Leer artículo
Web Scraping sin que te bloqueen: Manual 2026
La ciencia del web scraping

Web Scraping sin que te bloqueen: Manual 2026

TL;DR: Los bloqueos modernos se producen en cuatro capas: red, firma de solicitud, navegador y comportamiento. Diagnostique primero la capa utilizando códigos de estado y páginas de desafío y, a continuación, arréglela con la combinación adecuada de proxies residenciales rotativos, cabeceras de navegador, suplantación TLS, navegadores invisibles y tiempos similares a los humanos. Cuando el volumen o la sofisticación del anti-bot hagan que el bricolaje no sea rentable, descargue la capa de solicitud a una API gestionada.

Sergiu Inizian39 min read
Leer artículo
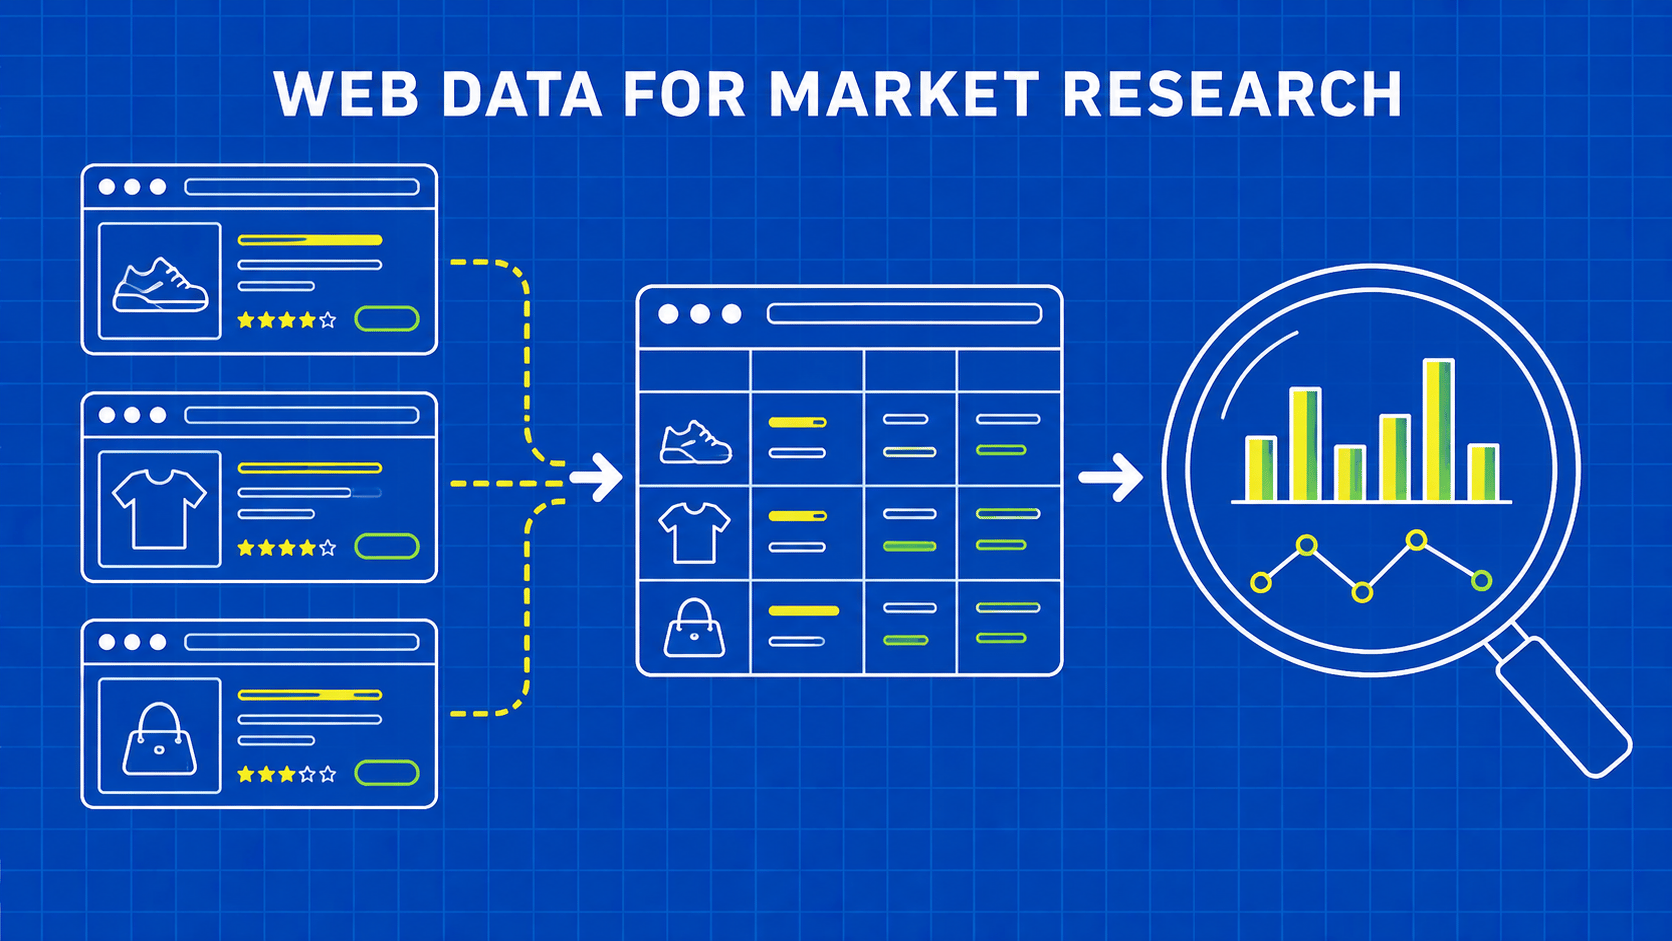
Extracción de datos de la web para estudios de mercado: guía para desarrolladores
Casos de uso

Extracción de datos de la web para estudios de mercado: guía para desarrolladores

TL;DR: Crea conjuntos de datos sobre la competencia en los que puedas confiar: define tu muestra, compara productos, valida precios y elabora informes con tus observaciones sobre el mercado sin exagerar los datos.

Sergiu Inizian16 min read
Leer artículo
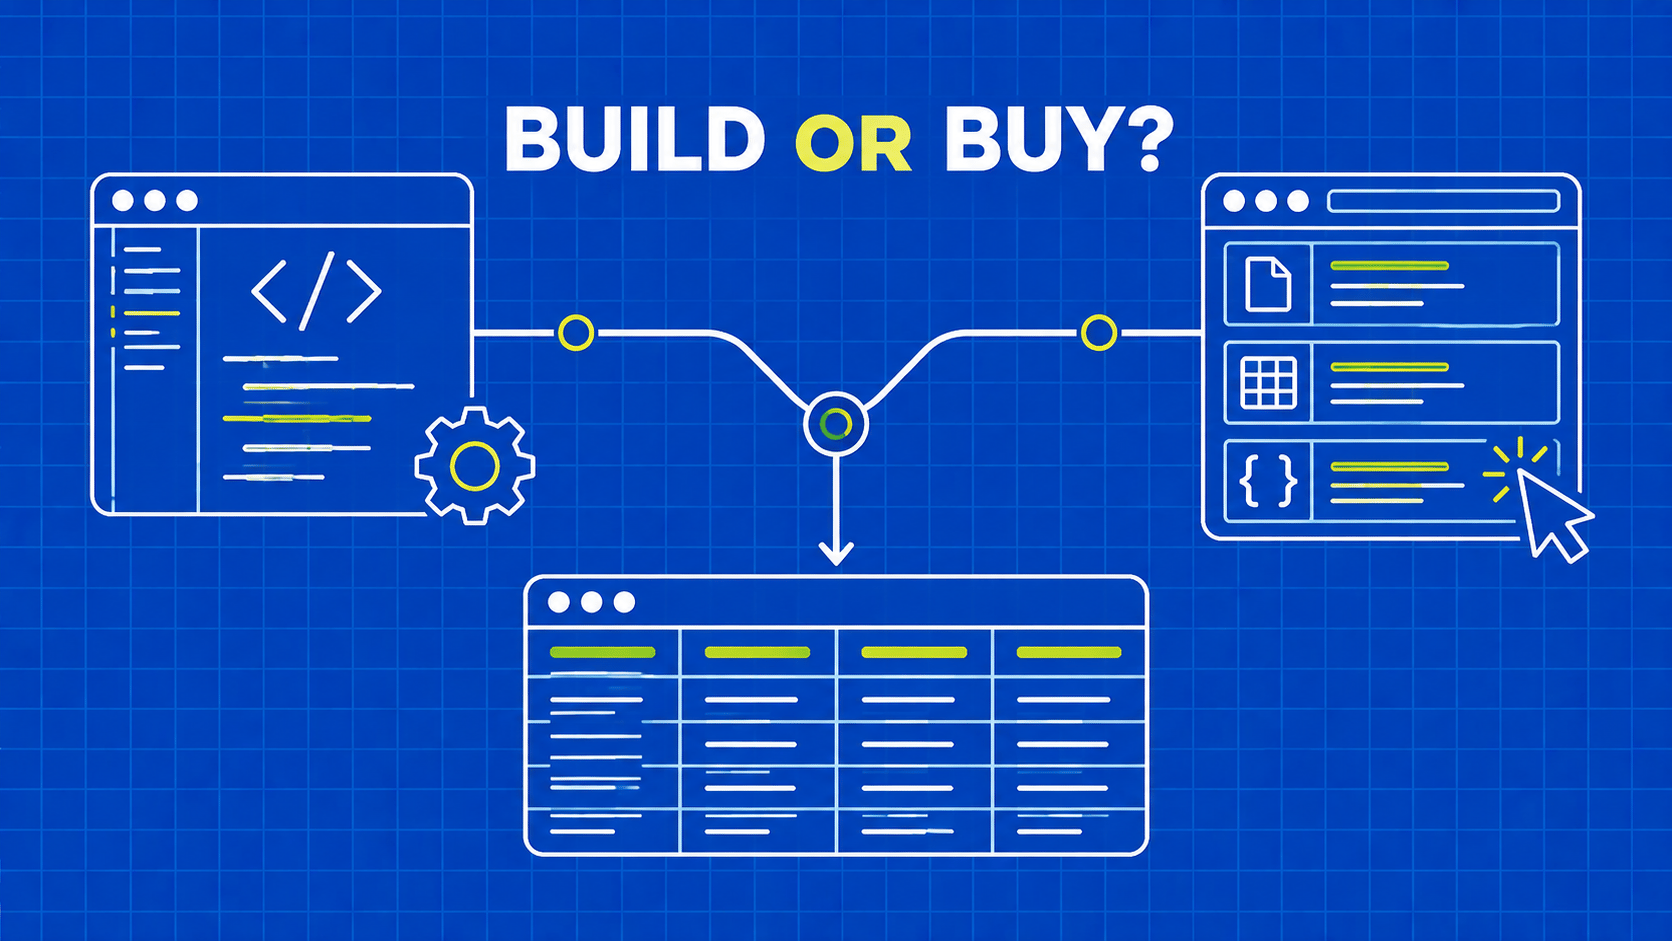
Scraper personalizado frente a herramientas de extracción de datos: ¿crearlo o comprarlo?
La ciencia del web scraping

Scraper personalizado frente a herramientas de extracción de datos: ¿crearlo o comprarlo?

TL;DR: Decide si conviene desarrollar, adquirir o combinar herramientas de extracción de datos utilizando un contrato de datos, una comparación de titularidad, un modelo de coste total y una prueba piloto práctica.

Sergiu Inizian17 min read
Leer artículo
¿Qué es el Web Scraping? Guía práctica para desarrolladores
La ciencia del web scraping

¿Qué es el Web Scraping? Guía práctica para desarrolladores

TL;DR: El web scraping es la extracción automatizada de datos web públicos en un formato estructurado que realmente se puede utilizar, como JSON o una hoja de cálculo. Esta guía explica qué es el web scraping a nivel de definición, el proceso de request-and-parse que hay detrás, dónde lo ponen en práctica los equipos, el espectro de herramientas, desde las API sin código a las gestionadas, y cómo mantenerse en el lado correcto de las defensas anti-bot y de la ley.

Sergiu Inizian22 min read
Leer artículo

Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.