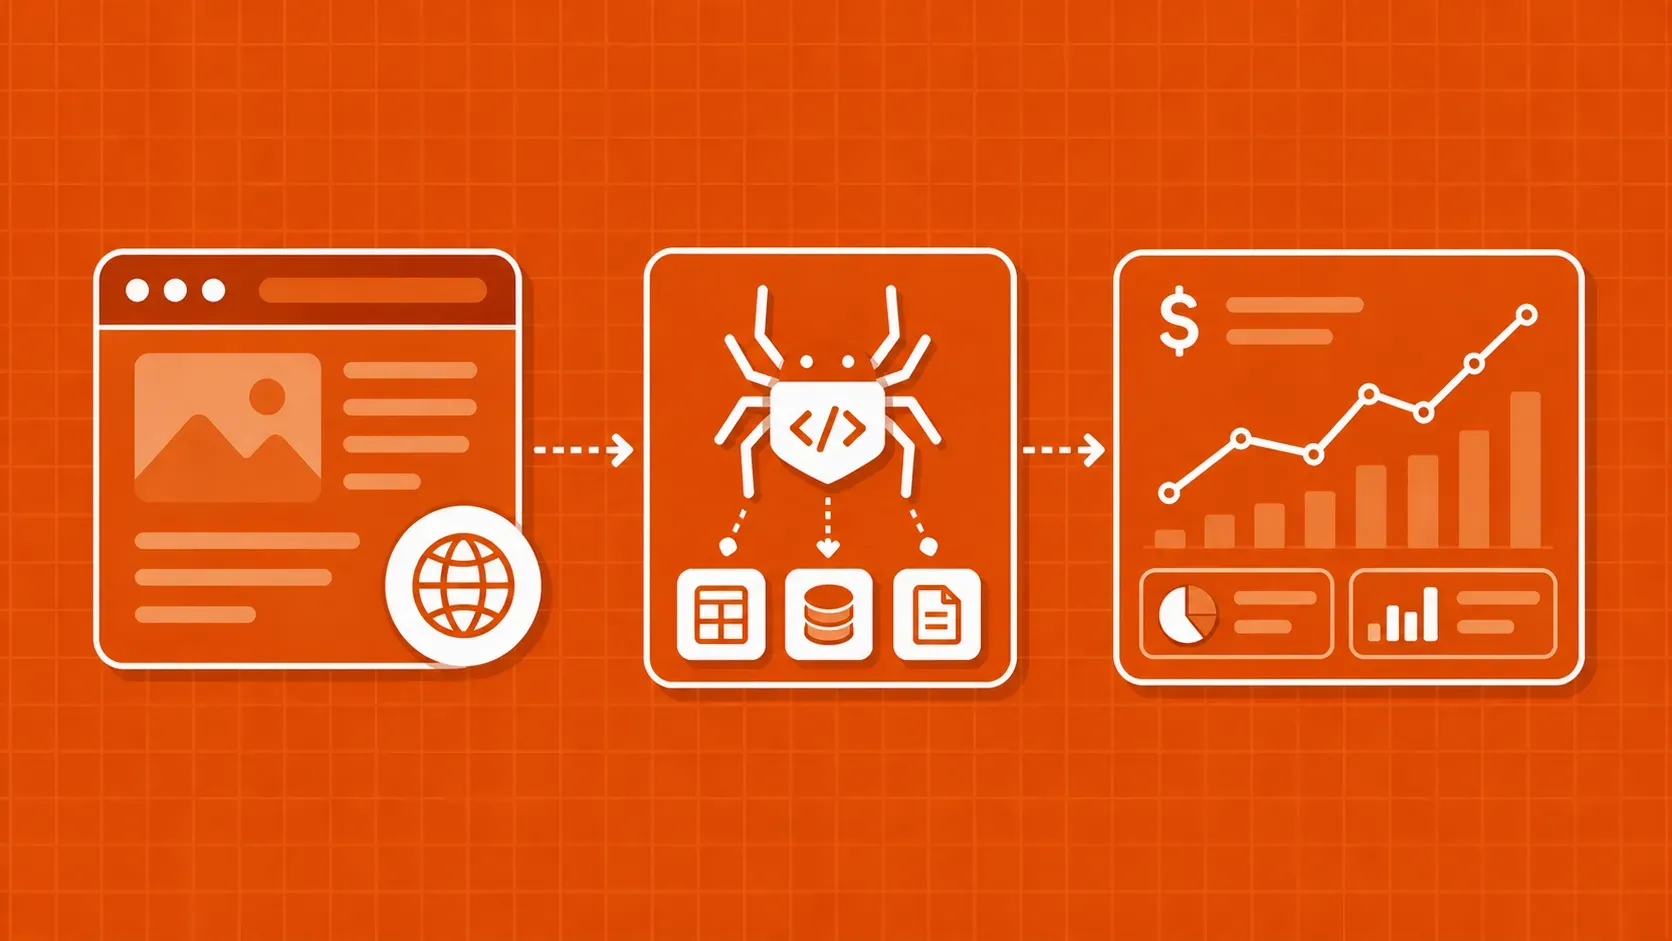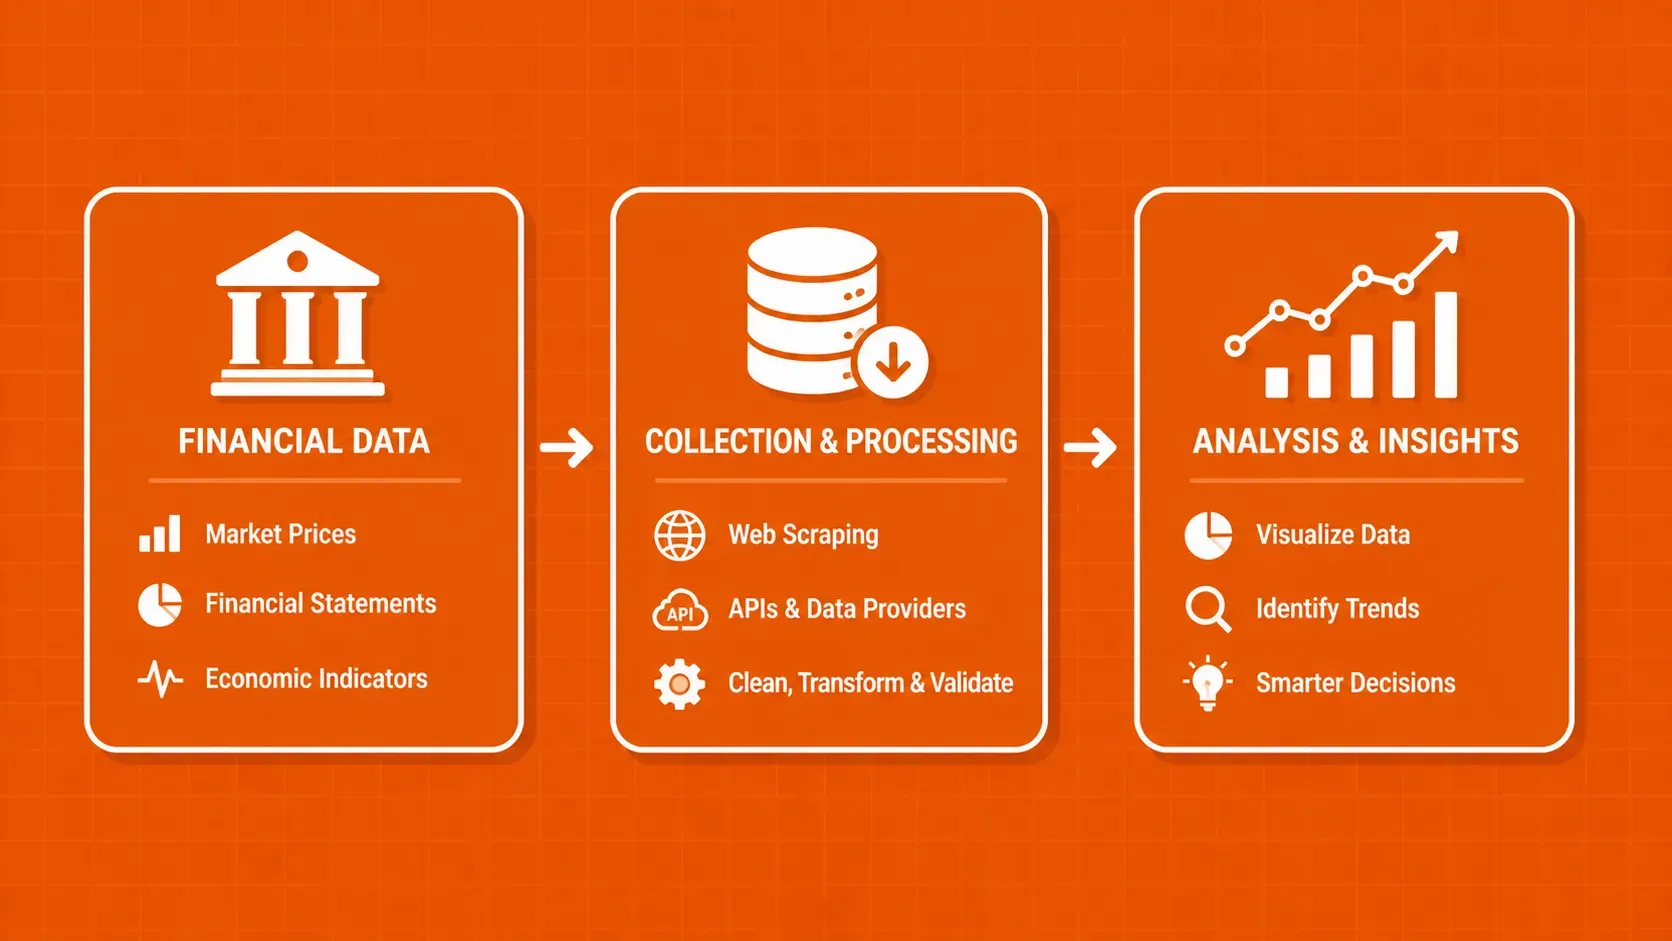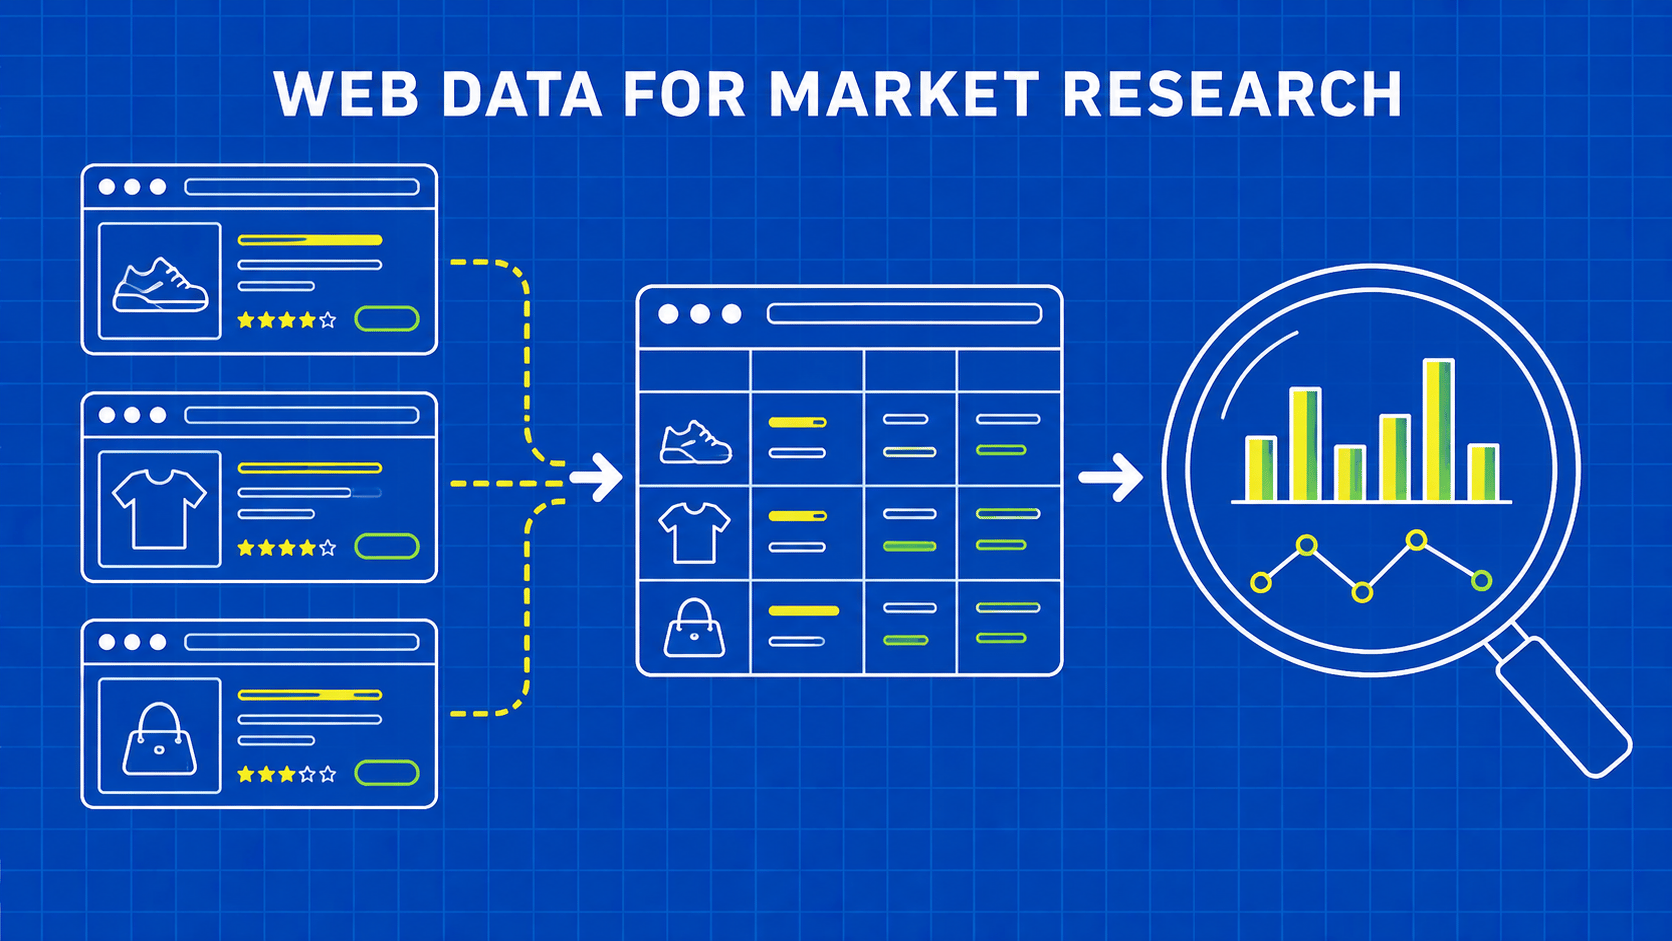
En resumen: El web scraping puede convertir las páginas públicas de productos en observaciones repetibles sobre precios, surtido y disponibilidad. Un estudio de mercado útil requiere una muestra definida, productos comparables, marcas de tiempo y controles de calidad; los listados obtenidos mediante web scraping por sí solos no revelan las ventas, la demanda ni la cuota de mercado.
El web scraping para estudios de mercado consiste en la recopilación automatizada de datos de sitios web con el fin de responder a una pregunta concreta sobre un mercado o sus participantes. Para los desarrolladores, el resultado final es un conjunto de datos con observaciones trazables y límites claros, no simplemente una gran recopilación de páginas.
Pensemos en un minorista que compara sus precios con las ofertas públicas de la competencia. Un panel de control puede mostrar que el precio medio de otro minorista ha bajado esta semana. Eso podría reflejar reducciones de precio reales, productos más baratos recién incluidos en el catálogo, la ausencia de productos caros o un analizador sintáctico que ha empezado a leer precios a plazos. Cada explicación conduce a una decisión empresarial diferente.
Una investigación fiable distingue esas posibilidades antes de presentar una tendencia. Es necesario saber qué abarca la muestra, qué representa cada registro y qué diferencias se consideran comparables. Una página de producto es una prueba de una oferta anunciada en condiciones concretas, no una prueba de una transacción completada.
Esta guía se centra en la investigación de productos y precios de la competencia porque pone de manifiesto claramente los problemas de medición. Definirás la pregunta de investigación, diseñarás un esquema de observación, normalizarás los precios sin perder el contexto y validarás la recopilación antes de presentar los resultados. La misma disciplina se aplica a los directorios de servicios, las ofertas de empleo y otras señales del mercado público.