Saltar al contenido
Empezar gratis

Perfil del autor

Sorin-Gabriel Marica

Desarrollador full-stack8 artículos

Sorin Marica es ingeniero Full Stack y DevOps en WebScrapingAPI, donde se encarga de desarrollar funciones para los productos y de mantener la infraestructura que garantiza el buen funcionamiento de la plataforma.

Sorin-Gabriel Marica, Desarrollador full-stack @ WebScrapingAPI

Artículos publicados

8 artículos

Python web scrapingGuidesEngineering

Artículos publicados

Web Scraping con Node-Unblocker: Guía práctica
La ciencia del web scraping

Web Scraping con Node-Unblocker: Guía práctica

TL;DR: Node-unblocker convierte una aplicación Express en un proxy HTTP con prefijo URL que puedes hackear. Esta guía de node unblocker para web scraping explica cómo instalarlo, conectar middlewares de solicitud y respuesta, rotar instancias, desplegar en Docker o Heroku y reconocer el punto en el que una API de scraping gestionada es la respuesta más sensata.

Sorin-Gabriel Marica13 min read
Leer artículo
Web Scraping con PHP: Guía práctica de bibliotecas, código y buenas prácticas
Guías

Web Scraping con PHP: Guía práctica de bibliotecas, código y buenas prácticas

TL;DR: PHP es un lenguaje perfectamente apto para el web scraping, gracias a extensiones integradas como cURL y DOMDocument, además de un rico ecosistema Composer que incluye Guzzle, Symfony DomCrawler y Symfony Panther para la navegación headless. Esta guía te guía a través del flujo de trabajo completo: obtención de páginas, análisis sintáctico de HTML, almacenamiento de resultados en CSV/JSON/MySQL, gestión de errores y evitación de bloqueos.

Sorin-Gabriel Marica19 min read
Leer artículo
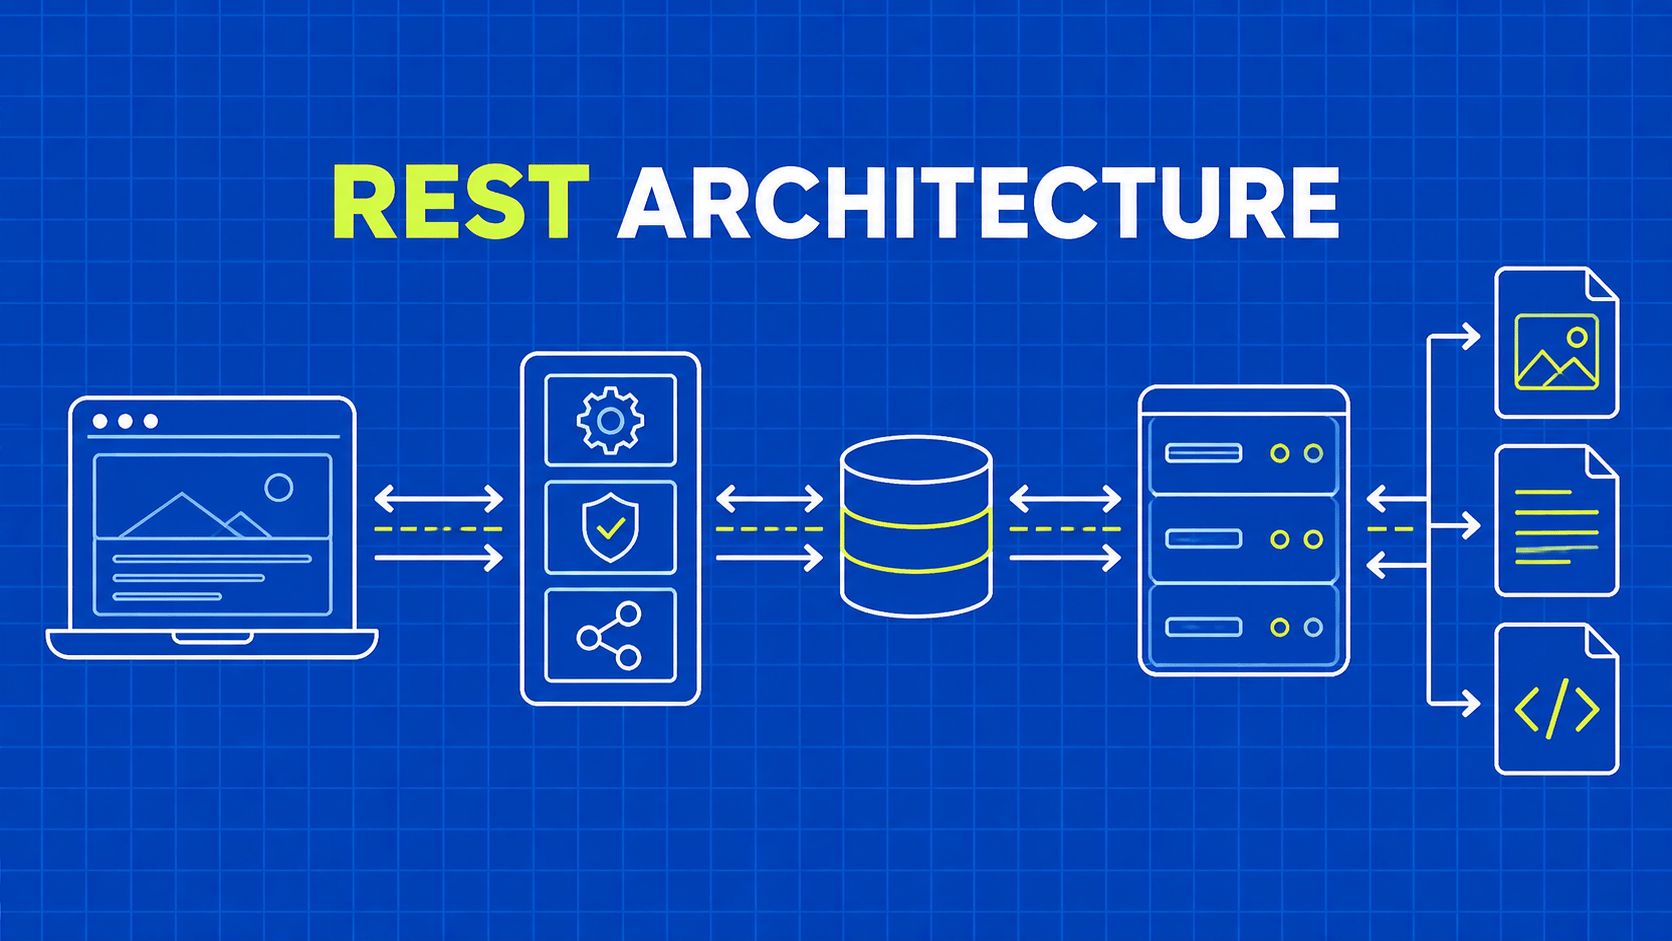
Restricciones de la arquitectura de la API REST: una guía de diseño
Ingeniería

Restricciones de la arquitectura de la API REST: una guía de diseño

TL;DR: Utiliza una integración de catálogo para examinar las seis restricciones de REST, distinguir el estado del recurso del estado de la conversación y probar las cuatro partes de la interfaz uniforme.

Sorin-Gabriel Marica16 min read
Leer artículo
Aprende a utilizar Node-Fetch (NPM) para realizar solicitudes HTTP en Node.js
Guías

Aprende a utilizar Node-Fetch (NPM) para realizar solicitudes HTTP en Node.js

TL;DR: Descubre cómo utilizar el recién lanzado node-fetch para realizar solicitudes HTTP directamente desde Node.js. Node-fetch es el equivalente a la API fetch en JavaScript.

Sorin-Gabriel Marica9 min read
Leer artículo
Alternativas a PhantomJS: qué utilizar ahora y cómo realizar la migración
Guías

Alternativas a PhantomJS: qué utilizar ahora y cómo realizar la migración

TL;DR: PhantomJS dejó de desarrollarse en 2018. Elige un sustituto en función de lo que hiciera tu script, asigna las llamadas a PhantomJS a Playwright o Puppeteer y elimina las dependencias antiguas.

Sorin-Gabriel Marica21 min read
Leer artículo
Web scraping con Go: cómo crear un rastreador HTML fiable
Guías

Web scraping con Go: cómo crear un rastreador HTML fiable

TL;DR: Crea un scraper en Go que extraiga registros de libros en formato JSON. Sigue un ejemplo probado con goquery y, a continuación, planifica la paginación, el uso de Colly, la visualización en el navegador y la gestión de errores.

Sorin-Gabriel Marica15 min read
Leer artículo
Extracción de datos web en C# con HttpClient, AngleSharp y Playwright
Guías

Extracción de datos web en C# con HttpClient, AngleSharp y Playwright

TL;DR: En resumen: Para hacer web scraping en C#, empieza en .NET 10 con el HttpClient integrado para descargar páginas y AngleSharp para analizar HTML con selectores CSS. Elige HtmlAgilityPack si prefieres XPath o mantienes código antiguo, y añade Playwright para .NET cuando JavaScript construye la página. Esta guía crea un scraper con reintentos respetuosos, rastreo acotado, exportación a CSV y JSON y pruebas sin conexión.

Sorin-Gabriel Marica30 min read
Leer artículo
Tutorial de BeautifulSoup: Construir un raspador real de Python desde cero
Guías

Tutorial de BeautifulSoup: Construir un raspador real de Python desde cero

TL;DR: Este tutorial de BeautifulSoup te guía a través de un scraper Python completo, desde la instalación pip hasta un script reforzado que pagina Hacker News, exporta a CSV y JSON, y se mantiene lo suficientemente educado como para no ser bloqueado. Cada fragmento es ejecutable, y señalamos los momentos exactos en los que BeautifulSoup es la herramienta equivocada.

Sorin-Gabriel Marica19 min read
Leer artículo

Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.