Saltar al contenido
Empezar gratis

Perfil del autor

Suciu Dan

Cofundador25 artículos

Suciu Dan es cofundador de WebScrapingAPI y escribe guías prácticas dirigidas a desarrolladores sobre el scraping web con Python, el scraping web con Ruby y las infraestructuras de proxy.

Suciu Dan, Cofundador @ WebScrapingAPI

Artículos publicados

25 artículos

Python web scrapingRuby web scrapingproxy infrastructureanti-bot resilienceGuidesScience of Web ScrapingUse Cases

Artículos publicados

Extracción de datos web con AWS Lambda: guía para Python y Java 2026
Guías

Extracción de datos web con AWS Lambda: guía para Python y Java 2026

TL;DR: En resumen: el web scraping con AWS Lambda funciona mejor cuando cada invocación es breve, está delimitada y se puede reintentar de forma independiente. Empieza con HTTP directo, AWS SAM y S3, y añade SQS, contenedores, renderización en navegador, proxies o una capa de recuperación gestionada solo cuando la carga de trabajo demuestre que los necesita.

Suciu Dan33 min read
Leer artículo
Cómo utilizar GoSpider: rastrear, depurar URL y extraer datos
Guías

Cómo utilizar GoSpider: rastrear, depurar URL y extraer datos

TL;DR: En resumen: GoSpider es un rastreador de línea de comandos diseñado para descubrir URL, no un extractor completo de datos estructurados. Esta guía sobre cómo utilizar GoSpider muestra cómo realizar un rastreo limitado, gestionar correctamente los resultados, pasar los datos de Colly a CSV y seguir una ruta de diagnóstico para respuestas 403 o páginas que requieren renderización con JavaScript.

Suciu Dan24 min read
Leer artículo
Cómo raspar Redfin: Guía Python de Datos Inmobiliarios
Guías

Cómo raspar Redfin: Guía Python de Datos Inmobiliarios

TL;DR: Redfin expone puntos finales de API ocultos que devuelven JSON estructurado para los listados de propiedades, lo que permite omitir por completo el frágil análisis HTML. Esta guía te guía a través de la construcción de un raspador de Python que extrae datos de alquiler y venta, busca por ubicación, supervisa los nuevos listados a través de mapas de sitio XML y exporta resultados limpios a CSV o JSON.

Suciu Dan14 min read
Leer artículo
Cómo analizar JSON en Python: desde respuestas de API hasta JSON oculto en páginas web
Guías

Cómo analizar JSON en Python: desde respuestas de API hasta JSON oculto en páginas web

TL;DR: Analiza JSON en Python con json.loads y json.load, corrige errores de decodificación, valida datos anidados, procesa archivos de gran tamaño y extrae JSON-LD o __NEXT_DATA__ ocultos en páginas web, además de los envoltorios de WebScrapingAPI.

Suciu Dan13 min read
Leer artículo
Tutorial de Python de Nodriver: Extracción de datos de navegadores de forma sigilosa, desde el primer script hasta la puesta en producción
La ciencia del web scraping

Tutorial de Python de Nodriver: Extracción de datos de navegadores de forma sigilosa, desde el primer script hasta la puesta en producción

TL;DR: En resumen: Nodriver es una biblioteca asíncrona de Python que controla Chromium mediante el Chrome DevTools Protocol, sin Selenium ni el binario chromedriver. Úsala cuando un navegador sigiloso autoalojado, más parecido a una sesión real de Chrome, sea mejor opción que una pila WebDriver, pero ten en cuenta que por sí sola no elimina los riesgos de IP, TLS o comportamiento. Este tutorial va desde un primer script hasta la producción en contenedores y una Browser API alojada.

Suciu Dan15 min read
Leer artículo
Cómo gestionar las URL de redireccionamiento de Google /goto y los tokens CAES en un rastreador de SERP
La ciencia del web scraping

Cómo gestionar las URL de redireccionamiento de Google /goto y los tokens CAES en un rastreador de SERP

TL;DR: En resumen: Las URL /goto de Google con un token CAES, y los envoltorios /url más antiguos, son capas de redirección, no destinos, así que un scraper de SERP que trata cada href como final rompe el seguimiento de posiciones y los almacenes de enlaces. Prefiere una API de SERP estructurada cuando devuelva los enlaces de destino. Si tienes que analizar HTML, clasifica cada href, elimina redirecciones duplicadas y resuélvelas con un GET simple. No descifres CAES.

Suciu Dan13 min read
Leer artículo
Las 10 mejores herramientas de web scraping con IA para 2026
Guías

Las 10 mejores herramientas de web scraping con IA para 2026

TL;DR: No hay ningún scraper de IA que sea ideal para todas las cargas de trabajo. Compara 11 herramientas según el método de extracción, el tipo de usuario, las operaciones y el coste, y luego utiliza un plan de pruebas práctico para elegir la que mejor se adapte a tus necesidades.

Suciu Dan25 min read
Leer artículo
XPath Web Scraping: Guía práctica con ejemplos en Python
Guías

XPath Web Scraping: Guía práctica con ejemplos en Python

TL;DR: XPath es un lenguaje de consulta para navegar árboles HTML/XML por ruta, atributo o contenido de texto. Esta guía cubre la sintaxis XPath, ejes y funciones, a continuación, muestra raspadores Python de trabajo con lxml y Selenium. También obtendrá una hoja de trucos consolidada y una sección de solución de problemas para los errores más comunes de XPath.

Suciu Dan11 min read
Leer artículo
Cabeceras de Respuesta HTTP en cURL: Cada Bandera, Técnica y Receta de Scripting
La ciencia del web scraping

Cabeceras de Respuesta HTTP en cURL: Cada Bandera, Técnica y Receta de Scripting

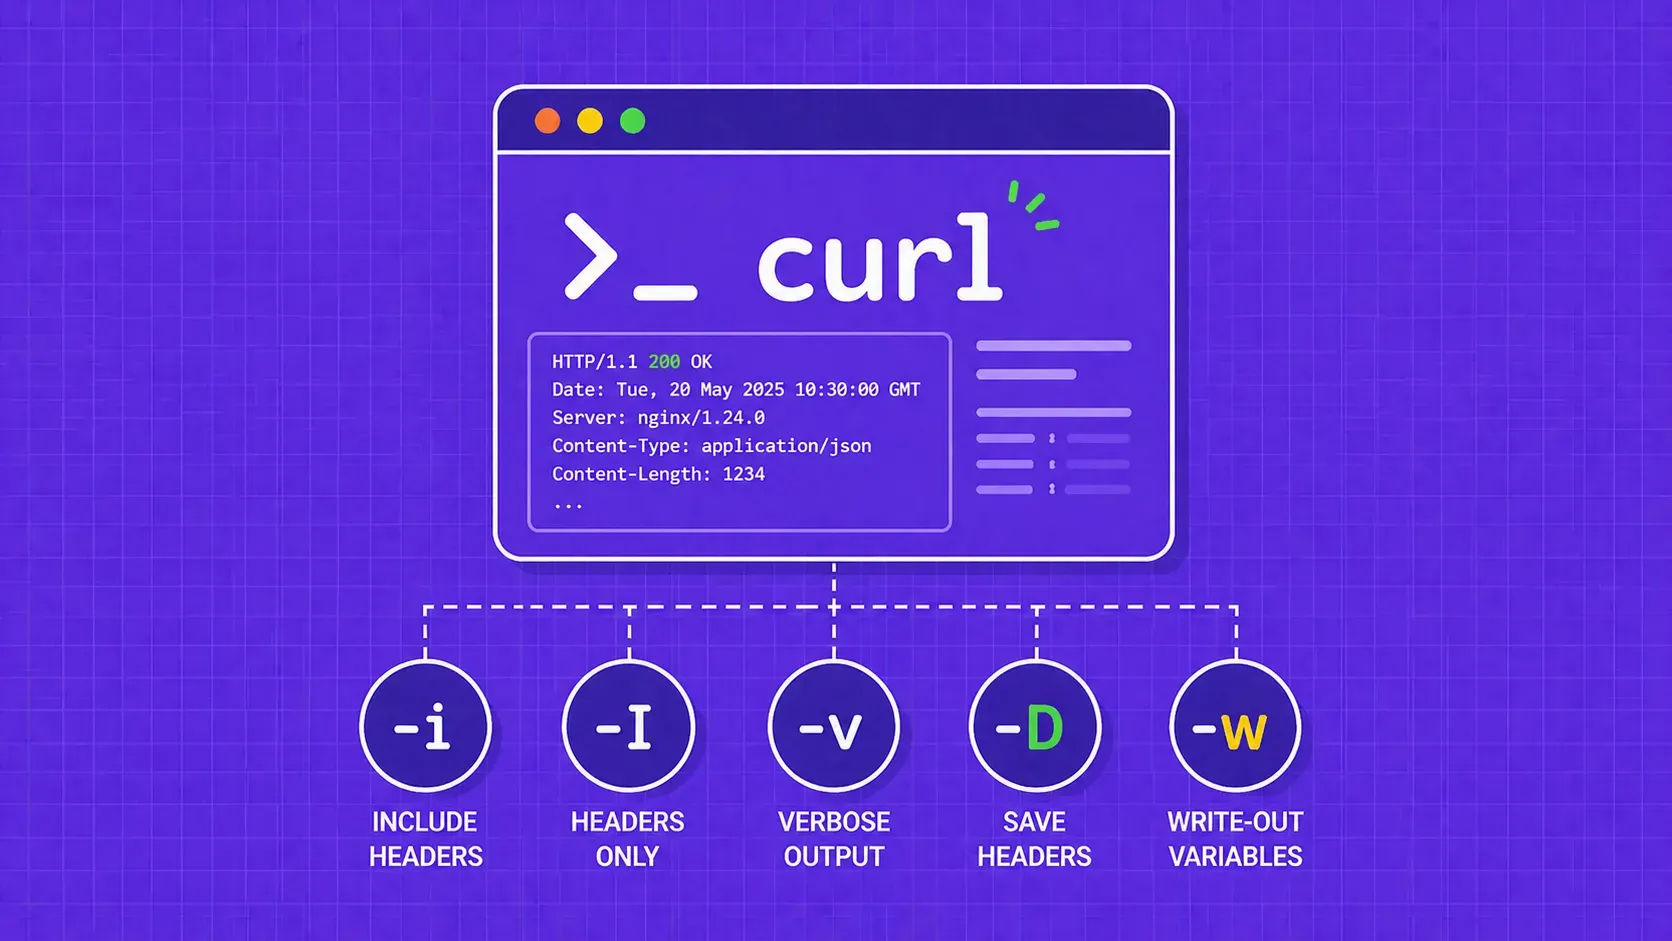
TL;DR: cURL oculta las cabeceras de respuesta por defecto. Utilice -i para ver las cabeceras junto con el cuerpo, -I para una solicitud HEAD que sólo devuelva cabeceras, -v para una depuración completa de solicitud/respuesta y -D para guardar las cabeceras en un archivo. Para scripts modernos, cURL 7.83+ le permite extraer cabeceras individuales o volcarlas todas como JSON con la opción -w write-out.

Suciu Dan13 min read
Leer artículo
¿Qué es un Headless Browser? Arquitectura, casos de uso y principales herramientas
La ciencia del web scraping

¿Qué es un Headless Browser? Arquitectura, casos de uso y principales herramientas

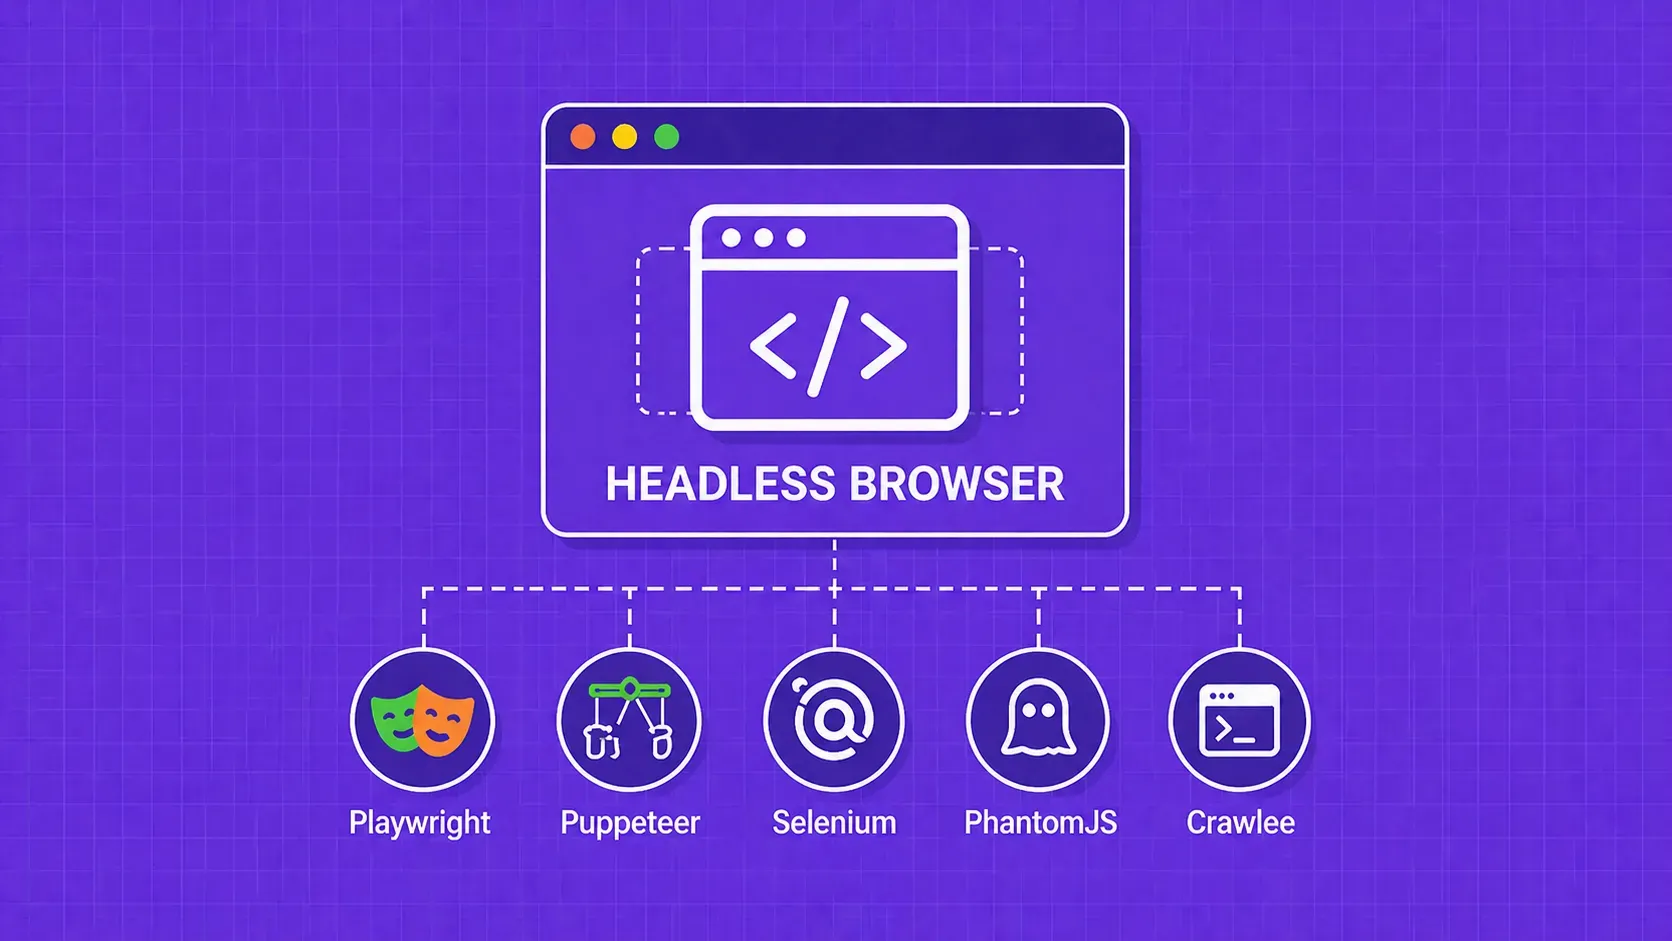
TL;DR: Un navegador sin cabeza es un navegador web que se ejecuta sin una interfaz gráfica visible, controlado enteramente a través de código o instrucciones de línea de comandos. Los desarrolladores utilizan los navegadores sin cabeza para pruebas automatizadas, web scraping, monitorización del rendimiento y, cada vez más, para potenciar agentes de IA. Esta guía explica cómo funcionan internamente, cuándo elegir uno en lugar de un navegador normal y qué frameworks merecen la pena.

Suciu Dan16 min read
Leer artículo
Guía de la API de extracción de datos de SERP: Google, Bing, DuckDuckGo, Yandex
Guías

Guía de la API de extracción de datos de SERP: Google, Bing, DuckDuckGo, Yandex

TL;DR: Envía tu primera solicitud a la API SERP de WebScrapingAPI con la clave en una variable de entorno; a continuación, filtra los resultados de Google por país, idioma y dispositivo; lee los archivos JSON de Google y Bing de forma defensiva; extrae tú mismo el código HTML de DuckDuckGo y Yandex; ejecuta tareas asíncronas de Google, vuelve a intentarlo según los códigos de error documentados y elige un plan basándote en los precios de Google a partir de octubre de 2026.

Suciu Dan25 min read
Leer artículo
¿Qué son los datos financieros? Tipos, métodos de recopilación y herramientas de análisis
Casos de uso

¿Qué son los datos financieros? Tipos, métodos de recopilación y herramientas de análisis

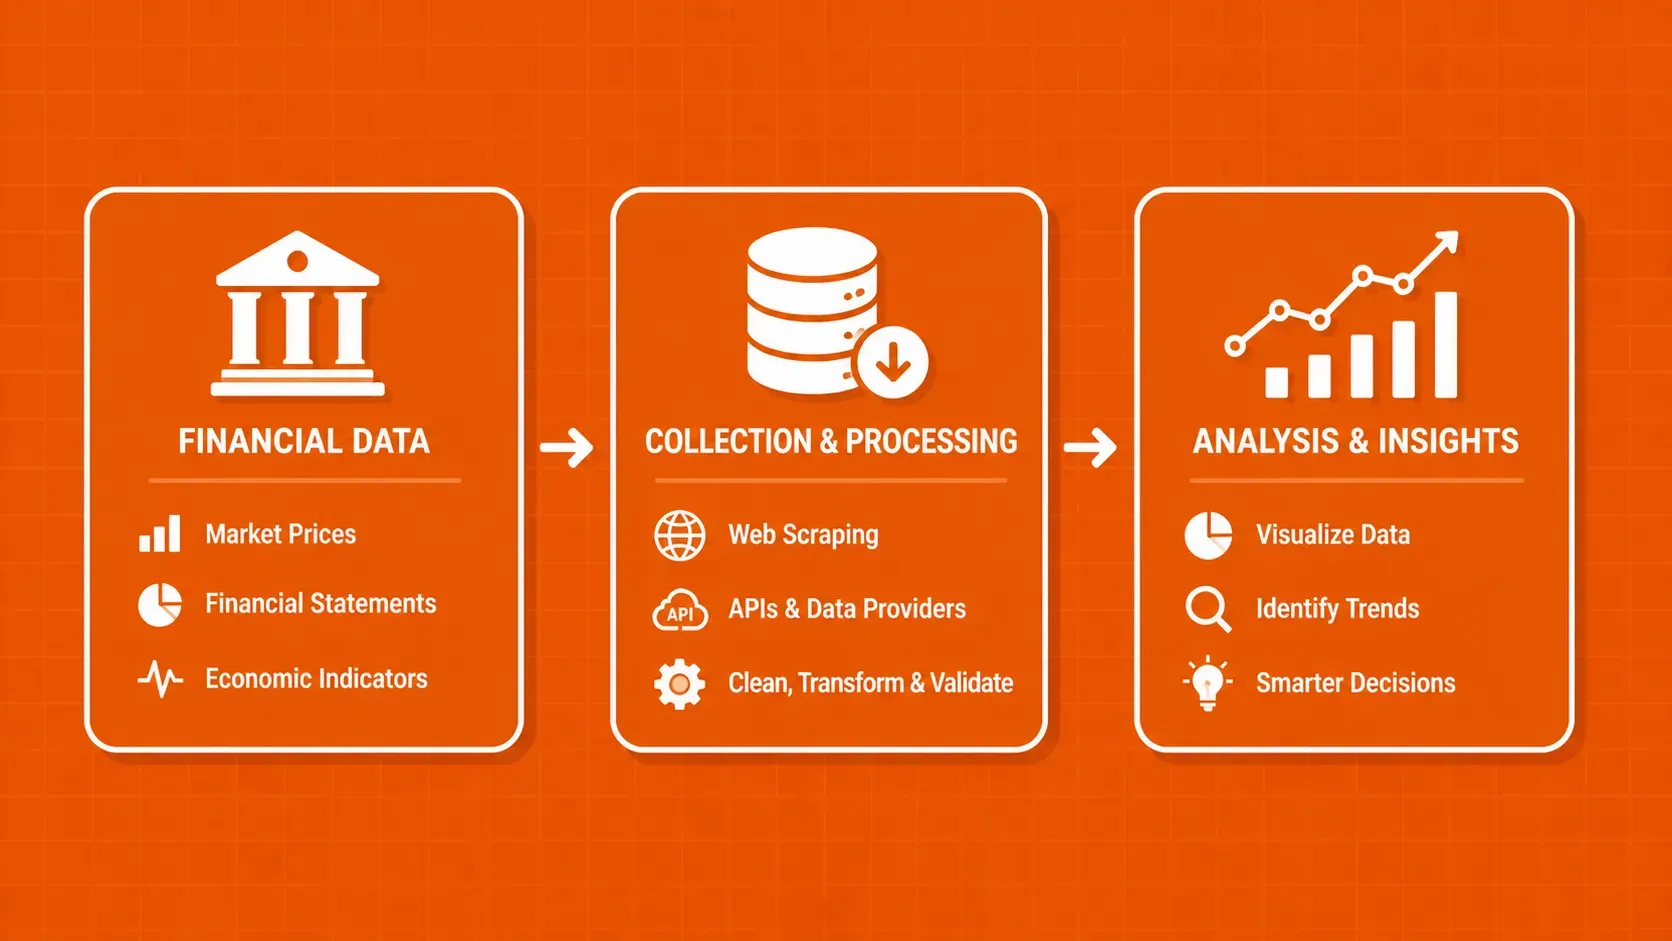
TL;DR: Los datos financieros son la recopilación de registros cuantitativos (ingresos, gastos, activos, pasivos, flujo de caja) que las organizaciones y los particulares utilizan para tomar decisiones económicas fundamentadas. Esta guía desglosa los cuatro estados financieros básicos, compara las fuentes de datos tradicionales y alternativas, recorre los métodos de recopilación modernos y cubre las herramientas en las que se basan los profesionales para el análisis.

Suciu Dan16 min read
Leer artículo
Explicación del análisis sintáctico de datos: Herramientas, técnicas y código (2026)
La ciencia del web scraping

Explicación del análisis sintáctico de datos: Herramientas, técnicas y código (2026)

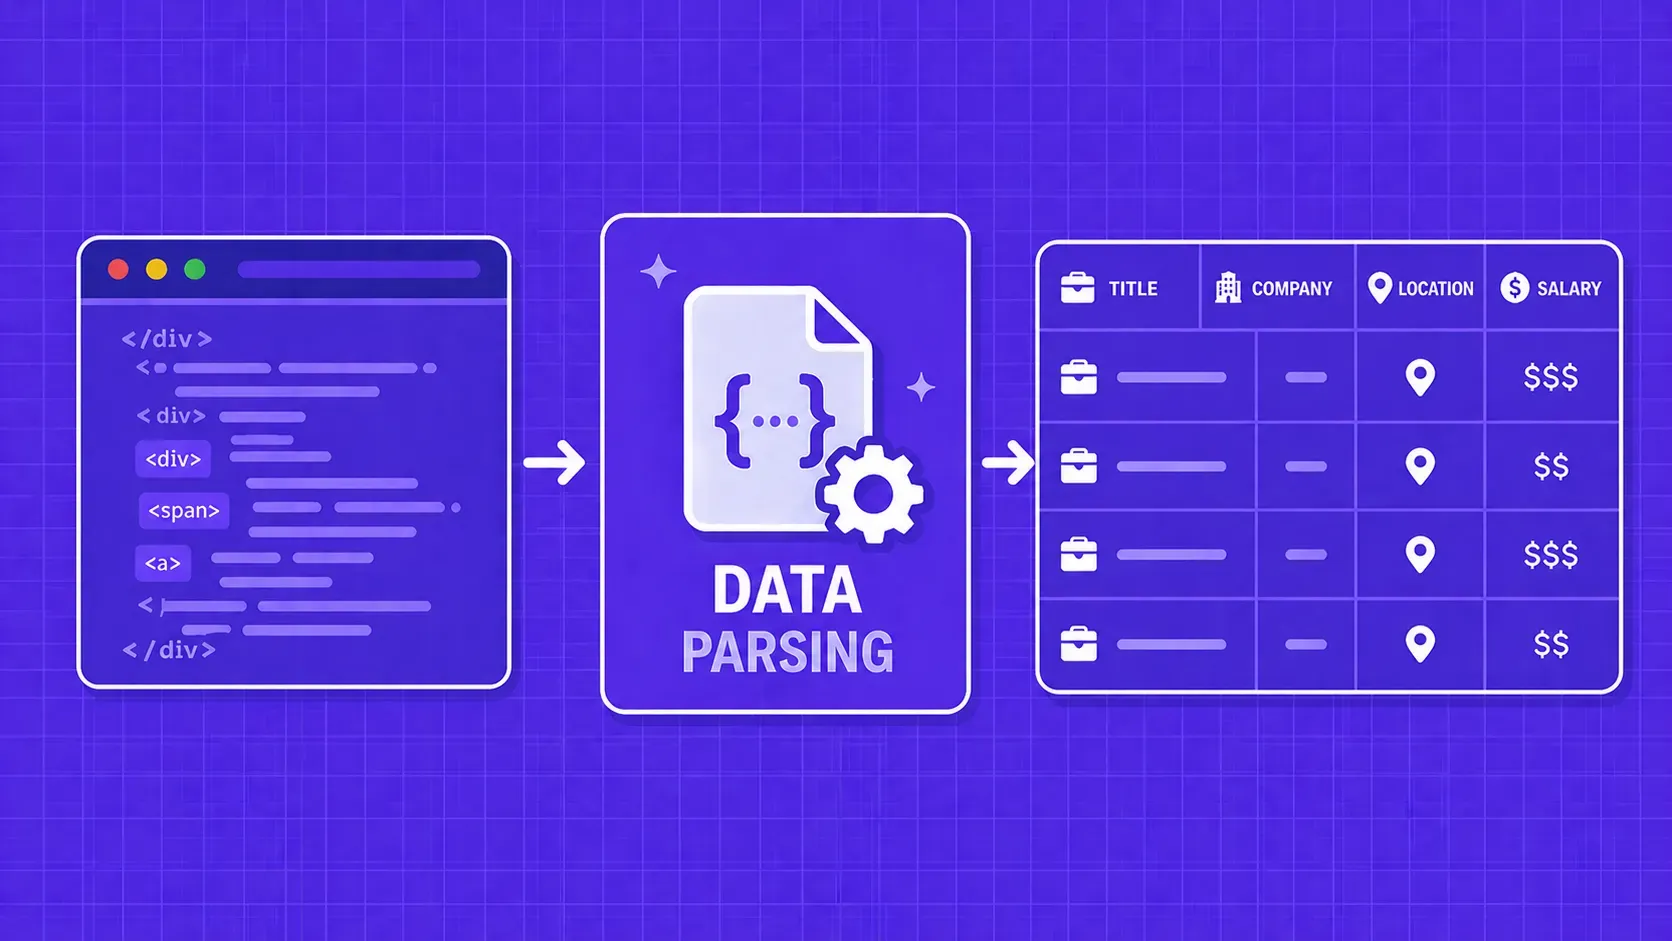
TL;DR: El análisis sintáctico de datos convierte el contenido en bruto (HTML, JSON, XML, PDF) en campos estructurados que su código puede utilizar realmente. Esta guía explica paso a paso cómo funciona el análisis sintáctico de datos, compara las principales técnicas y bibliotecas y ofrece un marco práctico para decidir si construir o comprar una capa de análisis sintáctico.

Suciu Dan17 min read
Leer artículo
Cómo configurar Axios Proxy en Node.js: Auth, Rotación, SOCKS5
Guías

Cómo configurar Axios Proxy en Node.js: Auth, Rotación, SOCKS5

TL;DR: Axios enruta las peticiones a través de un proxy aceptando un objeto proxy con los campos host, port y auth opcional. Esta guía cubre cómo establecer la configuración del proxy Axios desde cero: cableado básico, proxies autenticados, tunelado HTTPS, un sistema de rotación usando interceptores, SOCKS5 vía socks-proxy-agent, y diagnóstico de errores comunes. Cada fragmento es código Node.js copiable y pegable.

Suciu Dan12 min read
Leer artículo
Cómo utilizar un proxy con HttpClient en C#
Guías

Cómo utilizar un proxy con HttpClient en C#

TL;DR: Para usar un proxy con HttpClient en C#, construye un WebProxy, adjúntalo a un HttpClientHandler (o SocketsHttpHandler), y pasa ese handler al constructor de HttpClient. Para producción, cambia los bucles manuales por IHttpClientFactory, añade NetworkCredential para proxies autenticados, y envuelve las llamadas en reintentos con Polly para que las IPs muertas no tumben tu trabajador.

Suciu Dan19 min read
Leer artículo
Cómo construir un rastreador web en Python: De principio a fin
La ciencia del web scraping

Cómo construir un rastreador web en Python: De principio a fin

TL;DR: Un rastreador web python automatiza el tedioso trabajo de seguir enlaces a través de un sitio web para descubrir y recopilar contenido. Esta guía le guiará a través de la construcción de uno desde cero con las solicitudes y BeautifulSoup, luego graduarse a Scrapy para el rastreo concurrente, tuberías de artículos, y las exportaciones de datos estructurados. También aprenderá a rastrear de forma responsable, rotar proxies para evitar bloqueos y manejar páginas renderizadas en JavaScript.

Suciu Dan33 min read
Leer artículo
Cómo hacer scraping en LinkedIn en 2026: una guía en Python
Guías

Cómo hacer scraping en LinkedIn en 2026: una guía en Python

TL;DR: El raspado de LinkedIn significa trabajar alrededor de un muro de autenticación agresivo, seguimiento de comportamiento, y TLS fingerprinting. Esta guía te ofrece un árbol de decisiones método por método, patrones de trabajo en Python para trabajos, perfiles y empresas (API oculta, JSON-LD, Selenium cuando sea necesario) y una lista de comprobación antibloqueo consolidada para 2026.

Suciu Dan15 min read
Leer artículo
las 12 mejores herramientas gratuitas de Web Scraping en 2026: Comparativa
Guías

las 12 mejores herramientas gratuitas de Web Scraping en 2026: Comparativa

TL;DR: Las 12 mejores herramientas gratuitas de web scraping en 2026 se dividen en cuatro categorías: APIs gestionadas con créditos gratuitos, frameworks de código abierto, extensiones de navegador sin código y extractores de IA. Elige primero por caso de uso (raspado puntual frente a pipeline programado) y luego por nivel de conocimientos. La mayoría de los niveles gratuitos cubren la evaluación, no la producción; en el momento en que su tasa de éxito caiga por debajo de ~90% o queme más horas en bloques que en datos, es hora de pasar a una API de pago.

Suciu Dan30 min read
Leer artículo
¿Es legal el Web Scraping en 2026? Marco de cumplimiento
Guías

¿Es legal el Web Scraping en 2026? Marco de cumplimiento

TL;DR: ¿Es legal el web scraping? Normalmente sí, con algunas salvedades. La legalidad depende del tipo de datos, la ruta de acceso, las jurisdicciones implicadas y lo que se haga con el resultado. Esta guía le ofrece un veredicto directo, un marco de cinco minutos previo al raspado, los casos que importan y una lista de comprobación que puede ejecutar antes de realizar el envío.

Suciu Dan16 min read
Leer artículo
Las mejores API de web scraping en 2026: comparación de 12 según su finalidad y coste
Guías

Las mejores API de web scraping en 2026: comparación de 12 según su finalidad y coste

TL;DR: En resumen: La mejor API de web scraping depende de la tarea: una API de páginas barata gana con HTML estático, una opción de renderizado o un navegador alojado con apps cargadas de JavaScript, un endpoint de SERP o e-commerce para registros ya analizados, y una API orientada a Markdown para pipelines de LLM. Preselecciona dos o tres proveedores y compara el coste por página útil con tus URL: los multiplicadores de créditos y el cobro de fallos deciden el coste real.

Suciu Dan31 min read
Leer artículo
Reseña de webscraper.io: precios, límites y cuándo cambiar de servicio
Guías

Reseña de webscraper.io: precios, límites y cuándo cambiar de servicio

TL;DR: En resumen: Web Scraper de webscraper.io es una extensión gratuita para Chrome y Firefox, más el servicio de pago Web Scraper Cloud, y es una buena opción para tareas recurrentes pequeñas y medianas en sitios públicos corrientes. Quédate con él cuando unas pocas personas actualizan un puñado de sitios a diario o cada semana y alguien mantiene los selectores. Cambia cuando necesites muchos sitios, objetivos protegidos o con mucho JavaScript, o control a nivel de código.

Suciu Dan20 min read
Leer artículo
Alternativas a Puppeteer: Las mejores herramientas para scraping y testing 2026
Guías

Alternativas a Puppeteer: Las mejores herramientas para scraping y testing 2026

TL;DR: Puppeteer es genial para la automatización rápida de Chromium, pero su bloqueo en un solo navegador, el escalado de recursos pesados y el nulo soporte anti-bot integrado empujan a muchos equipos hacia alternativas. Esta guía desglosa las alternativas más fuertes de Puppeteer por caso de uso (raspado, pruebas E2E, control de calidad entre navegadores, móvil), le da una tabla de comparación lado a lado, y termina con un marco de decisión para que pueda elegir la herramienta adecuada sin ensayo y error.

Suciu Dan18 min read
Leer artículo
Alternativa al web scraper: adapta primero el flujo de trabajo
Guías

Alternativa al web scraper: adapta primero el flujo de trabajo

TL;DR: Compara Octoparse, Browse AI, Apify y Playwright según su modelo de creación. Mantén la navegación, registra la identidad y el comportamiento de entrega al sustituir Web Scraper.

Suciu Dan15 min read
Leer artículo
Alternativa a WebHarvy: compara flujos de trabajo de datos de productos
Guías

Alternativa a WebHarvy: compara flujos de trabajo de datos de productos

TL;DR: Compara Octoparse, ParseHub, Web Scraper y Apify para la extracción de datos de productos. Comprueba las variantes, las ofertas, los artículos que faltan y las exportaciones antes de sustituir a WebHarvy.

Suciu Dan16 min read
Leer artículo
Los mejores raspadores web Node.js en 2026: 6 bibliotecas comparadas
Guías

Los mejores raspadores web Node.js en 2026: 6 bibliotecas comparadas

TL;DR: Los mejores raspadores web Node.js en 2026 se dividen en dos campos: clientes HTTP como Axios y Superagent para páginas estáticas, y navegadores sin cabeza como Puppeteer y Playwright para sitios con mucho JavaScript. Elija por flujo de trabajo, no por popularidad, y descargue la renderización a una API de scraping gestionada una vez que las defensas anti-bot o la escala empiecen a consumir su tiempo de ingeniería.

Suciu Dan12 min read
Leer artículo

Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.