
Saltar al contenido
Empezar gratis

Blog

Perspectivas e ingeniería

Análisis en profundidad de la infraestructura de datos web, las técnicas de extracción y el futuro de los datos estructurados a gran escala.

Últimos artículos

156 artículos

Guía de la API de extracción de datos de SERP: Google, Bing, DuckDuckGo, Yandex
Guías

Guía de la API de extracción de datos de SERP: Google, Bing, DuckDuckGo, Yandex

TL;DR: Envía tu primera solicitud a la API SERP de WebScrapingAPI con la clave en una variable de entorno; a continuación, filtra los resultados de Google por país, idioma y dispositivo; lee los archivos JSON de Google y Bing de forma defensiva; extrae tú mismo el código HTML de DuckDuckGo y Yandex; ejecuta tareas asíncronas de Google, vuelve a intentarlo según los códigos de error documentados y elige un plan basándote en los precios de Google a partir de octubre de 2026.

Suciu Dan25 min read
Leer artículo
Cómo utilizar la API de Amazon Scraper: guía de inicio rápido
Guías

Cómo utilizar la API de Amazon Scraper: guía de inicio rápido

TL;DR: Empieza a utilizar la API de WebScrapingAPI para extraer datos de Amazon: envía tu primera solicitud, elige entre nueve tipos de solicitud (productos, búsquedas, superventas, ofertas, opiniones de vendedores y mucho más), selecciona entre 20 mercados de Amazon, analiza cada respuesta JSON, gestiona los errores y los reintentos, y elige un plan.

Robert Sfichi25 min read
Leer artículo
Scrapy vs Selenium: ¿Quién gana?
La ciencia del web scraping

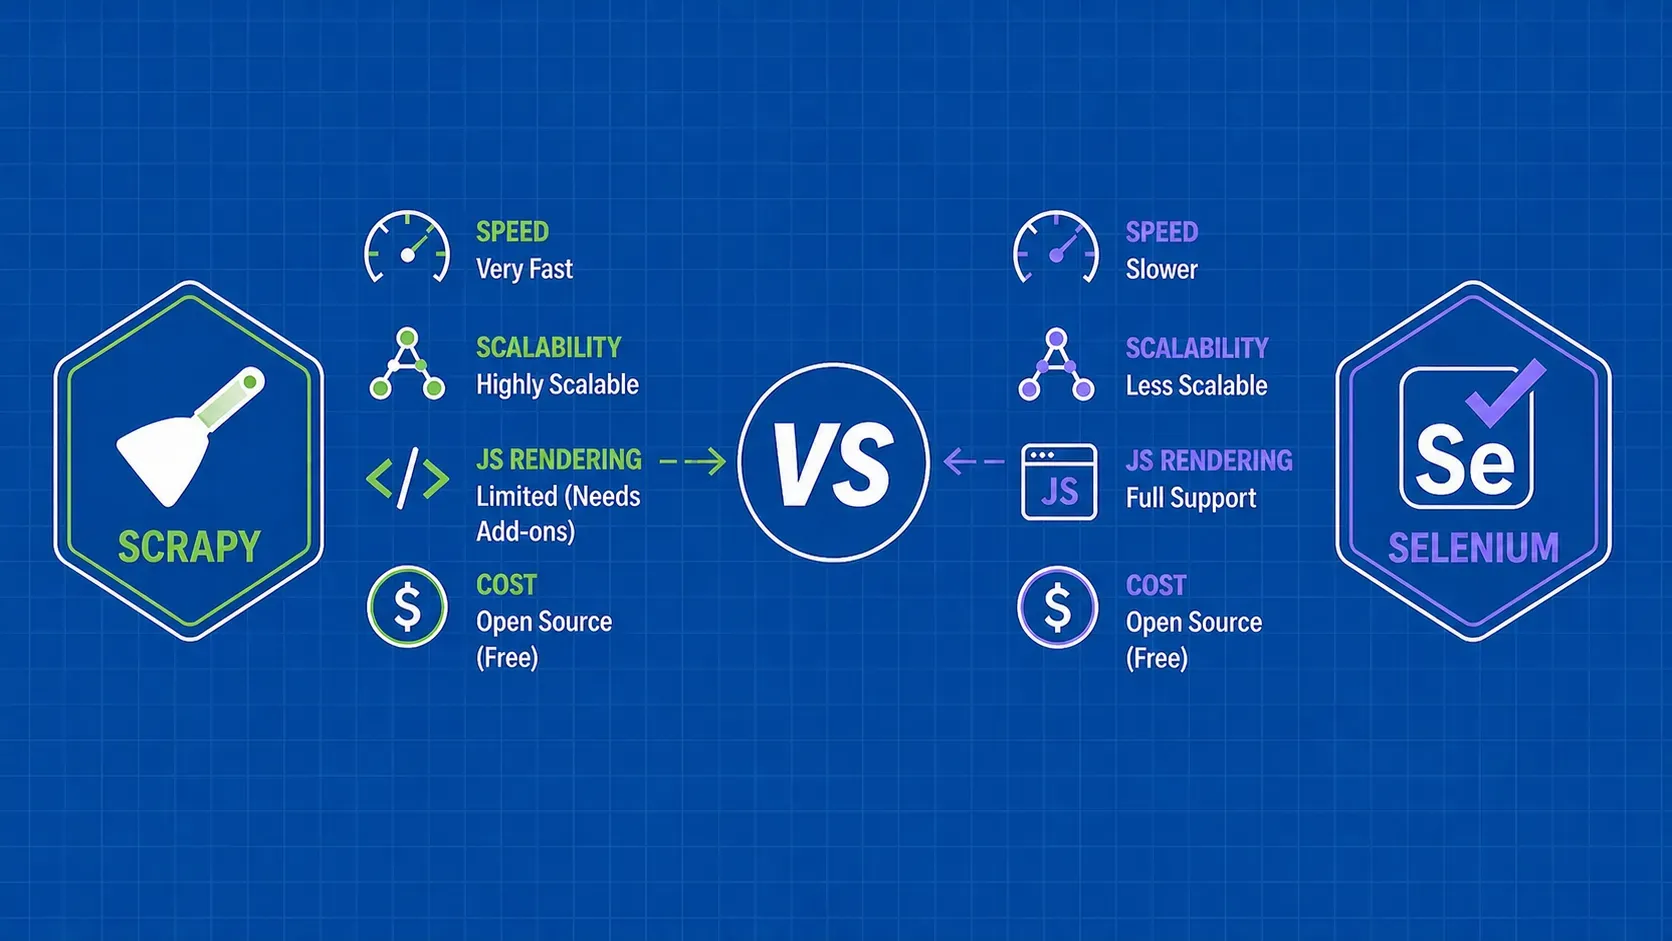
Scrapy vs Selenium: ¿Quién gana?

TL;DR: Scrapy es un marco de rastreo asíncrono de alta velocidad construido para extraer datos estructurados de páginas estáticas a escala. Selenium automatiza los navegadores reales y gestiona los sitios con mucho JavaScript, pero con un coste de recursos mucho mayor. La mayoría de los proyectos de scraping de producción se benefician de saber cuándo usar cada uno, o cuándo combinarlos.

Gabriel Cioci11 min read
Leer artículo
Scrapy vs Beautiful Soup: Qué Python Scraper elegir
Guías

Scrapy vs Beautiful Soup: Qué Python Scraper elegir

TL;DR: Scrapy es un completo framework de rastreo que maneja peticiones, análisis y exportación de datos en un solo paquete. Beautiful Soup es una biblioteca ligera de análisis sintáctico que se combina con un cliente HTTP como requests. Elige Scrapy cuando necesites un rastreo concurrente a gran escala con pipelines integrados. Elige Beautiful Soup cuando quieras una configuración rápida y mínima para analizar un puñado de páginas.

Mihnea-Octavian Manolache12 min read
Leer artículo
Tutorial de Scrapy Splash: Renderizar páginas JavaScript
Guías

Tutorial de Scrapy Splash: Renderizar páginas JavaScript

TL;DR: Scrapy Splash empareja el rápido motor de rastreo de Scrapy con el navegador sin cabeza Splash para renderizar páginas con mucho JavaScript. Este tutorial de Scrapy Splash te guía a través de la configuración de Docker, la configuración del proyecto Scrapy, los conceptos básicos de SplashRequest, los scripts Lua para desplazarse y hacer clic, la integración de proxy y la solución de los errores más comunes que encontrarás.

Ștefan Răcilă13 min read
Leer artículo
Scrapear datos de productos de Amazon con Python: Guía práctica
Guías

Scrapear datos de productos de Amazon con Python: Guía práctica

TL;DR: Las páginas de productos de Amazon están repletas de datos valiosos (precios, valoraciones, reseñas, ASIN), pero extraerlos de forma fiable requiere algo más que una petición HTTP básica. Esta guía te guía a través de la construcción de un scraper Python con Requests y BeautifulSoup, el manejo de la paginación y las defensas anti-bot, la exportación a CSV o JSON, y la alimentación de los resultados en los flujos de trabajo LLM. También aprenderás cuándo utilizar una API de scraping en lugar de desarrollar tu propia solución.

Raluca Penciuc18 min read
Leer artículo

Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.