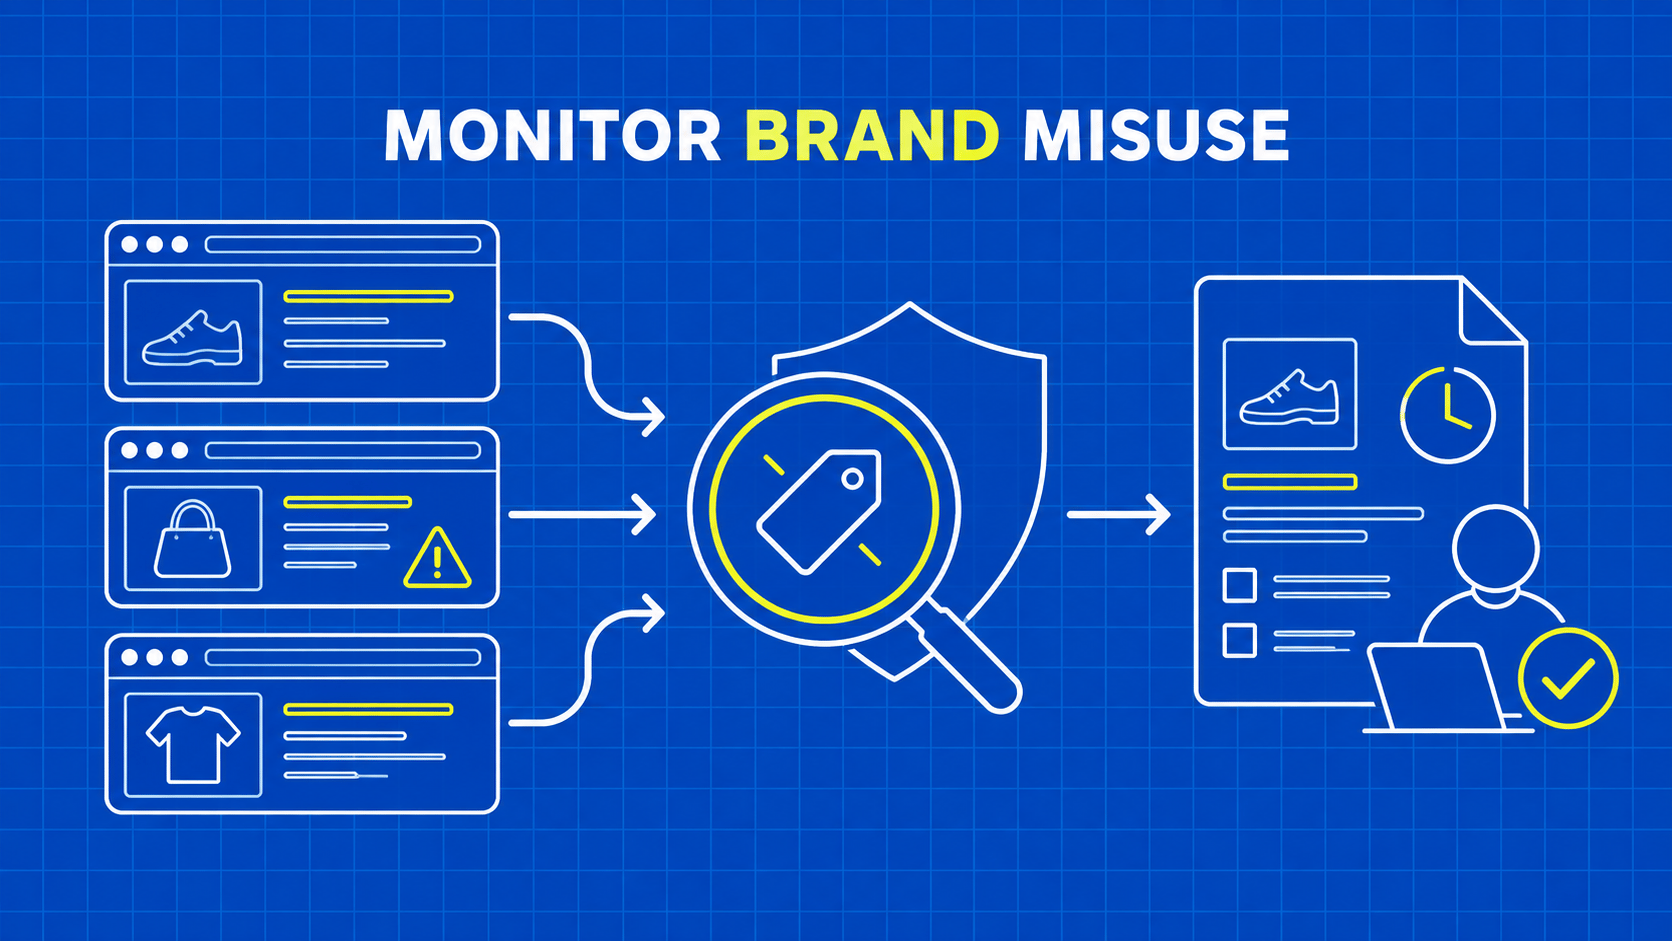
En resumen: el web scraping para la protección de marca ayuda a los equipos a descubrir y seguir anuncios que merecen una investigación. Compara las observaciones con los registros aprobados de productos y vendedores, conserva evidencias fechadas y envía casos explicables a revisores humanos, en lugar de declarar automáticamente que un producto es falsificado o presentar denuncias.
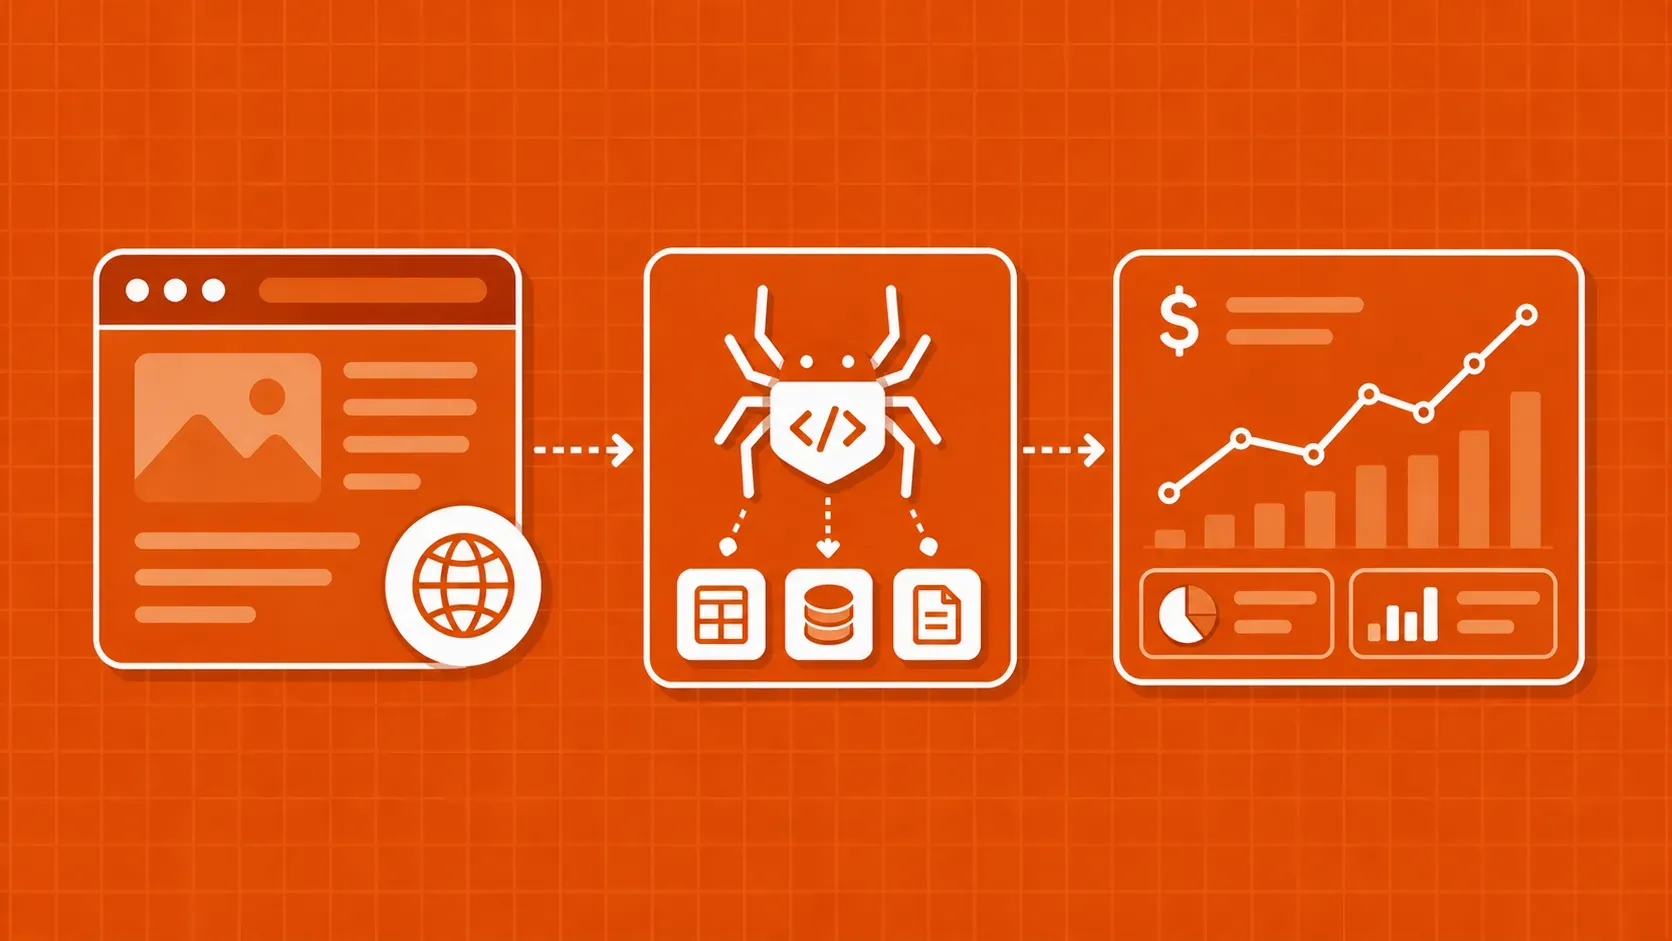
El web scraping para la protección de marca es la recopilación automatizada de información en línea sobre productos, vendedores y uso de la marca para apoyar la monitorización y la investigación. Su resultado útil es un caso de revisión respaldado por evidencias: qué cambió, dónde apareció, con qué registro de referencia entra en conflicto y qué debe comprobar después un revisor.
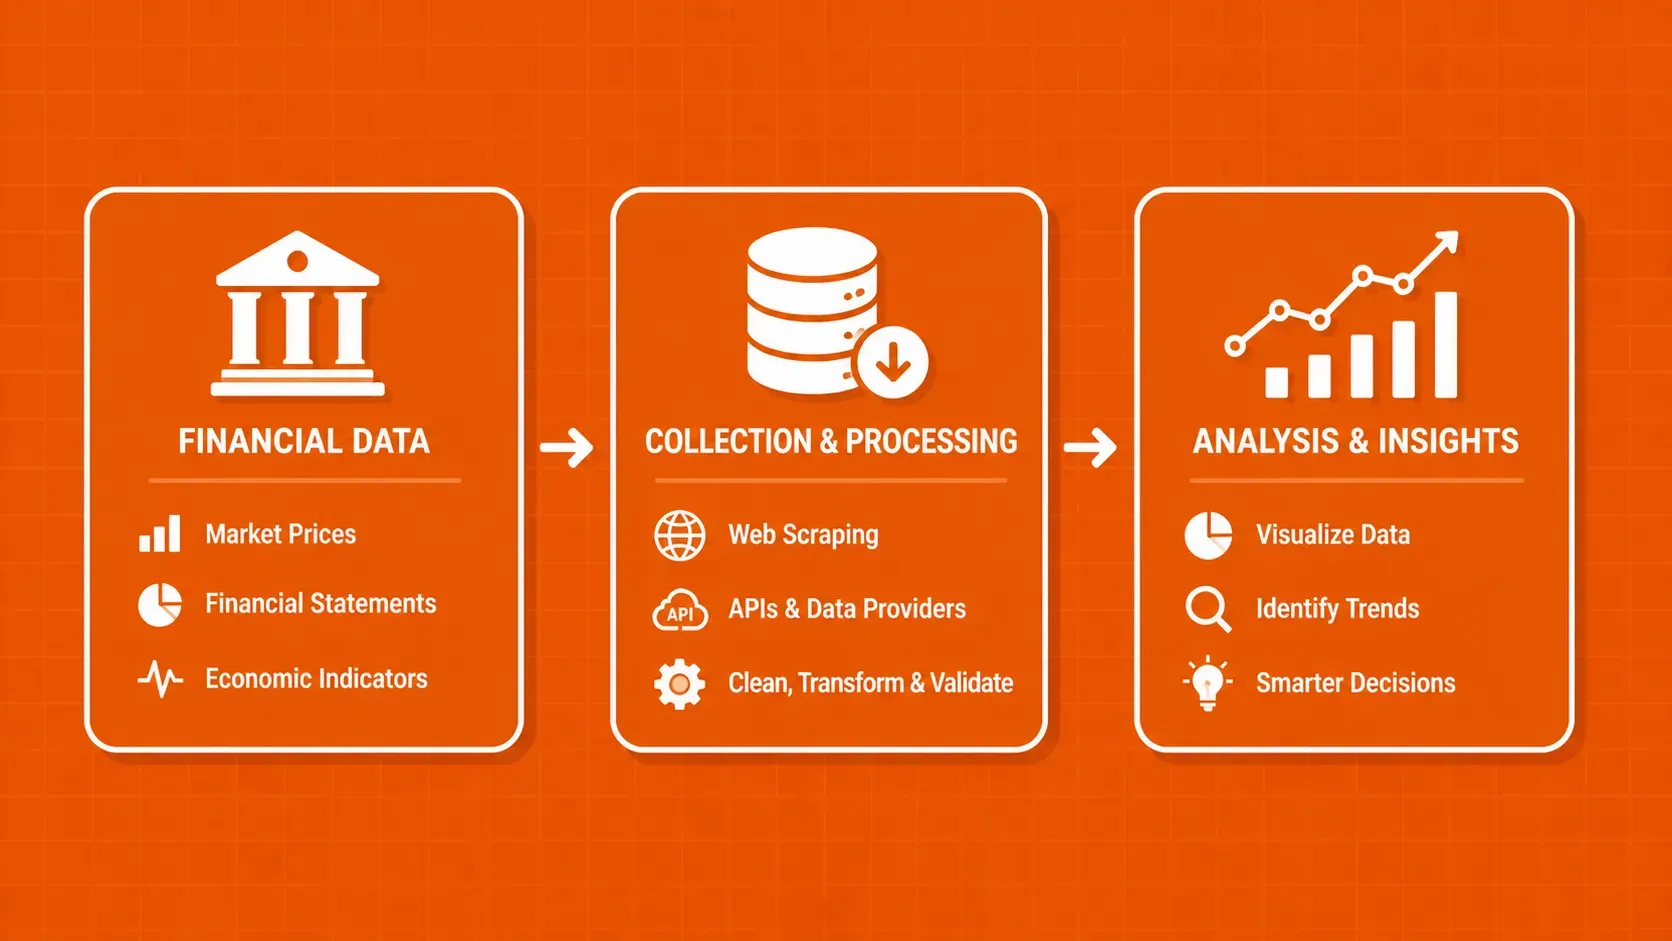
La inteligencia de precios, los estudios de mercado y la generación de leads figuran junto a la monitorización de marca entre los casos de uso empresariales del web scraping.
Imagina que una foto de producto conocida aparece en un nuevo anuncio de un marketplace. El precio es inusualmente bajo y el vendedor no figura en tu base de datos de distribuidores. Esa combinación merece atención, pero no demuestra que el producto sea falsificado. El artículo podría ser de segunda mano, la ficha del vendedor podría estar incompleta o el anuncio podría describir otro tamaño de envase.
Un buen sistema de monitorización conserva esos matices. Reduce el tiempo necesario para encontrar e investigar candidatos sin convertir observaciones incompletas en acusaciones. Esta guía muestra cómo construir ese sistema: establecer una base de referencia, descubrir candidatos, crear identidades de anuncio estables, capturar evidencias, priorizar la revisión y hacer el seguimiento a través de los canales oficiales de denuncia. La implementación se centra en la calidad de los datos y la trazabilidad que controla el desarrollador, y deja las valoraciones jurídicas y las decisiones de aplicación a las personas responsables.