
Saltar al contenido
Empezar gratis

Blog

Perspectivas e ingeniería

Análisis en profundidad de la infraestructura de datos web, las técnicas de extracción y el futuro de los datos estructurados a gran escala.

Últimos artículos

156 artículos

Playwright Web Scraping: La guía completa para Python y Node.js
Guías

Playwright Web Scraping: La guía completa para Python y Node.js

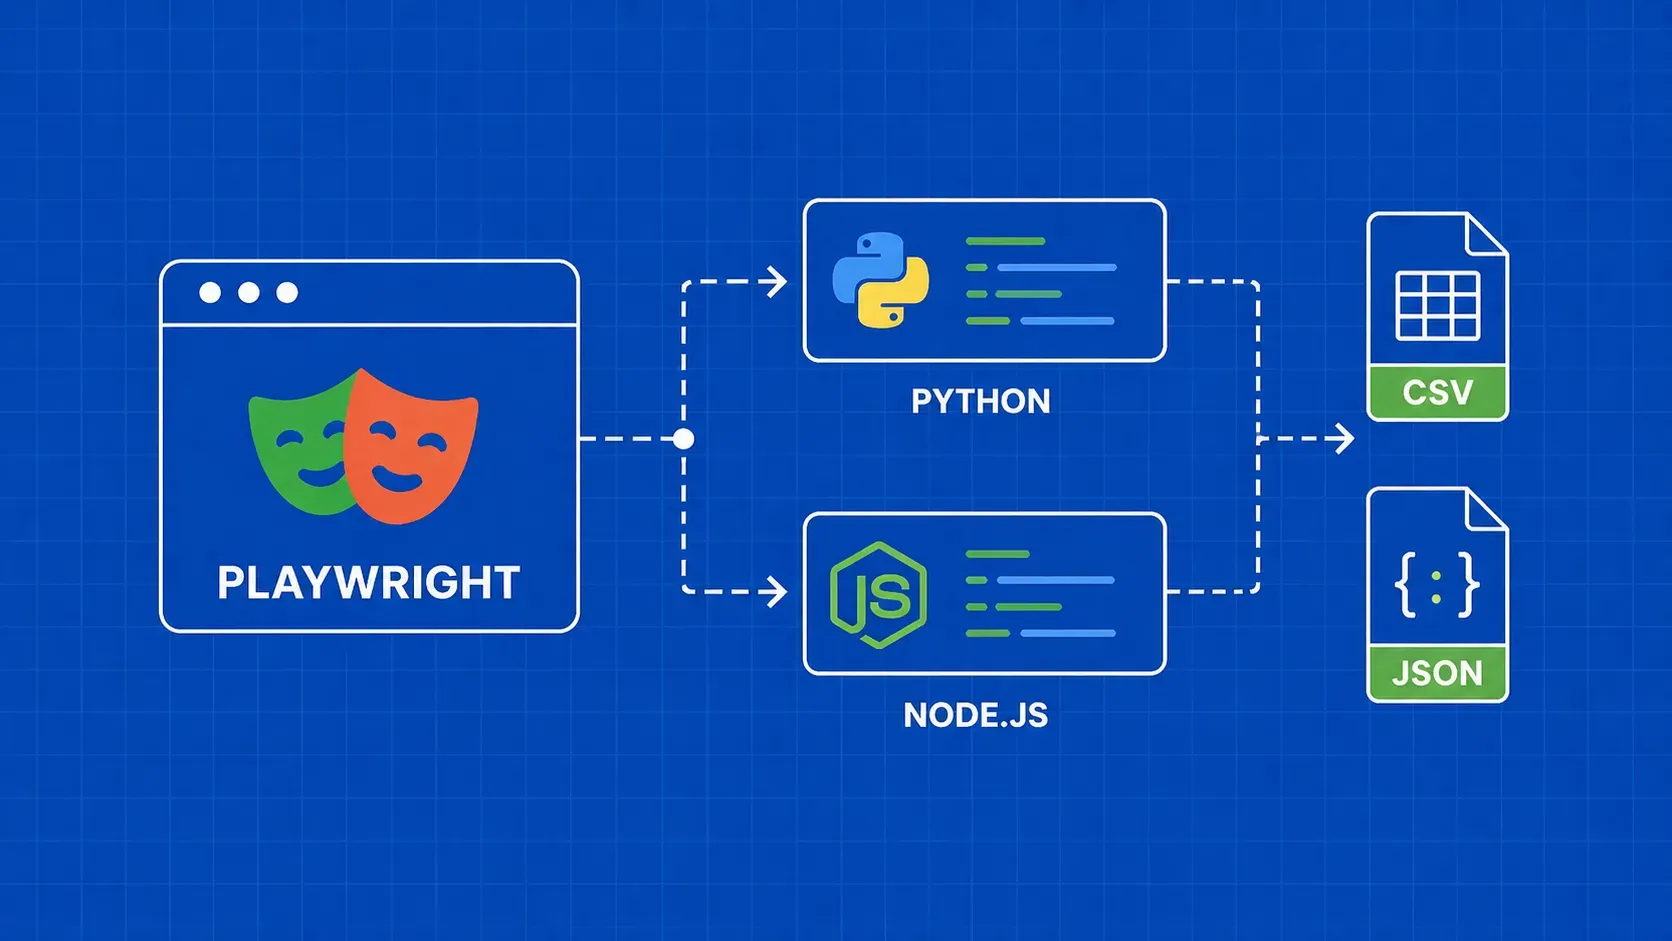
TL;DR: Playwright te ofrece una automatización completa del navegador para el scraping de sitios con mucho JavaScript, con soporte de primera clase tanto para Python como para Node.js. Esta guía le guiará a través de la instalación, extracción de elementos, configuración de proxy, antidetección, paginación, descarga de imágenes y exportación de datos a CSV o JSON, todo ello con ejemplos de código en ambos lenguajes.

Mihnea-Octavian Manolache17 min read
Leer artículo
Cómo buscar reseñas en Google Maps: Una guía práctica en Python
Guías

Cómo buscar reseñas en Google Maps: Una guía práctica en Python

TL;DR: Averiguar cómo raspar Google Maps para las revisiones se reduce a tres vías de método: un raspador de Selenium DIY detrás de un proxy giratorio, una API de raspado con instrucciones de renderizado, o una API de revisiones de Maps estructurada que devuelve JSON analizado. Esta guía recorre las tres vías en Python con código copiable y pegable, patrones de paginación, tácticas antibloqueo y un paso final de limpieza que convierte las reseñas sin procesar en algo que una empresa puede utilizar realmente.

Andrei Ogiolan18 min read
Leer artículo
Cómo descargar archivos con Python: guía práctica
Guías

Cómo descargar archivos con Python: guía práctica

TL;DR: Aprende a descargar archivos con Python usando urllib, requests y aiohttp: streaming, barras de progreso, descargas paralelas y asíncronas, reintentos y autenticación.

Gabriel Cioci17 min read
Leer artículo
Cómo utilizar proxies con Python Requests: De lo básico a la producción
Guías

Cómo utilizar proxies con Python Requests: De lo básico a la producción

TL;DR: Esta guía explica cómo usar proxies con Python Requests de principio a fin: un dictado de proxies funcional, URLs autenticadas, variables de entorno, reutilización de sesiones, SOCKS5 sin fugas de DNS, y un pool de rotación con reintentos y un disyuntor. Al final, usted sabrá cuando una API gestionada gana su sustento sobre una piscina de bricolaje.

Ștefan Răcilă11 min read
Leer artículo
Cómo extraer datos de los resultados de lugares de Google Maps
Guías

Cómo extraer datos de los resultados de lugares de Google Maps

TL;DR: Descubre cómo extraer datos de los resultados de lugares de Google Maps con nuestra API utilizando Node.js: guía paso a paso, ventajas de un extractor profesional y mucho más. Obtén fácilmente el data_id, las coordenadas y el parámetro «build data».

Andrei Ogiolan7 min read
Leer artículo
Web Scraping con Regex: Guía práctica
Guías

Web Scraping con Regex: Guía práctica

TL;DR: Web scraping con regex brilla cuando necesitas patrones de texto cortos y predecibles (precios, SKUs, correos electrónicos, fechas) de HTML en el que ya confías. Empareje el módulo re de Python con Beautiful Soup, extienda sus patrones a un nodo analizado en lugar de a una marca sin procesar y mantenga el regex fuera del camino del análisis completo del árbol HTML. Esta guía muestra un raspador de título y precio, características avanzadas de regex y los problemas que afectan a los raspadores reales en producción.

Mihai Maxim12 min read
Leer artículo

Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.