Saltar al contenido
Empezar gratis
Volver al blog

Estilos de API: comparación de cinco modelos prácticos de integración

Robert MunceanuÚltima actualización el 16 min read
Estilos de API: comparación de cinco modelos prácticos de integración
En resumen: REST, SOAP, GraphQL, RPC y los webhooks describen diferentes aspectos de una integración. Comparad su modelo de recursos, su contrato de mensajes, el comportamiento de las consultas, la semántica de las operaciones y la dirección de entrega, en lugar de tratarlos como cinco protocolos intercambiables.

Un servicio de catálogo puede ofrecer lecturas REST, enviar notificaciones mediante webhooks y llamar a un servicio RPC interno para calcular las existencias. Los tres pueden formar parte del mismo producto. Los estilos de API son enfoques para organizar la forma en que el software expone sus capacidades e intercambia información, pero el término se utiliza a menudo de manera tan imprecisa que se mezclan la arquitectura con los patrones de mensajería y entrega.

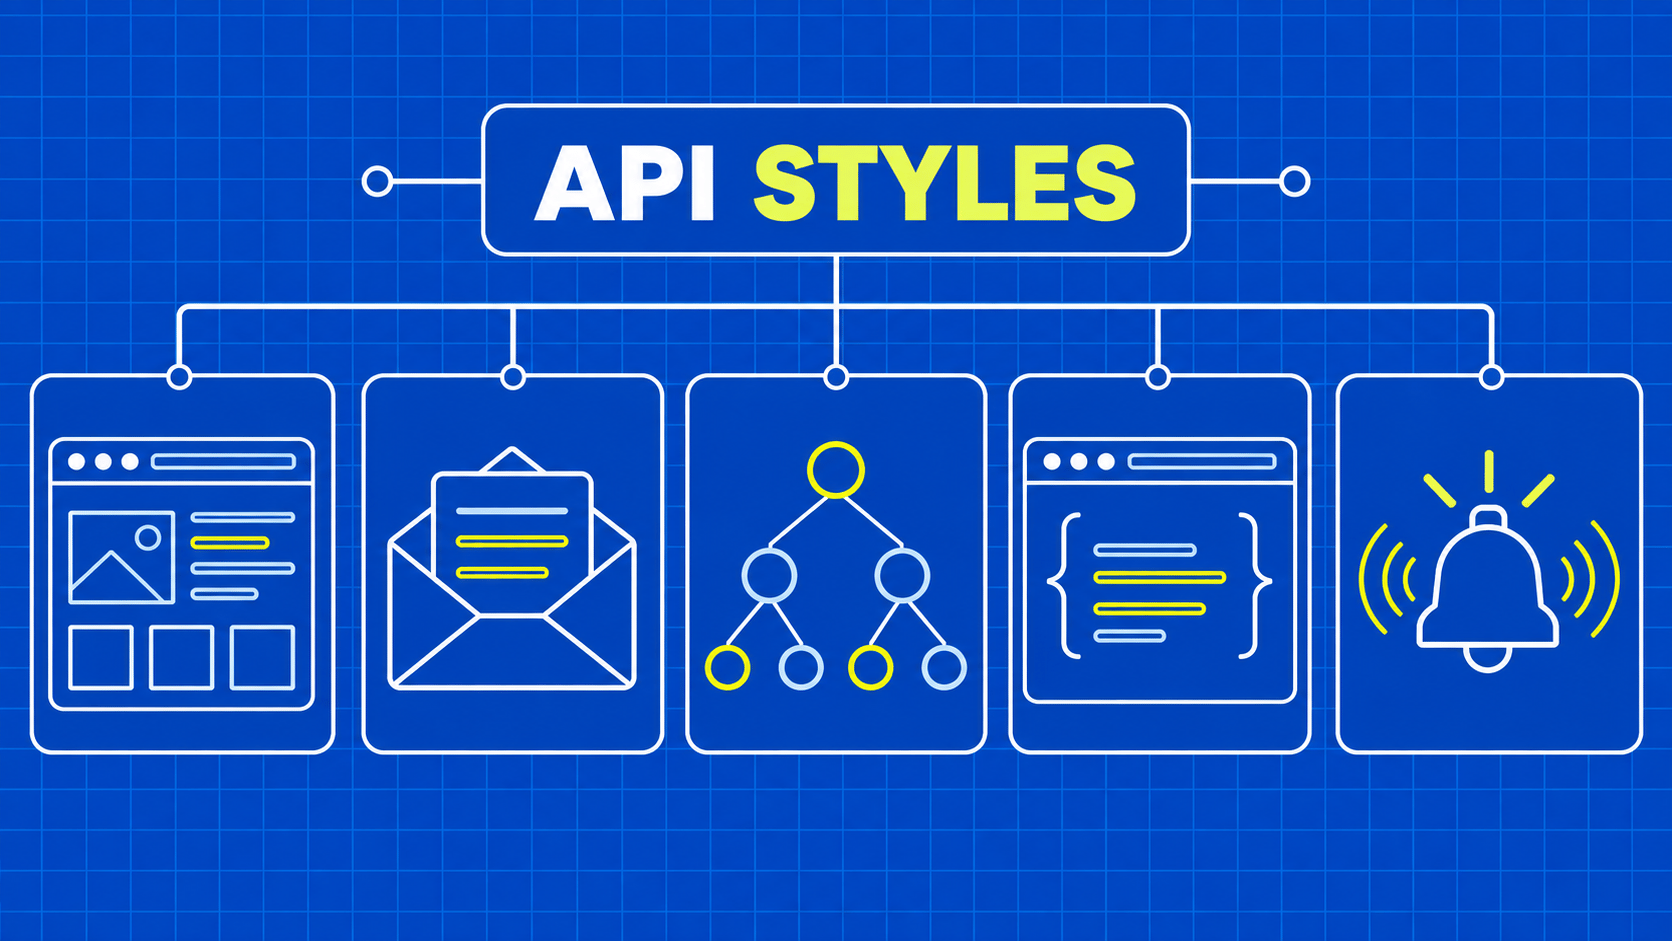
Ese uso impreciso hace que una comparación habitual resulte engañosa. REST es un estilo arquitectónico, SOAP es un protocolo de mensajería, GraphQL es un lenguaje de consulta y un modelo de ejecución, RPC describe las llamadas a operaciones remotas y los webhooks describen la entrega desencadenada por eventos. Son enfoques útiles para comparar, no categorías mutuamente excluyentes en las que toda API deba encajar.

Esta guía utiliza un catálogo hipotético para explicar cinco enfoques comunes. No los clasifica por cuota de mercado ni afirma que sean las únicas opciones. El objetivo es práctico: identificar qué promete la interfaz de un proveedor, qué casos de fallo debes gestionar y en qué casos dos enfoques pueden complementarse entre sí. Para un recopilador de datos, esas respuestas son más importantes que elegir la etiqueta que aparece con más frecuencia en un diagrama de arquitectura.
Compara los estilos de API sin confundir sus categorías

Antes de examinar una carga útil de ejemplo, pregúntate qué es lo que la interfaz hace visible. ¿El consumidor navega por los recursos, envía un mensaje definido, selecciona campos de un esquema, invoca una operación o recibe una notificación tras un evento? Esa primera distinción te indica qué artefactos del contrato debes solicitar.

Enfoque

Categoría

Ejemplo del catálogo

Evidencia del contrato que hay que inspeccionar

REST

Estilo arquitectónico

Recuperar una representación del producto y seguir sus enlaces

Semántica de los recursos, tipos de medio, transiciones, política de caché

SOAP

Protocolo de mensajería

Intercambio de un mensaje de inventario estructurado

Versión de la envoltura, esquemas, enlace, definiciones de errores

GraphQL

Lenguaje de consulta y modelo de ejecución

Seleccionar un nombre de producto y los campos de inventario seleccionados

Esquema, reglas de funcionamiento, posibilidad de valores nulos, errores

RPC

Modelo de invocación remota

Llamar a una operación definida de cálculo de existencias

Definición del servicio, tipos de parámetros, plazos, semántica de los resultados

Webhooks

Patrón de entrega de eventos

Recibir una notificación cuando se produce un cambio en un producto

Suscripción, carga útil, verificación, política de entrega y recuperación

La tabla describe lo que debes comprobar, no lo que garantiza cada implementación. Un servicio descrito como REST puede no exponer transiciones navegables. Un proveedor de webhooks puede ofrecer reenvío manual, pero no reintentos automáticos. Un cliente RPC generado puede hacer que una llamada remota parezca local sin que desaparezcan los fallos de red.

Mantén los estilos de API separados de otras decisiones. JSON y XML describen la representación de los datos; HTTP describe la semántica del protocolo; «público» y «privado» describen la exposición o las condiciones de acceso. Ninguna de estas categorías sustituye a las demás. Un contrato de integración completo necesita varias de ellas a la vez.

Para el catálogo hipotético, escribe primero un pequeño requisito: recuperar las descripciones actuales de los productos, detectar cuándo cambian los productos relevantes y recuperarse tras una interrupción del colector. Ahora puedes comparar cómo cada enfoque ayuda a satisfacer ese requisito. Sin ello, una lista de características se convierte en una discusión sobre preferencias en lugar de una decisión sobre el sistema que necesitas.

REST: navegar por los recursos a través de una interfaz uniforme

Un diseño REST organiza la interacción en torno a los recursos y sus representaciones. En el escenario del catálogo, un producto es el recurso; un documento que describe su estado actual es una representación. Un cliente puede leer esa representación sin depender de la estructura de la base de datos subyacente.

Las restricciones definitorias incluyen la separación cliente-servidor, la interacción sin estado, la capacidad de almacenamiento en caché, una interfaz uniforme, un sistema en capas y el código bajo demanda opcional. La interfaz uniforme incluye la identificación de recursos, la manipulación a través de representaciones, los mensajes autodescriptivos y las transiciones impulsadas por hipermedia. La tesis de Fielding constituye la definición principal.

En el caso de un recopilador, hay que examinar cómo la interfaz expone una página siguiente o un recurso relacionado. Seguir una transición proporcionada puede evitar la incorporación de una regla privada de construcción de URL en el cliente. Aún así, es necesario comprender el formato de la representación y la semántica de los enlaces; un campo de URL sin un significado definido no hace que un flujo de trabajo desconocido resulte comprensible.

Cuando REST se implementa sobre HTTP, la semántica de los métodos y de la caché es importante. Una recuperación que admita la validación puede permitir al recopilador reutilizar una representación sin cambios en las condiciones aplicables. Esa es una propiedad que hay que verificar en el contrato de respuesta real, no una ventaja automática de la etiqueta REST.

Entre los estilos de API, a menudo se habla de REST como si se tratara simplemente de URL legibles más JSON. Esa simplificación pasa por alto los requisitos arquitectónicos. La guía de restricciones REST ofrece un análisis más detallado cuando la conformidad estricta es importante para tu diseño.

Para este catálogo, pregúntate si cada solicitud incluye el contexto necesario, si los resultados personalizados permanecen aislados y si las transiciones admitidas son detectables. Si, por el contrario, el proveedor ofrece una API HTTP útil pero más estrechamente acoplada, intégrala según ese comportamiento documentado. No des por sentadas las propiedades que faltan simplemente porque su página de marketing denomine a la interfaz «RESTful».

SOAP: intercambio de mensajes bajo reglas de procesamiento explícitas

Una integración SOAP comienza con el marco de mensajes. La envoltura SOAP utiliza XML, define dónde debe ubicarse el contenido del mensaje y establece reglas de procesamiento, incluidos los errores estructurados. La especificación SOAP 1.2 también proporciona un marco de extensibilidad y un modelo de enlace.

Para el catálogo hipotético, imagina un mensaje de inventario definido por el proveedor con un identificador de producto y un ámbito de almacén. Tu cliente debe construir e interpretar el mensaje documentado, en lugar de deducir su significado a partir de una página visual. El espacio de nombres exacto, los campos obligatorios y la versión de SOAP compatible forman parte del contrato del proveedor.

No des por sentado que SOAP siempre implica llamadas a procedimientos remotos. También puede transportar mensajes orientados a documentos. Del mismo modo, no atribuyas las firmas, el cifrado, la entrega fiable o la coordinación de transacciones únicamente a la envoltura. Una implementación puede utilizar especificaciones adicionales, pero el proveedor debe identificar qué perfiles y comportamientos admite.

La principal cuestión de implementación suele ser la compatibilidad de las herramientas. Obtén la descripción del servicio y los esquemas; a continuación, verifica que un cliente actualizado en tu pila admita las versiones y extensiones pertinentes. El código generado puede reducir el trabajo de serialización, aunque siga dejando sin resolver detalles de negocio, como qué significa una cantidad omitida.

Al comparar estilos de API, evite afirmar que SOAP es automáticamente más lento o más seguro. La estructura de la carga útil es uno de los factores que influyen en el coste; la operación, la ruta de red y la implementación del servicio también son importantes. La seguridad depende de los mecanismos seleccionados y de una autorización correcta, no de la presencia de XML.

Para un proveedor que ya exige SOAP, el diseño más útil puede ser un pequeño adaptador que traduzca los mensajes verificados a tu esquema de catálogo interno. La comparación entre REST y SOAP explica cómo evaluar el contrato real y el comportamiento de recuperación antes de decidir si una interfaz alternativa mejoraría la integración.

GraphQL: solicitar un resultado adaptado a partir de un esquema tipado

GraphQL permite a un cliente describir el resultado solicitado mediante una selección definida por un esquema. En el ejemplo del catálogo, un consumidor podría solicitar el nombre de un producto y determinados campos de stock, dejando fuera de esa operación los campos de descripción no relacionados. El servidor sigue controlando qué campos existen y cómo se resuelven sus valores.

La especificación de GraphQL define el sistema de tipos, el lenguaje de operaciones, la ejecución y la estructura de la respuesta. Incluye operaciones de consulta, mutación y suscripción. GraphQL, por sí solo, no prescribe un diseño de base de datos ni garantiza que todos los resolutores sean eficientes.

La pregunta relevante para un recopilador es si el esquema expone exactamente los datos y las relaciones necesarios. La selección de campos puede hacer explícita la salida solicitada. No garantiza que el servidor realice menos trabajo que con otra interfaz, ni que una operación anidada de gran tamaño resulte económica. Evalúa la operación que permite el proveedor en lugar de basarte en la forma de su sintaxis.

Examina con cuidado los errores y la posibilidad de valores nulos. Un resultado de GraphQL puede contener tanto datos como errores, por lo que aceptar el resultado completo solo porque se ha completado una solicitud de transporte puede hacer que se pase por alto un fallo parcial. Define qué campos son necesarios para un registro aceptado y si los datos parciales deben conservarse, reintentarse o ponerse en cuarentena.

La paginación también sigue siendo un contrato de la aplicación. Familiarízate con los argumentos del proveedor, el significado del cursor, los límites de página y los indicadores de finalización. No des por sentado que todas las API de GraphQL exponen el mismo patrón de conexión ni que se pueda construir un cursor a partir de un número de página.

Los estilos de API no eliminan las decisiones de control de acceso. El hecho de que un campo aparezca en el esquema no garantiza que tu cuenta pueda recuperar todas sus instancias. En el caso del catálogo, prueba una pequeña consulta permitida, confirma el significado de cada campo seleccionado y conserva la versión de la operación junto con tu lógica de extracción. Esto facilita distinguir un cambio posterior en el esquema de una falta de datos temporal.

RPC: invocar una operación con nombre a través de una red

Los modelos de llamada a procedimientos remotos presentan una interfaz en términos de operaciones con nombre y sus entradas y salidas. En el escenario del catálogo, una operación podría calcular el stock disponible de un producto y un almacén. La interfaz se centra en la acción y su contrato, en lugar de dar por sentado que toda interacción del dominio es una simple recuperación de registros.

RPC es un modelo amplio, no un formato de serialización concreto. gRPC es un marco concreto con definiciones de servicios, código de cliente generado y compatibilidad con métodos unarios y de streaming. Su documentación sobre conceptos básicos explica esos patrones y el papel de los plazos.

Los métodos de cliente generados pueden hacer que el código de integración sea conciso. También pueden ocultar el momento en el que la ejecución cruza un límite de red. El sistema remoto puede finalizar el trabajo después del plazo límite del llamante, o el llamante puede fallar antes de recibir un resultado. Trata esos resultados como parte del contrato, incluso si el código fuente se asemeja a una llamada a una función local.

En el caso de una operación de lectura, decide si es aceptable realizar otro intento y si el resultado necesita una marca de tiempo de observación. Para una operación que reserva existencias, exige un mecanismo documentado de prevención de duplicados o de conciliación. Un método de cliente práctico no garantiza una ejecución empresarial «exactamente una vez».

Compara los estilos de API teniendo en cuenta toda la ruta de implementación. Verifica que tu entorno de ejecución, la pasarela, las herramientas de observabilidad y el cliente elegido sean compatibles con el protocolo y los tipos de operación del proveedor. Una operación de streaming también necesita una política para volver a conectarse e identificar qué resultados se aceptaron antes de que finalizara la conexión.

Para el equipo del catálogo, el RPC puede ser un límite interno adecuado para un servicio de cálculo, mientras que una interfaz pública diferente exponga los resultados. Esa combinación no es contradictoria. Mantén el contrato de operación interno separado de la representación externa, de modo que un cambio en uno de ellos no redefinan silenciosamente lo que los consumidores posteriores entienden por valor de inventario.

Webhooks: recibir eventos en lugar de solicitar información repetidamente

Un webhook cambia quién inicia la entrega. Un proveedor envía una solicitud relacionada con un evento a un punto final que gestionas tú después de que se produzca un evento al que te has suscrito. En el caso del catálogo hipotético, una notificación de cambio en un producto puede indicar a tu sistema que puede ser necesario actualizar un artículo. La documentación sobre webhooks de GitHub ofrece un ejemplo concreto de proveedor de este patrón activado por eventos.

Los webhooks no sustituyen por completo a una interfaz de consulta. Una notificación puede contener el registro completo relevante, solo los campos modificados o un identificador que tu consumidor debe recuperar por separado. Averigua qué interpretación se aplica antes de decidir que la carga útil del evento puede sustituir directamente a tu producto almacenado.

Las garantías de entrega forman parte del contrato del proveedor. Determina si se realizan reintentos, cómo se inspeccionan las entregas fallidas, si los eventos tienen identificadores estables y cómo se describe el orden de entrega. Diseña un mecanismo para gestionar duplicados si el comportamiento de entrega documentado lo requiere. No des por sentado que se realizará una reentrega automática simplemente porque otro proveedor lo ofrezca.

El punto final receptor tiene su propia tarea. Verifica la solicitud utilizando el mecanismo documentado por el proveedor, valida el tipo de evento y la carga útil, y separa la aceptación de una entrega de la finalización del procesamiento posterior. Si acusas recibo antes de registrar el evento de forma permanente, un fallo posterior puede dejar sin pruebas locales del trabajo que el remitente considera entregado.

Los estilos de API pueden complementarse entre sí en este caso. Una API de catálogo puede proporcionar el conjunto de datos inicial y una lectura de recuperación, mientras que los webhooks provocan actualizaciones selectivas. Tras una interrupción del servicio, la conciliación puede comparar el estado actual de la fuente con las observaciones almacenadas, en lugar de dar por sentado que el flujo de notificaciones estaba completo.

Trata la hora del evento, la hora de recepción y la hora de actualización como valores distintos cuando sean relevantes para los usuarios. Describen momentos diferentes. La guía sobre flujos de trabajo automatizados de web scraping profundiza en el procesamiento duradero y la propiedad de los trabajos, cuestiones que siguen siendo importantes tanto si el nuevo trabajo comienza con una programación como si lo hace a partir de una notificación entrante.

Elige una combinación en torno a los fallos y la recuperación

Redacta tres escenarios de fallo antes de seleccionar los estilos de API: una solicitud agota el tiempo de espera, un campo deja de estar disponible y tu recopilador está desconectado mientras la fuente cambia. A continuación, pregúntate cómo la interfaz propuesta te permite detectar y recuperarte de cada escenario. Un diseño que solo parece elegante cuando todos los mensajes se envían con éxito es incompleto.

Requisito

Pregunta útil para el proveedor o el diseñador

Recuperar el estado actual

¿Qué identifica un registro y cómo se interpreta su representación?

Solicitar un resultado específico

¿Puede el consumidor seleccionar campos y cómo se controla el coste de la consulta?

Iniciar un proceso de negocio

¿Qué ocurre cuando el resultado es incierto o la solicitud se repite?

Recibir cambios

¿Cuáles son las reglas de entrega, ordenación, verificación y recuperación?

Recuperación tras una interrupción del servicio

¿Existe algún proceso compatible de lectura completa, punto de control o conciliación?

Una misma capacidad empresarial puede admitir más de un enfoque. Tu catálogo podría utilizar lecturas de recursos para el estado actual, webhooks para señales de cambio y una operación RPC dentro del servicio. La contrapartida es mantener varios contratos claros en lugar de dar por sentado que una sola etiqueta explica todo el sistema.

Para las interacciones basadas en HTTP, mantén la semántica estándar al implementar reintentos y otros comportamientos compartidos. La semántica HTTP define conceptos como los métodos seguros e idempotentes; una operación específica de la aplicación sigue necesitando una explicación explícita de sus efectos empresariales.

Termina con un breve registro de decisiones: el resultado requerido por el consumidor, las interfaces seleccionadas, las garantías verificadas y las dependencias sin resolver. Incluye la prueba que revelará una suposición errónea. Por ejemplo, reproduce una entrega permitida y confirma que no duplica el trabajo aceptado, o interrumpe una lectura y verifica el comportamiento del punto de control.

El objetivo de comparar estilos de API es hacer visibles esas decisiones. No es necesario encasillar cada interacción en una sola categoría cuando una combinación documentada se ajusta mejor al ciclo de vida real de la colección.

Puntos clave

  • Separa las categorías antes de comparar estilos de API: REST limita la arquitectura, SOAP estructura los mensajes, GraphQL da forma a las consultas, RPC nombra las operaciones y los webhooks entregan eventos.
  • Solicita pruebas del contrato real, incluidos los errores, las versiones, las reglas de acceso y la recuperación, en lugar de dar por sentadas las garantías que implica una etiqueta.
  • Trata los datos parciales, los resultados inciertos, las entregas duplicadas y las notificaciones perdidas como escenarios de integración explícitos con resultados observables.
  • Combina enfoques cuando satisfagan necesidades diferentes, manteniendo al mismo tiempo límites claros entre las representaciones públicas y las operaciones internas.

Preguntas frecuentes

¿Quién debe encargarse de una prueba de compatibilidad de la API?

Asigna a un responsable del equipo de usuarios que pueda detectar un cambio inesperado en el contrato y remitirlo al proveedor. La prueba debe conservar una pequeña entrada aprobada y su resultado empresarial esperado. Mantén visible la responsabilidad cuando cambien las personas o los proveedores, para que una comprobación fallida no se convierta en una alerta ignorada.

¿Pueden funcionar conjuntamente las versiones antiguas y nuevas de la API?

Sí, cuando el proveedor admita deliberadamente esa transición. Averigua qué consumidores utilizan cada versión, cuánto tiempo durará el solapamiento y qué cambios requieren migración. Prueba ambas versiones con resultados representativos antes de redirigir el tráfico. Un periodo de coexistencia solo resulta útil cuando las obligaciones de soporte y las condiciones de retirada son explícitas.

¿Puede un SDK ocultar por completo el estilo de la interfaz?

Puede ocultar la construcción rutinaria de mensajes, pero no puede eliminar las consecuencias operativas de la interfaz. Sigue siendo necesario comprender los tiempos de espera, los reintentos, los resultados parciales y la compatibilidad. Mantén el acceso a identificadores de solicitud útiles y a diagnósticos depurados, para que una envoltura práctica no se convierta en una barrera cuando falle el servicio subyacente.

Conclusión

El mejor siguiente paso es tomar un requisito de datos real y rastrearlo a través de la documentación del proveedor. Identifica la solicitud o el evento que lo proporciona, los campos que establecen su significado y la evidencia de que la recopilación se completó con éxito. A continuación, sigue el mismo camino con un fallo deliberado en un entorno de pruebas aprobado.

Los estilos de API te ayudan a organizar esa revisión, pero no la sustituyen. Una interfaz de recursos con una paginación poco clara puede resultar difícil de manejar; una interfaz orientada a operaciones con un contrato de recuperación preciso puede ser sencilla. Da prioridad al comportamiento explícito y a las herramientas mantenidas frente a las suposiciones sobre lo que una categoría debería proporcionar.

Si la información necesaria solo está disponible a través de páginas web, evalúa la API Scraper de WebScrapingAPI como una fuente de recopilación adicional. Somete sus resultados a las mismas reglas internas de validación y procedencia que utilizas para tus otras fuentes, de modo que tu proceso siga siendo comprensible aunque cambien sus entradas.

Acerca del autor

Robert Munceanu, Desarrollador full-stack @ WebScrapingAPI

Robert Munceanu

Desarrollador full-stack

Robert Munceanu es desarrollador full stack en WebScrapingAPI, donde colabora en todas las áreas del producto y ayuda a crear herramientas y funciones fiables que respaldan la plataforma.

Tutorial de Python de Nodriver: Extracción de datos de navegadores de forma sigilosa, desde el primer script hasta la puesta en producción
La ciencia del web scraping

Tutorial de Python de Nodriver: Extracción de datos de navegadores de forma sigilosa, desde el primer script hasta la puesta en producción

TL;DR: En resumen: Nodriver es una biblioteca asíncrona de Python que controla Chromium mediante el Chrome DevTools Protocol, sin Selenium ni el binario chromedriver. Úsala cuando un navegador sigiloso autoalojado, más parecido a una sesión real de Chrome, sea mejor opción que una pila WebDriver, pero ten en cuenta que por sí sola no elimina los riesgos de IP, TLS o comportamiento. Este tutorial va desde un primer script hasta la producción en contenedores y una Browser API alojada.

Suciu Dan15 min read
Leer artículo
Cómo gestionar las URL de redireccionamiento de Google /goto y los tokens CAES en un rastreador de SERP
La ciencia del web scraping

Cómo gestionar las URL de redireccionamiento de Google /goto y los tokens CAES en un rastreador de SERP

TL;DR: En resumen: Las URL /goto de Google con un token CAES, y los envoltorios /url más antiguos, son capas de redirección, no destinos, así que un scraper de SERP que trata cada href como final rompe el seguimiento de posiciones y los almacenes de enlaces. Prefiere una API de SERP estructurada cuando devuelva los enlaces de destino. Si tienes que analizar HTML, clasifica cada href, elimina redirecciones duplicadas y resuélvelas con un GET simple. No descifres CAES.

Suciu Dan13 min read
Leer artículo
Cabeceras de Respuesta HTTP en cURL: Cada Bandera, Técnica y Receta de Scripting
La ciencia del web scraping

Cabeceras de Respuesta HTTP en cURL: Cada Bandera, Técnica y Receta de Scripting

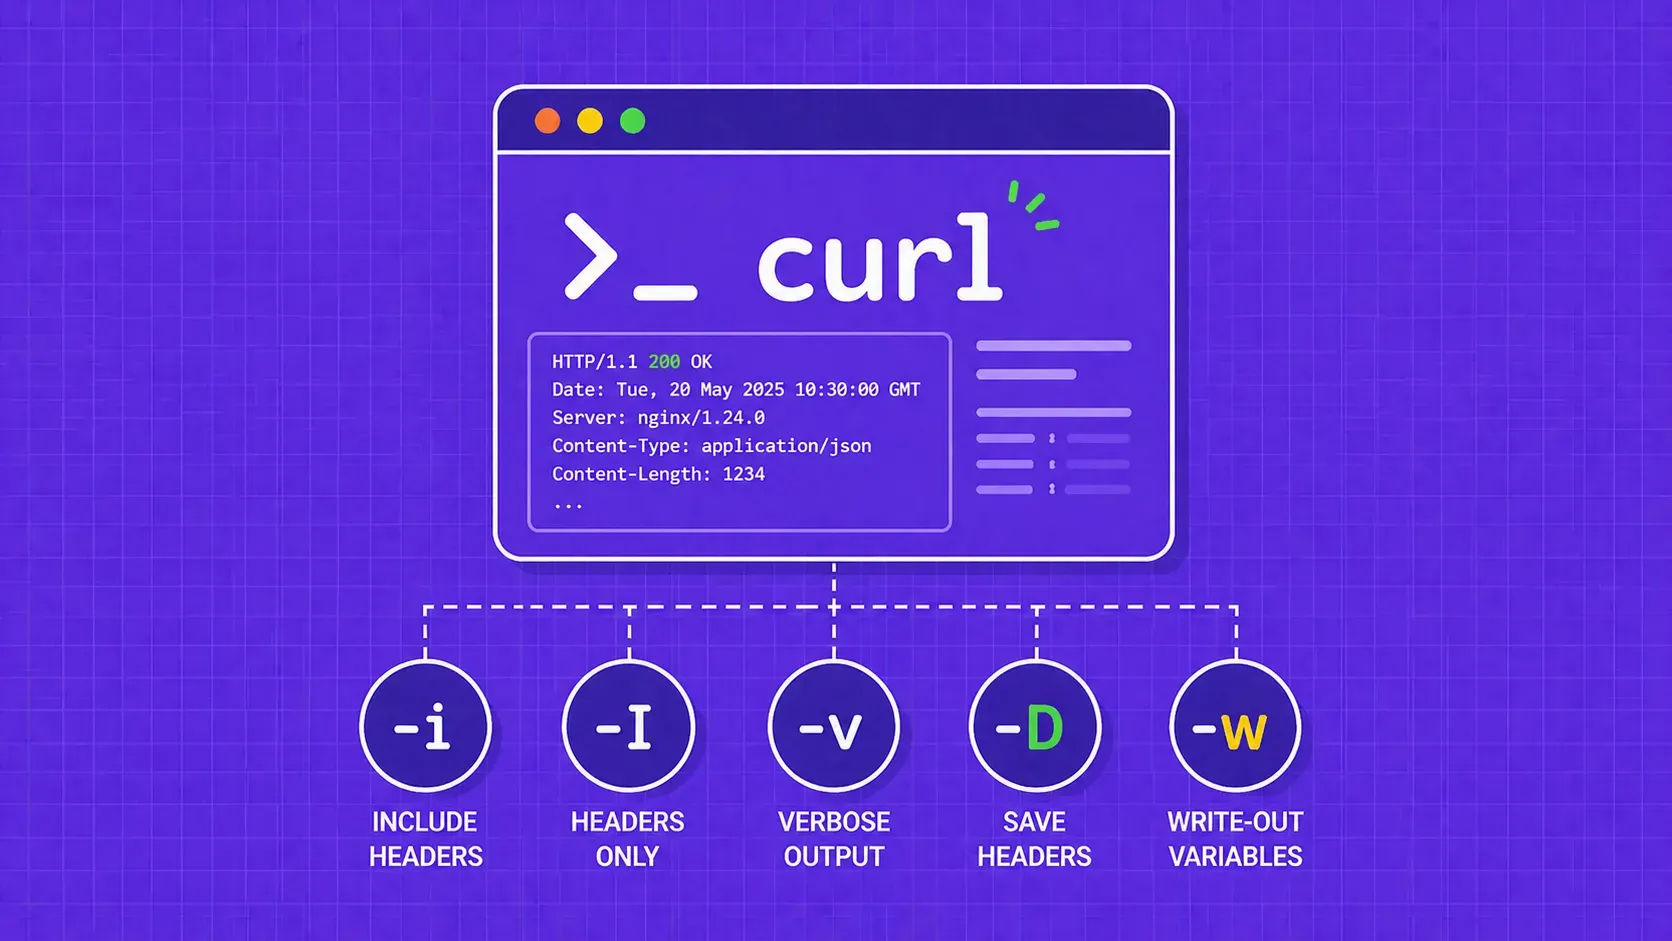
TL;DR: cURL oculta las cabeceras de respuesta por defecto. Utilice -i para ver las cabeceras junto con el cuerpo, -I para una solicitud HEAD que sólo devuelva cabeceras, -v para una depuración completa de solicitud/respuesta y -D para guardar las cabeceras en un archivo. Para scripts modernos, cURL 7.83+ le permite extraer cabeceras individuales o volcarlas todas como JSON con la opción -w write-out.

Suciu Dan13 min read
Leer artículo

Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.