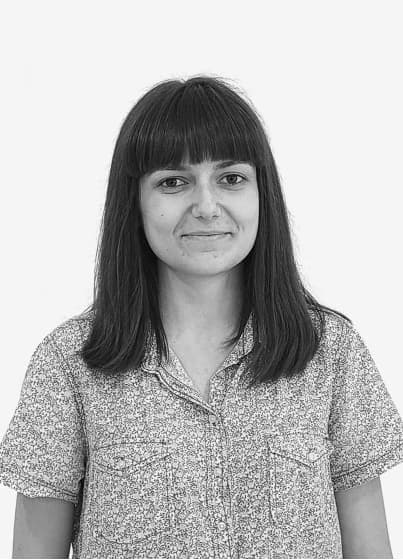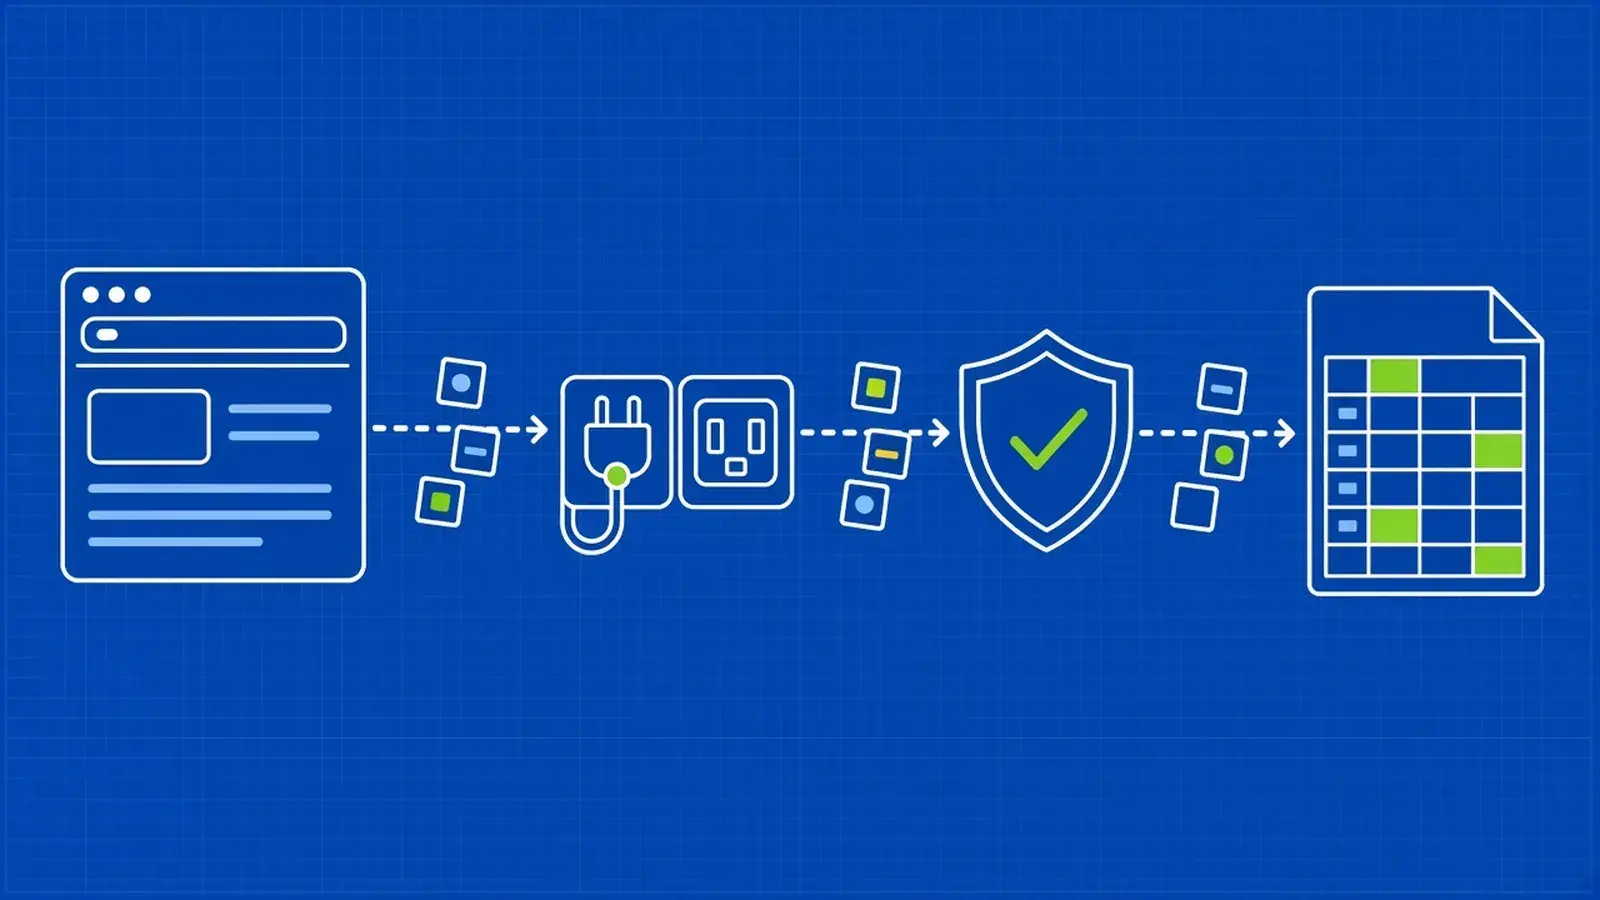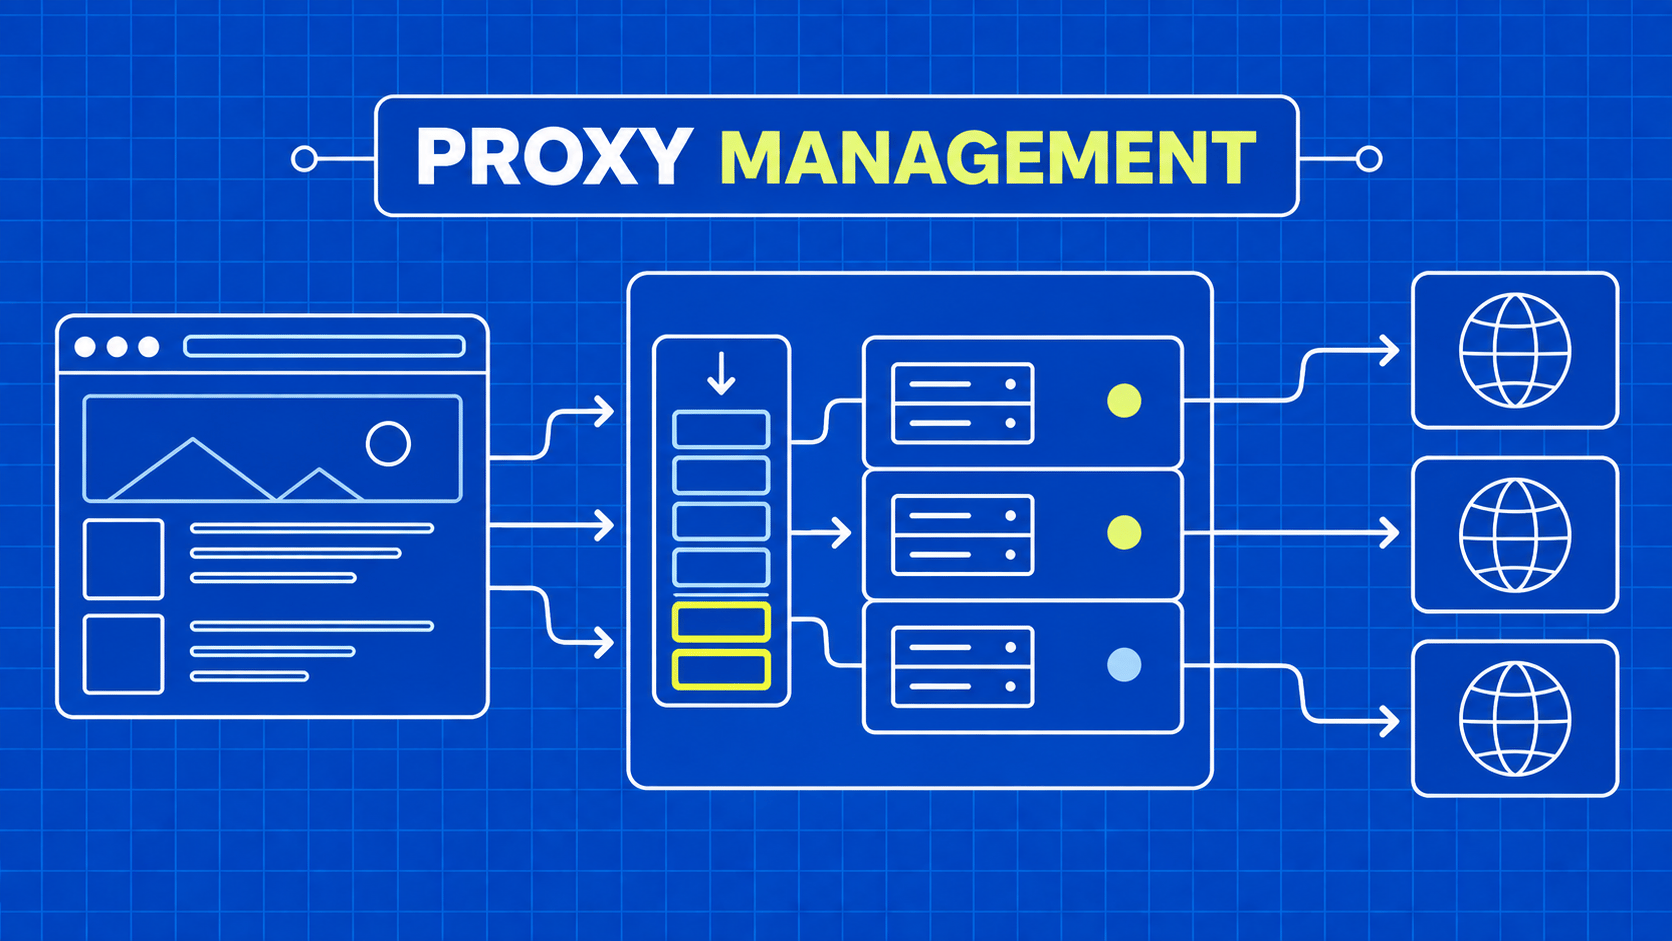
En resumen: La gestión de proxies para el web scraping es la capa de políticas que asigna las tareas autorizadas a las rutas de red adecuadas y realiza un seguimiento de lo que ocurre a continuación. Mantén separados el estado de la sesión, el estado de la ruta y los presupuestos de solicitudes de origen. Rota o retira una ruta por una razón operativa documentada, no como respuesta automática a cada página que no se pueda cargar.
Un trabajador recibe una página de producto vacía y marca su proxy como inactivo. Otro trabajador toma inmediatamente una nueva ruta y repite la solicitud. Tras varios intentos, el grupo de rutas parece no estar en buen estado, pero el fallo real se debe a que el analizador espera un elemento que la fuente ha eliminado.
Eso es un problema de gestión antes que un problema de red. El sistema tomó una decisión de enrutamiento basándose en información de la capa equivocada. Añadir más direcciones agrandaría el error, no lo corregiría.
Un gestor de proxies útil hace algo más que elegir el siguiente punto final. Sabe qué tareas requieren continuidad, qué rutas cumplen los requisitos de ubicación aprobados, cuánto tráfico puede recibir la fuente y cuándo un operador debe revisar un fallo. Su éxito se mide por las observaciones válidas proporcionadas dentro de la política de recopilación, no por la frecuencia con la que cambia de direcciones.
Esta guía describe ese diseño para desarrolladores que gestionan recopiladores autorizados. Los ejemplos son recomendaciones de arquitectura originales, no una referencia de proveedores. Puedes aplicar los mismos límites tanto a un pequeño trabajador basado en una configuración como a un servicio de recopilación compartido de mayor envergadura.