Saltar al contenido
Empezar gratis

Blog

Perspectivas e ingeniería

Análisis en profundidad de la infraestructura de datos web, las técnicas de extracción y el futuro de los datos estructurados a gran escala.

Últimos artículos

156 artículos

Extracción de datos de la web en C y C++ con libcurl y lexbor
Guías

Extracción de datos de la web en C y C++ con libcurl y lexbor

TL;DR: Extrae datos de páginas web en C y C++ con libcurl y lexbor: crea un rastreador C++20 «educado» con CMake y vcpkg, exporta archivos CSV y JSON limpios, gestiona páginas con JavaScript de tres formas diferentes y ejecuta el mismo rastreador en C puro.

Raluca Penciuc29 min read
Leer artículo
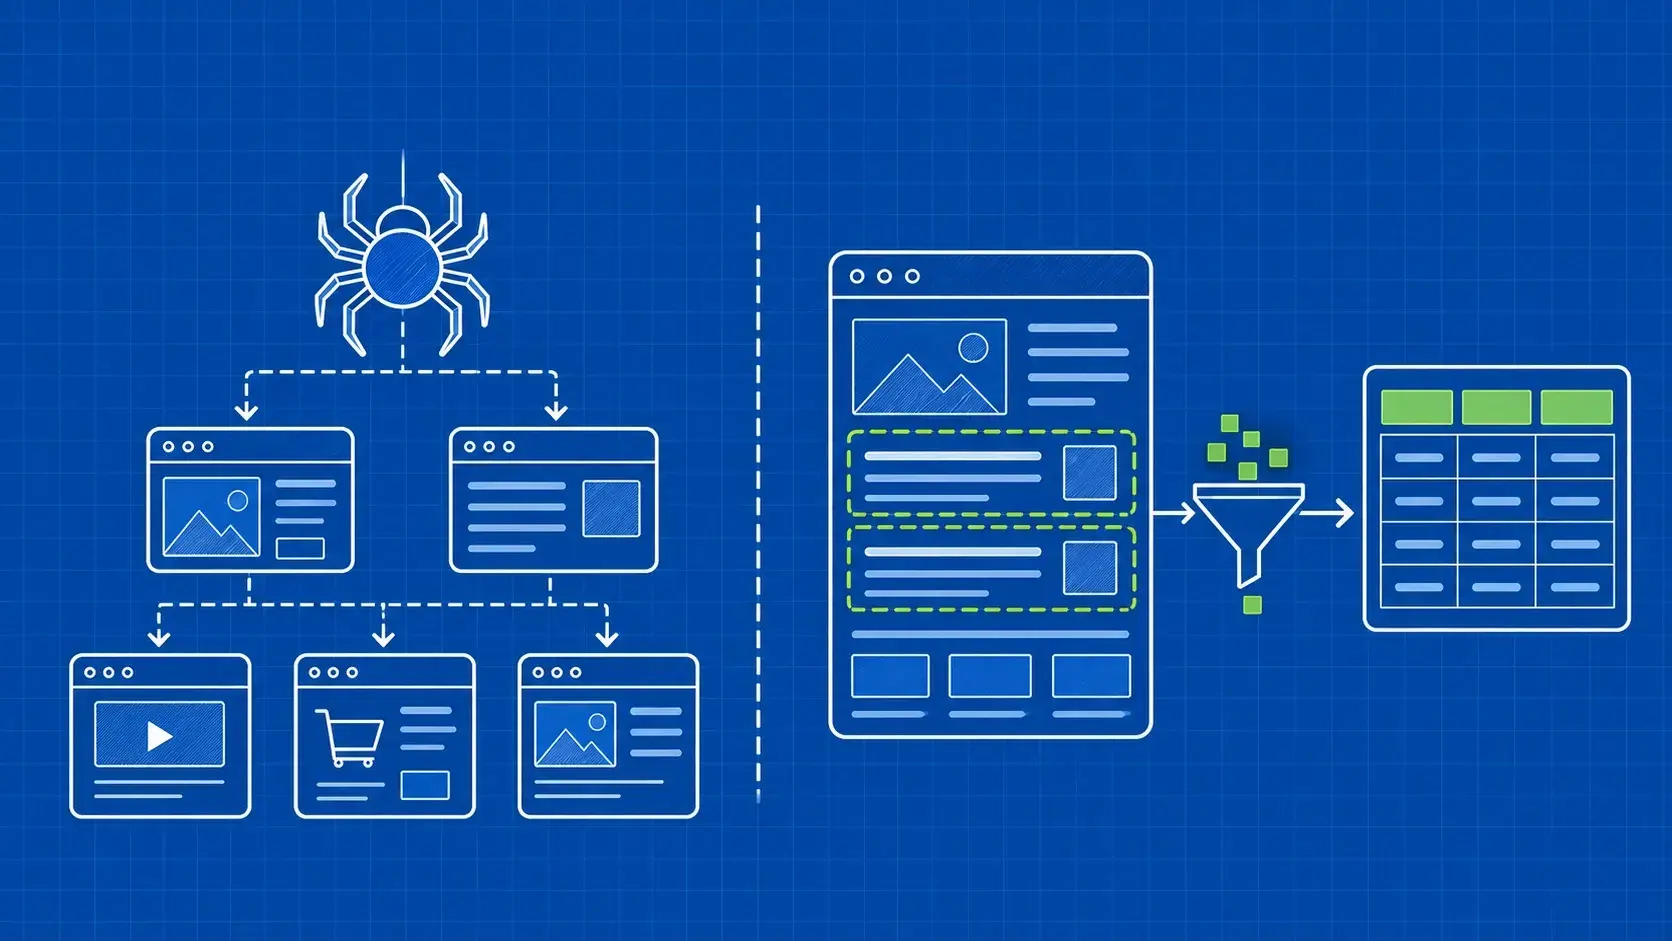
Web scraping frente a web crawling: una guía para principiantes
La ciencia del web scraping

Web scraping frente a web crawling: una guía para principiantes

TL;DR: Descubre cómo los rastreadores encuentran páginas y cómo los extractores recogen datos útiles. Sigue el ejemplo de una librería, compara los resultados y elige el flujo de trabajo adecuado para tu primer proyecto.

Anda Miuțescu13 min read
Leer artículo
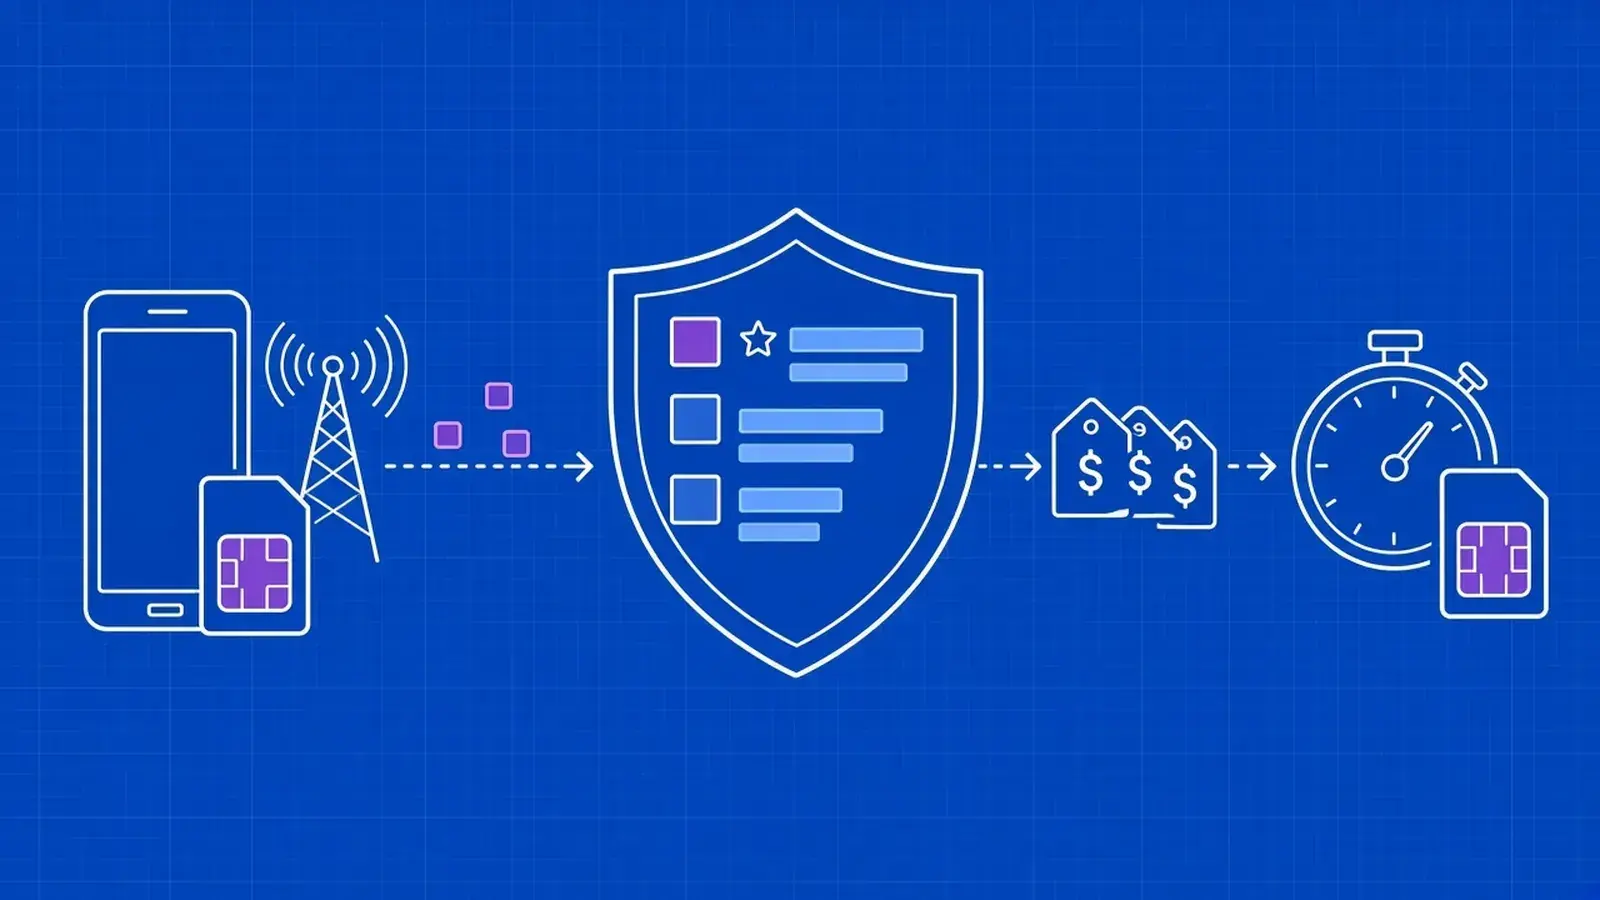
Los mejores proxies móviles para web scraping en 2026: 9 proveedores clasificados
La ciencia del web scraping

Los mejores proxies móviles para web scraping en 2026: 9 proveedores clasificados

TL;DR: Compara 9 proveedores de proxies móviles para scraping por precio por GB o por puerto, segmentación por operador y ASN, 5G, sesiones fijas y pruebas, a octubre de 2026.

Sergiu Inizian27 min read
Leer artículo
Buenas prácticas en el scraping web: una guía práctica sobre el ciclo de vida con consejos y código funcional
La ciencia del web scraping

Buenas prácticas en el scraping web: una guía práctica sobre el ciclo de vida con consejos y código funcional

TL;DR: Buenas prácticas de web scraping para cada etapa del ciclo de vida de un scraper: planificar los datos, respetar el archivo robots.txt tal y como lo define el RFC 9309, regular la frecuencia de acceso a cada servidor y respetar el encabezado Retry-After, realizar un análisis defensivo, validar cada registro, supervisar las ejecuciones, comprobar el progreso y realizar un seguimiento del coste por registro válido. Cada etapa incluye un fragmento de código Python breve y funcional.

Anda Miuțescu35 min read
Leer artículo
Web scraping para el SEO: cómo elaborar una auditoría basada en datos
Casos de uso

Web scraping para el SEO: cómo elaborar una auditoría basada en datos

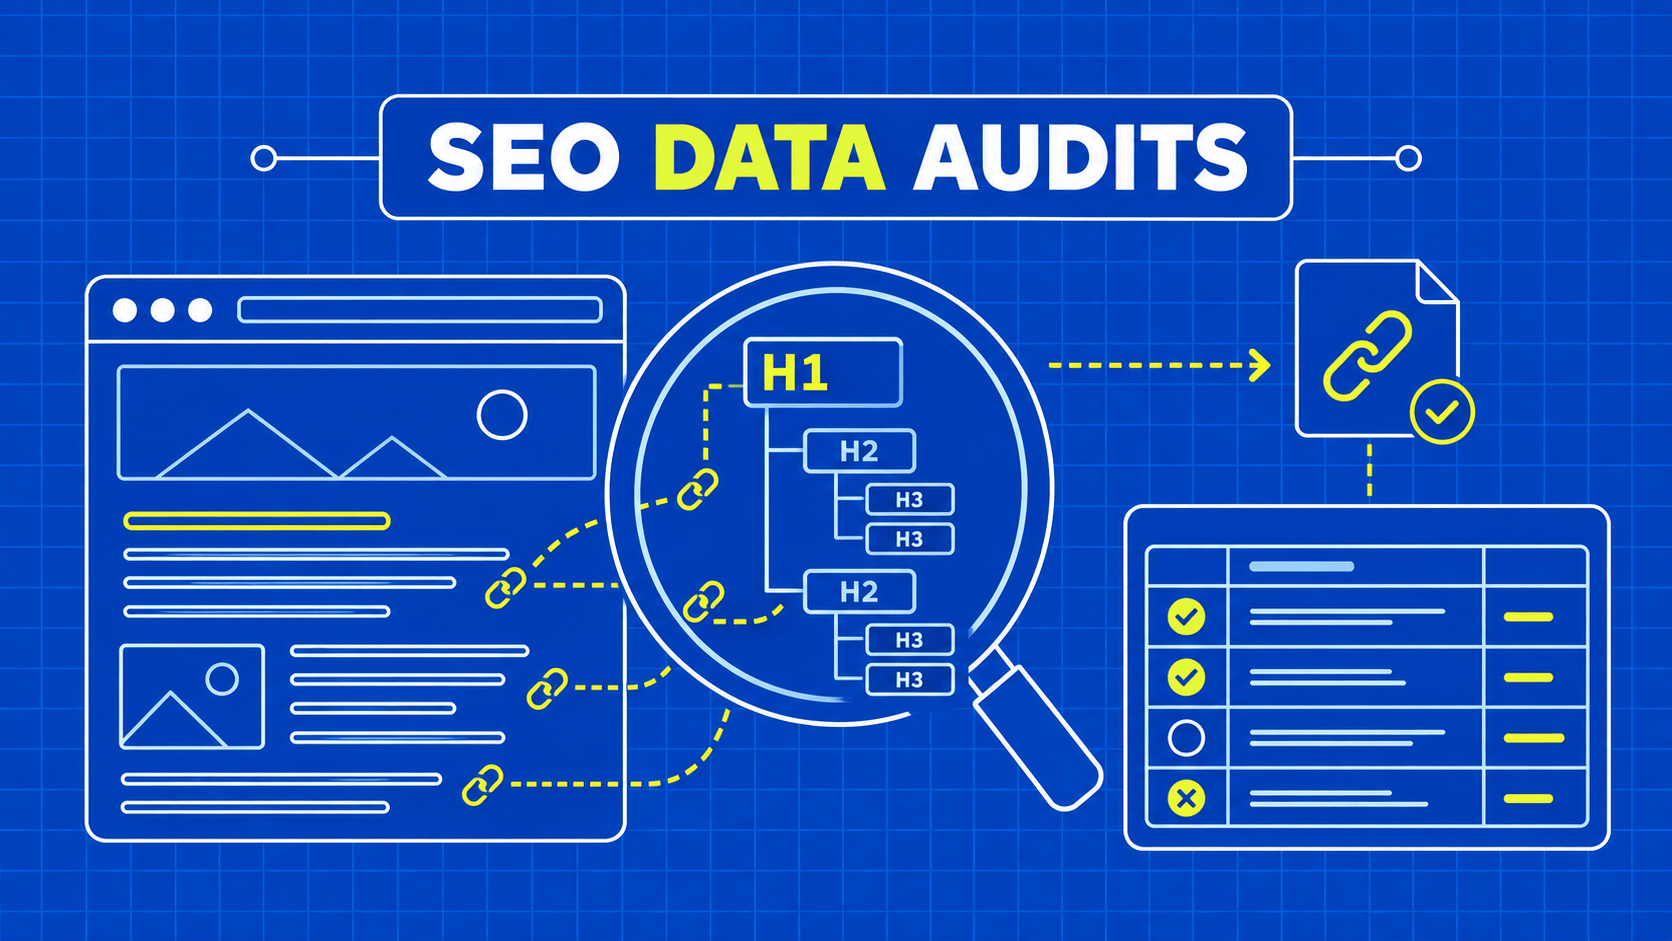
TL;DR: Realiza una auditoría de SEO contrastada que distinga los datos observados en las páginas de los resultados de los motores de búsqueda. Compara la visualización, las señales canónicas, las directivas y los errores en las plantillas.

Gabriel Cioci16 min read
Leer artículo
Consejos sobre la API REST para una recopilación de datos fiable
Ingeniería

Consejos sobre la API REST para una recopilación de datos fiable

TL;DR: Diseña API que los recopiladores puedan utilizar de forma fiable. Define la paginación, los reintentos, los validadores, la autenticación, la evolución del esquema y la recuperación como contratos explícitos.

Robert Sfichi18 min read
Leer artículo

Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.