Saltar al contenido
Empezar gratis
Volver al blog

Ventajas de la API de web scraping: lo que realmente externalizas

Anda MiuțescuÚltima actualización el 16 min read
Ventajas de la API de web scraping: lo que realmente externalizas
En resumen: una API de web scraping puede externalizar la obtención de datos, la gestión de proxies o la ejecución del navegador fuera de tu aplicación, dependiendo del servicio. La extracción estructurada es una capacidad independiente, y ni una solicitud exitosa ni un JSON válido garantizan que los datos sean utilizables. Evalúa la responsabilidad que delegas, los registros que aceptas y el trabajo de recuperación del que sigues siendo responsable.

Una API de web scraping es una interfaz de servicio a través de la cual tu aplicación solicita contenido de páginas web o datos extraídos. Su ventaja más importante es un cambio en la responsabilidad operativa: tu equipo puede utilizar un servicio definido en lugar de mantener cada componente que obtiene la página.

Piensa en una tarea diaria de catalogación. Ayer se recabaron todas las páginas, pero la ejecución de hoy se dedica a reiniciar los navegadores. Contratar un servicio de extracción podría ayudar, pero solo si asume la responsabilidad que falla. Un servicio que devuelve HTML sin procesar sigue dejándote a ti la extracción de campos. Una respuesta estructurada sigue requiriendo comprobaciones para verificar que el producto, la moneda y la hora de observación sean correctos.

Esta guía explica las ventajas de las API de web scraping sin considerar una API como una plataforma de datos completa. Verás qué tareas pueden delegarse a un proveedor, cuáles deben quedarse en tu aplicación y cómo evaluar si el cambio merece la pena. Los ejemplos sirven de orientación sobre la arquitectura, no son comparativas de proveedores ni pretenden afirmar que todos los servicios ofrezcan las mismas características.

Asigna las ventajas de las API de web scraping a las responsabilidades

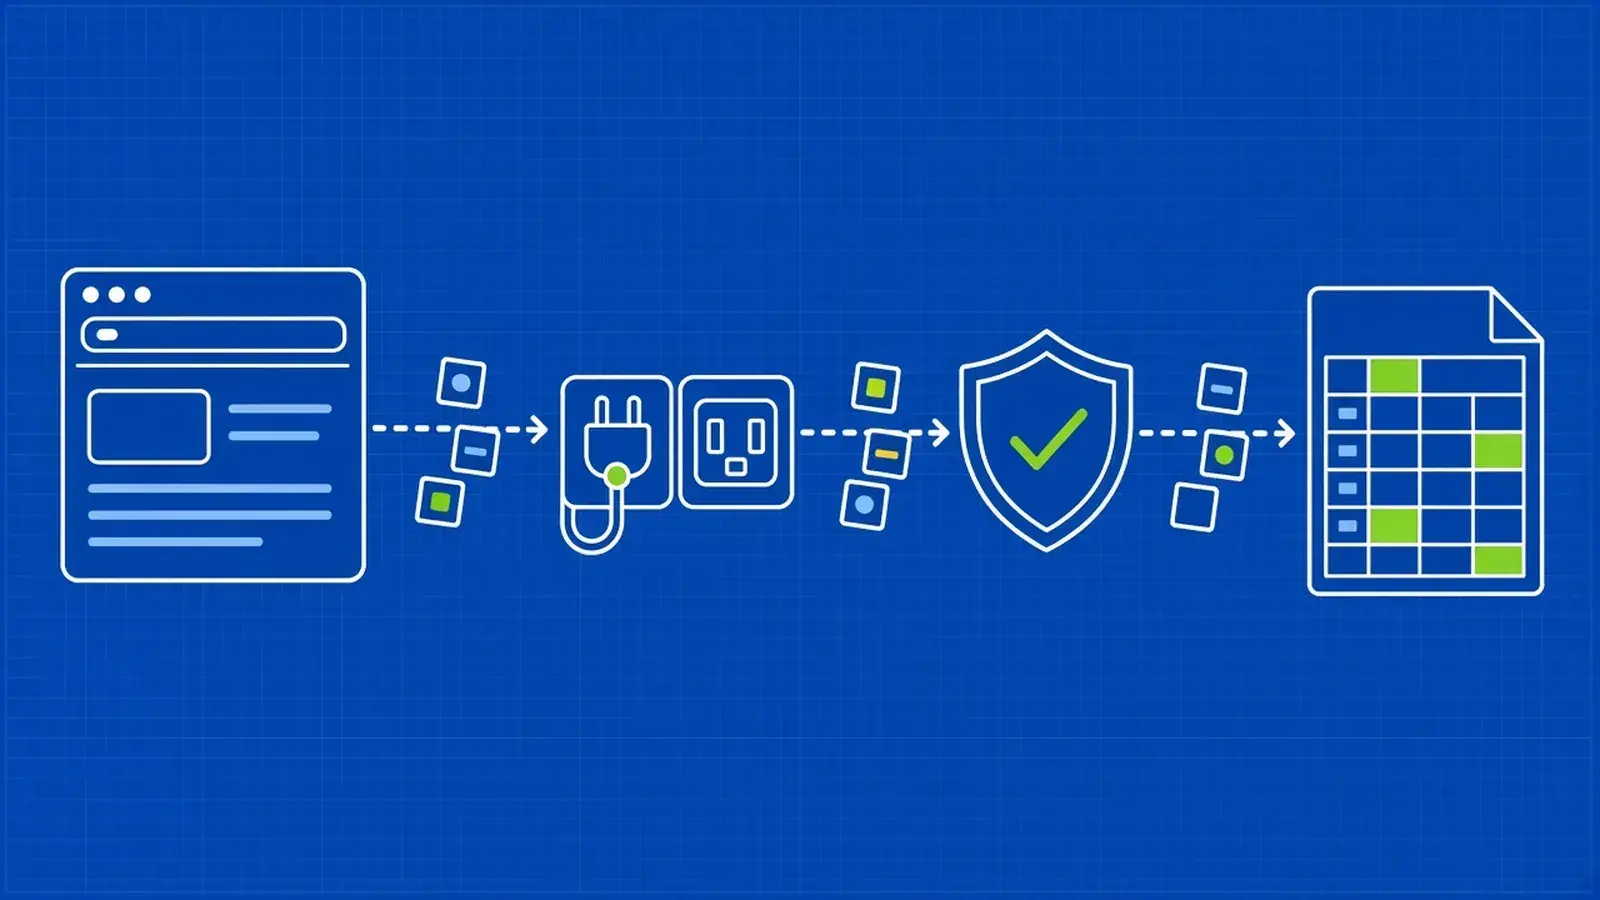
Empieza por delimitar lo que el servicio promete realmente. La recuperación (fetching) obtiene una representación de una página. La visualización (rendering) ejecuta un entorno de navegador para obtener contenido afectado por scripts e interacciones. La extracción transforma el contenido de origen en campos. Un proceso de producción programa el trabajo, valida los resultados, gestiona el estado y entrega los registros a los consumidores.

Estas responsabilidades pueden agruparse, pero no son sinónimos. Un punto final de solicitud gestionado puede devolver HTML sin extraer campos. Un servicio de navegador puede permitirte ejecutar interacciones sin decidir qué elementos pertenecen a tu conjunto de datos. Una API de extracción puede reconocer un tipo de registro compatible sin implementar tus reglas de aceptación empresarial.

Responsabilidad

Ventaja potencial de la API

Responsabilidad de verificar o conservar

Recuperación HTTP

Infraestructura de solicitudes gestionadas

Destinos aprobados y validación de respuestas

Ejecución en el navegador

Menos trabajo de alojamiento y gestión del ciclo de vida del navegador

Interacciones necesarias y criterios de finalización

Extracción de campos

Salida estructurada compatible

Significado, integridad y compatibilidad con el esquema

Recuperación

Errores documentados o reintentos por parte del servicio

Plazos de los trabajos, deduplicación y política de repetición

Entrega

Exportaciones opcionales o integraciones de almacenamiento

Contratos con los usuarios y política de retención

Utiliza esta tabla como lista de comprobación para la adquisición. Marca cada funcionalidad como incluida, opcional, no compatible o desconocida. A continuación, asigna un responsable a cada tarea pendiente. Es mejor dejar algo explícitamente como «desconocido» que tener un diagrama que da por sentado que el proveedor se encarga de todo lo que hay entre una URL y un panel de control.

Este límite también garantiza la imparcialidad de una prueba. Compara un extractor gestionado con el trabajo de extracción que sustituye, no con toda una plataforma de análisis mantenida manualmente. Compara una plataforma más completa con su conjunto más amplio de responsabilidades, incluidas las nuevas restricciones que introduce.

Reduce las operaciones de obtención de datos y del navegador allí donde resulten problemáticas

La primera ventaja práctica es que tu equipo tiene que gestionar menos componentes. Dependiendo del producto, un proveedor puede gestionar el enrutamiento de solicitudes, la capacidad del navegador o el entorno en el que se ejecutan las interacciones con la página. Tu aplicación llama a un límite de servicio en lugar de tener que aprovisionar y diagnosticar cada componente subyacente por sí misma.

La representación es un ejemplo útil. La documentación sobre automatización del navegador de un servicio gestionado describe las solicitudes y acciones específicas del navegador por separado de la recuperación HTTP habitual. Esa separación es importante porque recuperar el cuerpo de una respuesta y observar una página tras la ejecución de scripts son operaciones diferentes. La compatibilidad con el navegador de un proveedor debe evaluarse en función de tu interacción real, no deducirse de la afirmación de que gestiona JavaScript.

Identifica la condición de finalización para cada tipo de página. Que aparezca el título de un producto puede ser suficiente para un recopilador; otro debe esperar a que se produzca una interacción permitida con el filtro y a que se rellene una tabla. Una espera arbitrariamente larga no constituye un contrato de aceptación. Comprueba si el servicio puede expresar e informar de la condición que requiere tu flujo de trabajo.

Mantén ligeras las páginas ligeras. Si el contenido necesario ya se encuentra en la respuesta inicial, la ejecución en el navegador puede suponer un trabajo adicional sin aportar información. Nuestra comparación de clientes HTTP de Python para el scraping web resulta útil cuando un cliente convencional sigue siendo suficiente para parte de la carga de trabajo.

Las operaciones gestionadas son más valiosas cuando eliminan una carga recurrente que puedas identificar. Anota esa carga antes de la prueba: fallos al iniciar el navegador, mantenimiento de la infraestructura o incidencias en el enrutamiento de solicitudes. Después, comprueba si realmente ha disminuido o si simplemente se ha trasladado a tickets de soporte menos visibles.

Consigue resultados estructurados sin confundirlos con la realidad

Una API de extracción estructurada puede reducir la cantidad de análisis específico del sitio que tienes que mantener. Eso supone una ventaja real cuando los tipos de registros admitidos se ajustan a tu tarea. Por ejemplo, la documentación sobre extracción automática describe tipos estructurados para productos, artículos y ofertas de empleo, con controles sobre la fuente utilizada para la extracción. Se trata de una capacidad documentada del producto, no de una garantía de corrección para todas las páginas.

Define tu propio esquema de aceptación antes de probar uno. Para una observación de catálogo, exige un identificador de fuente, una URL canónica de la fuente, la marca de tiempo observada, la moneda y los campos necesarios para el cálculo posterior. Decide qué valores ausentes son aceptables y cuáles deben poner el registro en cuarentena. Un objeto sintácticamente válido puede seguir describiendo la variante incorrecta.

Mantén las observaciones sin procesar separadas de los valores comerciales normalizados. Un precio mostrado puede incluir un rango, un descuento o un formato decimal dependiente de la configuración regional. Si lo normalizas, conserva suficiente información de procedencia para explicar la transformación. No conviertas silenciosamente un precio ausente en cero ni una etiqueta de disponibilidad ausente en una afirmación positiva.

El mismo principio se aplica si mantienes tu propio analizador sintáctico. La documentación sobre el flujo de trabajo de elementos de Scrapy trata la validación, la limpieza y la persistencia como responsabilidades explícitas del procesamiento. Trasladar la obtención de datos a una API no hace que esas responsabilidades desaparezcan; solo cambia la procedencia de su entrada.

Añade casos de prueba de regresión para variaciones importantes de las páginas. Cuando cambie la salida, determina si ha cambiado la fuente, si el proveedor ha modificado el comportamiento de extracción o si ha cambiado tu propia normalización. Separar estas capas permite investigar sin tener que declarar que todo el proceso es poco fiable ni aceptar un error sutil en los datos solo porque la respuesta parecía bien formada.

Utiliza los errores de servicio para crear una recuperación acotada

Un contrato de errores documentado puede ser más fácil de integrar que un conjunto de excepciones de bajo nivel, pero aún así se necesita una política de recuperación. Distingue entre entradas no válidas, fallos de autenticación, limitación del proveedor, respuestas de la fuente y extracción fallida. Cada uno de ellos requiere acciones diferentes. Repetir una solicitud no válida con la misma carga útil no es resiliencia.

Las API gestionadas pueden exponer su propio estado y también describir el resultado esperado. Lee ambos niveles cuando estén disponibles. Nuestra guía de resolución de problemas de errores de proxy explica el problema general de atribuir un fallo al salto correcto. La misma disciplina se aplica cuando el intermediario es una API en lugar de un proxy configurado.

La documentación del proveedor debería especificar qué errores admiten reintentos. Por ejemplo, la guía de gestión de errores de un servicio gestionado distingue la limitación de tráfico de las solicitudes fallidas y documenta el comportamiento de retroceso. Tu aplicación debería seguir imponiendo un plazo de negocio y unos límites de gasto en torno a la tarea global. Una solicitud que podría acabar teniendo éxito puede perder todo su valor una vez transcurrido su plazo de entrega.

Conserva el estado del trabajo independientemente del proceso que lo ejecute. Registra los resultados en cola, intentados, aceptados, en cuarentena y con fallo definitivo. Utiliza identificadores de trabajo estables para que la reproducción pueda actualizar o deduplicar registros en lugar de añadir duplicados. Una respuesta de la API no demuestra que la escritura en tu base de datos se completara antes de que se colgara un trabajador.

Prueba la recuperación de forma deliberada con fixtures o en un entorno de pruebas controlado. Interrumpe un trabajador tras recibir una respuesta, pero antes de confirmar la tarea. Confirma que al reintentar se obtiene un resultado empresarial aceptado. La ventaja operativa no es que los fallos desaparezcan, sino que el límite del servicio proporciona a tu equipo un conjunto más reducido y documentado de fallos que gestionar.

Escala dentro de unos límites en lugar de dar por sentado un rendimiento ilimitado

Un servicio puede reducir el trabajo de gestión de la capacidad sin proporcionar una capacidad ilimitada. Comprueba los límites de frecuencia, los límites de trabajos simultáneos, los límites de tamaño de respuesta, los plazos de solicitud y cualquier restricción que varíe según el destino o la característica. Estos límites afectan tanto al rendimiento como al comportamiento que debe tener tu programador.

Por ejemplo, la documentación sobre límites de tasa de un servicio describe límites relacionados con las cuentas y los sitios web. Esto ilustra por qué el límite de una cuenta no es la única restricción que importa. No generalices las unidades o los límites de un único proveedor a todas las API.

Utiliza una cola para suavizar los picos de tráfico y un grupo de trabajadores acotado para evitar que tu propio sistema inicie tareas inmanejables. Separa las fuentes con diferentes presupuestos para que una fuente lenta no acapare a todos los trabajadores. Propaga la contrapresión desde el almacenamiento y la validación en lugar de seguir recuperando datos que no pueden aceptarse.

Mide el tiempo hasta que los datos sean aceptados, no solo la latencia de la solicitud. Una respuesta rápida seguida de una larga acumulación de validaciones pendientes incumple el mismo plazo que una respuesta lenta. Presta atención a la tarea pendiente más antigua y a la antigüedad de las observaciones aceptadas. Esas métricas relacionan el comportamiento de la infraestructura con el propósito real de la tarea de recopilación.

Nuestra guía sobre el scraping web automatizado aborda los trabajos recuperables como un flujo de trabajo completo. Una API puede simplificar una etapa dentro de ese flujo de trabajo. No sustituye la necesidad de programar adecuadamente, respetar las restricciones de las fuentes o detener la recopilación cuando el consumidor posterior no está disponible.

Compara la rentabilidad utilizando los registros aceptados

Las ventajas de las API de scraping web suelen incluir un menor esfuerzo de mantenimiento, pero se trata de una hipótesis que hay que evaluar, más que de un ahorro automático de costes. Un pequeño recopilador que trabaje con páginas estables y autorizadas puede seguir resultando más barato y sencillo con un cliente convencional. Una carga de trabajo que requiera un mantenimiento recurrente del navegador puede beneficiarse mucho más de una ejecución gestionada.

Elige un periodo de referencia y define un registro válido: único, válido según el esquema, contextualmente correcto y entregado antes de su fecha límite. A continuación, compara la factura del proveedor, la infraestructura restante y el trabajo de ingeniería adicional con el número de registros válidos. Utiliza la misma definición tanto para tu sistema actual como para la prueba.

Calcula los efectos de los reintentos, la representación opcional, la extracción estructurada, el trabajo duplicado y los compromisos mínimos según las condiciones comerciales actuales. Un precio de solicitud nominal bajo no tiene sentido si las funciones que necesitas utilizan una unidad de facturación diferente. Por el contrario, un precio de solicitud más alto puede ser razonable si elimina una cantidad considerable de trabajo operativo.

No asignes valores monetarios inventados a cada inconveniente. Realiza un seguimiento del tiempo real dedicado a tareas recurrentes siempre que sea posible y señala las estimaciones. Separa el trabajo de migración puntual de las operaciones recurrentes para que la evaluación no oculte la inversión inicial ni la cobre indefinidamente.

Mantén un resultado a nivel de carga de trabajo en lugar de una media global. Las páginas estáticas, las páginas interactivas y los formatos no compatibles pueden tener resultados diferentes. Una arquitectura híbrida puede ser la solución más sensata: clientes normales para fuentes sencillas y un servicio gestionado para el subconjunto que se beneficie de ello. La complejidad adicional del enrutamiento y el soporte técnico también debe tenerse en cuenta en esa comparación.

Mantén explícita la gobernanza de los datos y la responsabilidad sobre su entrega

Una API añade otra organización a la ruta de los datos. Revisa lo que envías: URL, encabezados, cookies, cuerpos de solicitud y cualquier contenido de origen enviado para su extracción. Utiliza credenciales de servicio en el lado del servidor y manténlas fuera de repositorios públicos, paquetes de navegador y capturas de pantalla de diagnóstico.

Infórmate sobre la retención, los controles de acceso, las ubicaciones de tratamiento y los subencargados del tratamiento para el producto seleccionado. Si el flujo de trabajo incluye datos privados o regulados, involucra a los revisores internos pertinentes antes de realizar una prueba. Empieza con datos no sensibles cuando sea posible. Evita dar por sentado que una integración técnica satisfactoria ha completado el proceso de aprobación de la organización.

La autoridad para la recopilación sigue siendo tu responsabilidad. Da preferencia a una API de origen autorizada o a un feed con licencia cuando cumpla los requisitos. Respeta las instrucciones publicadas para los rastreadores y el alcance de acceso acordado. El Protocolo de Exclusión de Robots establece que las reglas de los rastreadores no constituyen una autorización de acceso, por lo que el manejo de los robots no debe considerarse una decisión de permiso definitiva.

Las funciones de entrega también deben someterse a inspección. Una plataforma puede ofrecer un conjunto de datos o una interfaz de exportación; por ejemplo, la documentación del conjunto de datos describe el almacenamiento de registros estructurados y las formas de recuperarlos. Eso no establece tu política de retención, el esquema de consumo ni las garantías de recuperación. Confirma el comportamiento de la exportación, los permisos de acceso y el procedimiento para extraer los datos antes de convertir el servicio en un elemento central de tu flujo de trabajo.

Asigna un responsable a la eliminación de datos, las reclamaciones de origen y la revocación de credenciales. Estos aspectos rara vez aparecen en un ejemplo de inicio rápido, pero un trabajo de producción sin supervisión los necesita tanto como necesita una función de solicitud.

Realiza una prueba piloto con un contrato de salida

Elige una carga de trabajo representativa y un periodo de evaluación breve y acordado. Registra la carga de mantenimiento del sistema existente y el resultado de los registros aceptados utilizando las mismas métricas que aplicarás a la API. Mantén fijo el presupuesto de solicitudes de origen para que la prueba piloto no genere una carga adicional no deseada.

Crea un adaptador específico entre tu aplicación y el servicio. Asigna la respuesta del proveedor a tu formato de observación interno antes de la validación empresarial. Mantén los metadatos del proveedor disponibles para el diagnóstico, pero no hagas que todos los consumidores dependan de campos de respuesta incidentales. Versiona la asignación para que los cambios sean revisables.

Decide qué ocurre cuando el servicio no está disponible o deja de ser adecuado. Tu contrato de salida debe identificar los registros exportables, la configuración conservada, las reglas de extracción portátiles cuando proceda y el trabajo que habría que reconstruir. No todas las capacidades son portátiles; anota la parte no portátil en lugar de ocultarla tras una abstracción.

Al final de la fase piloto, examina los registros rechazados con el mismo cuidado que los aceptados. Un proveedor que descarta discretamente las páginas difíciles puede parecer excelente si el denominador incluye únicamente los resultados devueltos. Calcula el trabajo previsto originalmente y explica cada categoría de resultados.

Promociona la integración solo si el beneficio operativo, la calidad de los datos y las condiciones comerciales cumplen los criterios predefinidos. De lo contrario, conserva las pruebas y ajusta los límites que estás barajando. Una prueba piloto bien gestionada que rechace un servicio inadecuado habrá evitado, aun así, una decisión arquitectónica costosa.

Puntos clave

  • Trata la recuperación de datos, la ejecución en el navegador, la extracción y las operaciones de la cadena de procesamiento como responsabilidades independientes.
  • Valida el significado y la actualidad de los registros, incluso cuando una API devuelva datos estructurados correctamente.
  • Incluye en el contrato de la aplicación el estado de trabajo duradero, la recuperación limitada y la deduplicación.
  • Mide el coste por registro aceptado junto con el esfuerzo de mantenimiento y los plazos de entrega.
  • Revisa la ruta de los datos y prueba un plan de salida antes de convertir a un proveedor en una dependencia de producción.

Preguntas frecuentes

¿Se puede utilizar una API de extracción de datos desde un flujo de trabajo de hoja de cálculo?

Sí, si la integración circundante puede realizar solicitudes autenticadas y transformar la respuesta en las filas requeridas. Mantén las credenciales en un conector aprobado o en un componente del lado del servidor, en lugar de distribuirlas dentro de una hoja compartida. Decide cómo las actualizaciones identifican las filas existentes, ya que añadir repetidamente la misma observación puede generar totales engañosos, incluso cuando cada solicitud funciona correctamente.

¿Deberían los campos que faltan bloquear todo el conjunto de datos?

No necesariamente. Clasifica los campos según los requisitos de la aplicación consumidora. Puede ser aceptable que falte una descripción opcional, mientras que la ausencia de un identificador puede impedir una deduplicación segura. Mantén los registros rechazados o incompletos separados, indicando los motivos explícitos. Evita establecer una regla general que descarte observaciones útiles o que incluya registros incompletos en cálculos que asumen que todos los campos están presentes.

¿Se pueden reconstruir las páginas de origen históricas a partir de los resultados actuales de la API?

Normalmente no solo a partir de los resultados actuales. Una nueva consulta describe lo que era observable en ese momento, no todos los estados anteriores de la página. Si se requieren comparaciones históricas, diseña una estrategia de observación y retención autorizada antes de que comience la recopilación. Almacena las marcas de tiempo y la procedencia junto con los registros, y evita presentar observaciones posteriores como prueba de lo que una fuente mostraba anteriormente.

Conclusión

Las ventajas más destacadas de las API de web scraping provienen de trasladar una carga operativa claramente definida a un servicio que la gestiona adecuadamente para tu volumen de trabajo. La obtención gestionada puede reducir el trabajo de red. Los navegadores gestionados pueden reducir el mantenimiento de la ejecución. La extracción estructurada puede reducir el trabajo del analizador sintáctico. Se trata de beneficios distintos, y cada uno merece su propia prueba de aceptación.

Mantén visibles las responsabilidades restantes. Tu aplicación sigue necesitando saber qué pretendía recopilar, qué resultados son válidos, cuándo los datos quedan obsoletos y cómo se recupera el trabajo pendiente. La gobernanza, los contratos con los usuarios y una vía de salida deben formar parte del diseño desde el principio, no después de la primera solicitud satisfactoria.

Lleva a cabo una prueba piloto limitada con páginas representativas, un gasto acotado y una definición compartida de los datos aceptados. Utiliza los resultados para decidir si externalizar más, mantener un cliente ligero o combinar ambos enfoques. Si la recuperación gestionada se ajusta a la responsabilidad que deseas delegar, evalúa la API de Scraper de WebScrapingAPI en función de ese mismo contrato antes de ampliar la integración.

Acerca del autor

Anda Miuțescu, Redactor de contenidos técnicos @ WebScrapingAPI

Anda Miuțescu

Redactor de contenidos técnicos

Anda Miuțescu es redactora de contenidos técnicos en WebScrapingAPI, donde elabora contenidos claros y útiles que ayudan a los desarrolladores a comprender el producto y sus capacidades.

Tutorial de Python de Nodriver: Extracción de datos de navegadores de forma sigilosa, desde el primer script hasta la puesta en producción
La ciencia del web scraping

Tutorial de Python de Nodriver: Extracción de datos de navegadores de forma sigilosa, desde el primer script hasta la puesta en producción

TL;DR: En resumen: Nodriver es una biblioteca asíncrona de Python que controla Chromium mediante el Chrome DevTools Protocol, sin Selenium ni el binario chromedriver. Úsala cuando un navegador sigiloso autoalojado, más parecido a una sesión real de Chrome, sea mejor opción que una pila WebDriver, pero ten en cuenta que por sí sola no elimina los riesgos de IP, TLS o comportamiento. Este tutorial va desde un primer script hasta la producción en contenedores y una Browser API alojada.

Suciu Dan15 min read
Leer artículo
Cómo gestionar las URL de redireccionamiento de Google /goto y los tokens CAES en un rastreador de SERP
La ciencia del web scraping

Cómo gestionar las URL de redireccionamiento de Google /goto y los tokens CAES en un rastreador de SERP

TL;DR: En resumen: Las URL /goto de Google con un token CAES, y los envoltorios /url más antiguos, son capas de redirección, no destinos, así que un scraper de SERP que trata cada href como final rompe el seguimiento de posiciones y los almacenes de enlaces. Prefiere una API de SERP estructurada cuando devuelva los enlaces de destino. Si tienes que analizar HTML, clasifica cada href, elimina redirecciones duplicadas y resuélvelas con un GET simple. No descifres CAES.

Suciu Dan13 min read
Leer artículo
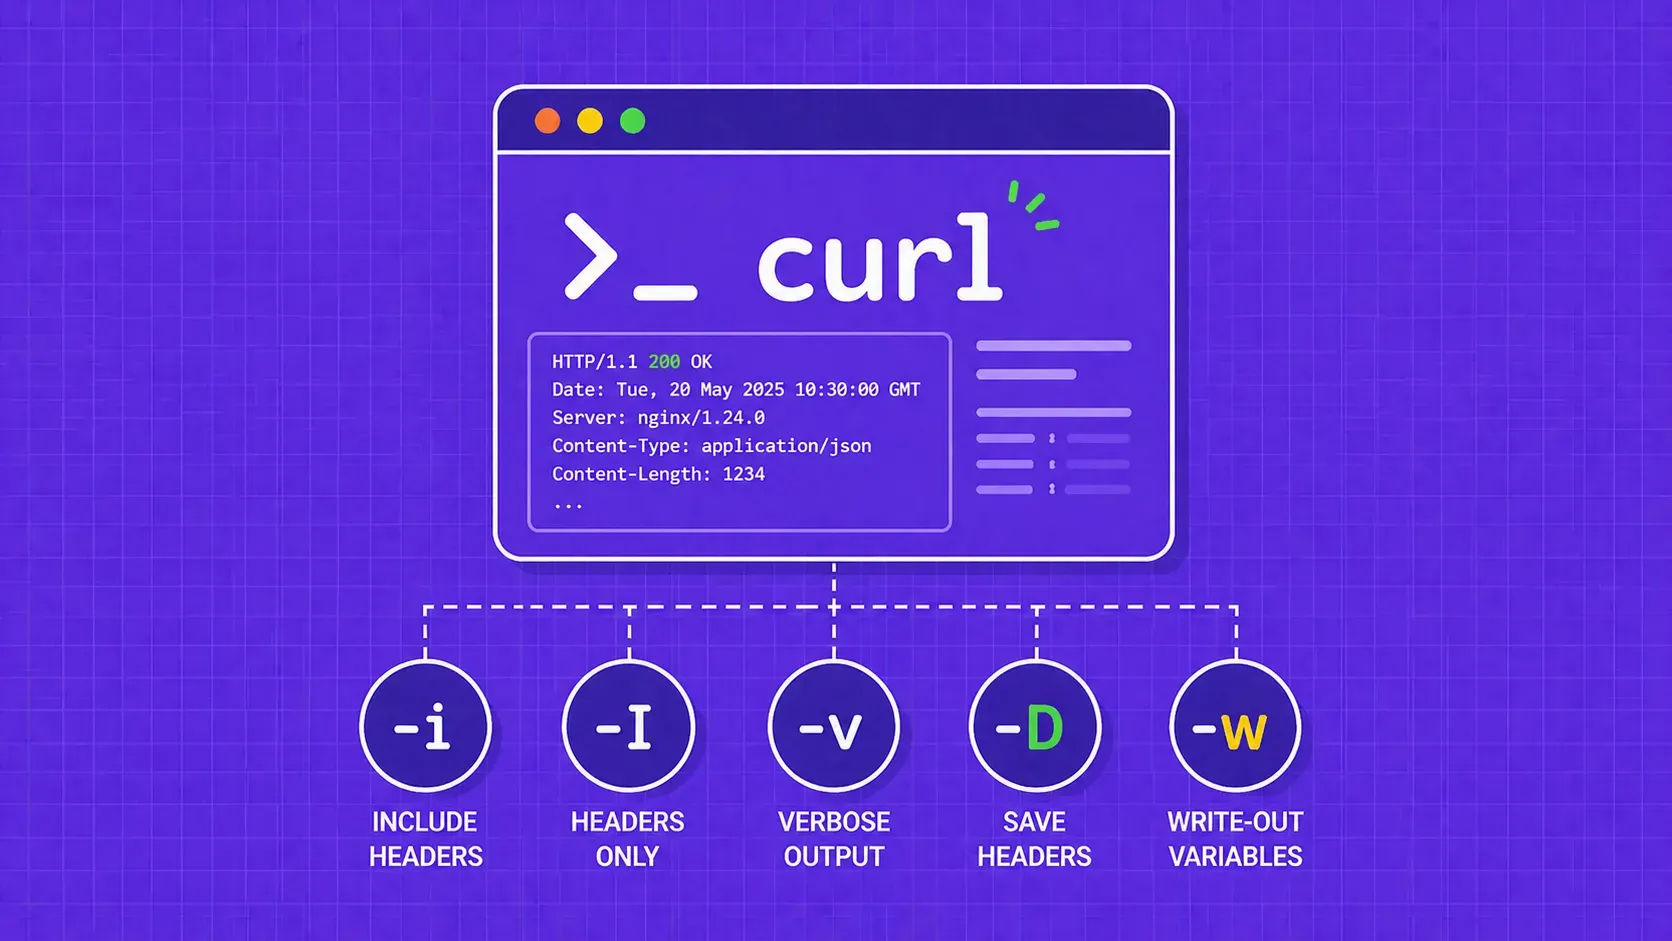
Cabeceras de Respuesta HTTP en cURL: Cada Bandera, Técnica y Receta de Scripting
La ciencia del web scraping

Cabeceras de Respuesta HTTP en cURL: Cada Bandera, Técnica y Receta de Scripting

TL;DR: cURL oculta las cabeceras de respuesta por defecto. Utilice -i para ver las cabeceras junto con el cuerpo, -I para una solicitud HEAD que sólo devuelva cabeceras, -v para una depuración completa de solicitud/respuesta y -D para guardar las cabeceras en un archivo. Para scripts modernos, cURL 7.83+ le permite extraer cabeceras individuales o volcarlas todas como JSON con la opción -w write-out.

Suciu Dan13 min read
Leer artículo

Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.