Saltar al contenido
Empezar gratis
Volver al blog

Web scraping para leads: cómo construir un pipeline B2B

Robert MunceanuÚltima actualización el 15 min read
Web scraping para leads: cómo construir un pipeline B2B
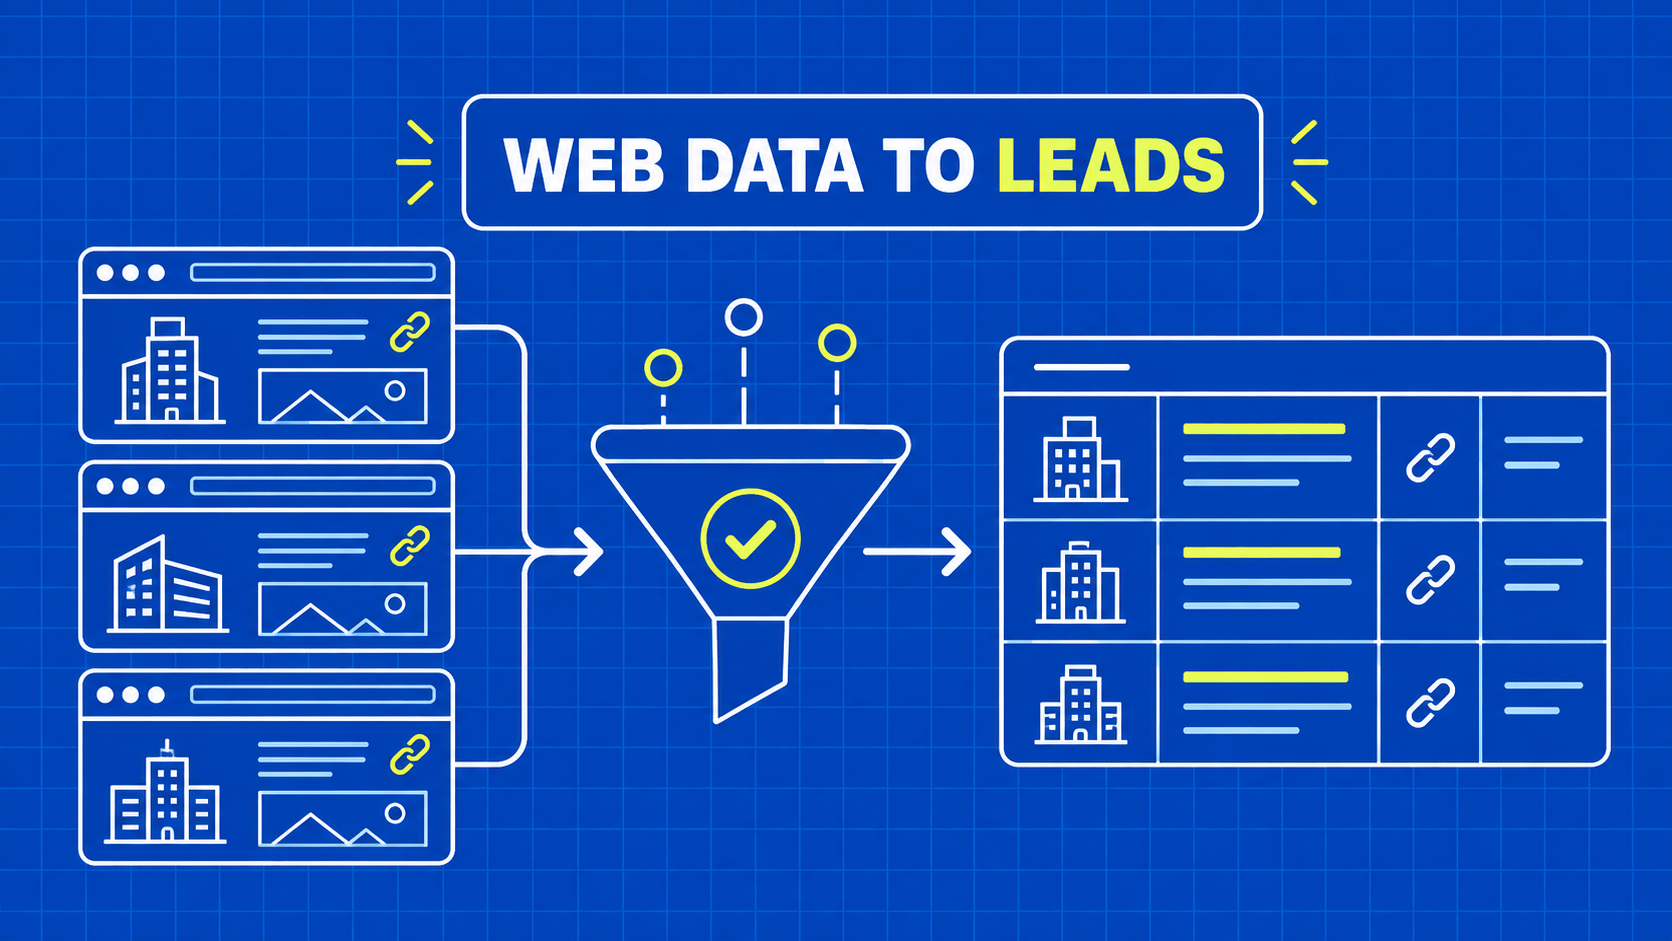
En resumen: el web scraping para generación de leads convierte sitios web de empresas y directorios autorizados en datos de cuentas estructurados. Construye el pipeline en torno a la identidad de la empresa, las pruebas de origen, la frescura de los datos y la correspondencia con el CRM. Trata el permiso para contactar con alguien como una decisión independiente de la recogida de un registro de empresa.

El web scraping para generación de leads es la recogida automatizada de información de sitios web para descubrir y evaluar cuentas empresariales potenciales. Un resultado útil es un registro de empresa con un dominio verificado, atributos de negocio relevantes y pruebas que explican por qué pertenece a tu pipeline de ventas.

La investigación de mercado, el análisis de la competencia y la monitorización de marca figuran, junto a la generación de leads, entre los casos de uso empresariales del web scraping.

Piensa en dos exportaciones. Una contiene miles de nombres de empresas y una columna titulada «cualificado». La otra contiene menos cuentas, pero cada fila incluye el sitio web oficial, el servicio que ofrece, cuándo se observó ese dato y la fuente que respalda la cualificación. Los desarrolladores pueden depurar la segunda exportación. El equipo de Sales Ops puede revisarla. Ningún equipo tiene que fiarse de una puntuación misteriosa.

Esta guía apunta a ese segundo resultado. Definirás la cuenta que necesitas, seleccionarás fuentes, extraerás un esquema deliberadamente pequeño, normalizarás identidades y entregarás registros revisados a un CRM. Los ejemplos se centran en organizaciones y en las actividades de negocio que publican, no en recopilar datos de contacto personales. La misma arquitectura funciona tanto si empiezas con un directorio sectorial autorizado como si partes de una lista de sitios web de empresas que ya mantienes.

Las páginas de empresa de LinkedIn son una de esas fuentes, y nuestra guía para hacer scraping de LinkedIn con Python muestra qué campos de empresa son accesibles sin iniciar sesión.
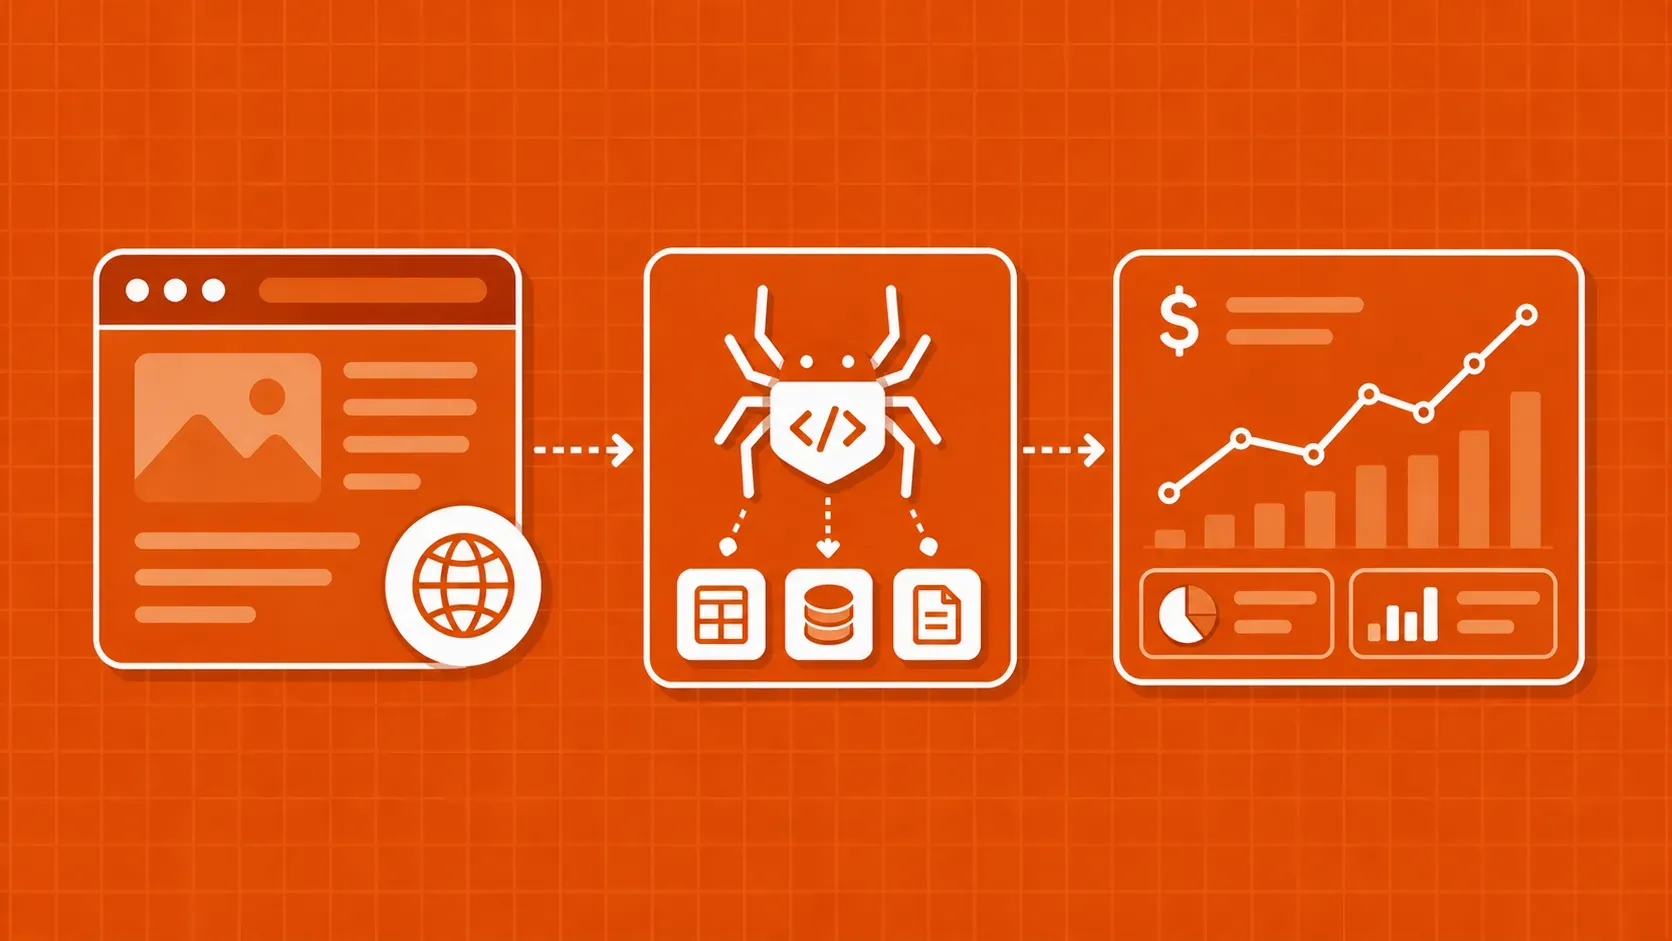
Empieza el web scraping para generación de leads con un contrato de cuenta

Antes de elegir un parser, escribe una frase que defina una cuenta útil. Por ejemplo: «Proveedores independientes de mantenimiento industrial que operan en nuestras regiones de cobertura y ofrecen explícitamente inspecciones de equipos». Es una regla de segmentación ilustrativa, no una afirmación sobre un mercado concreto.

Cada parte debe corresponderse con una prueba observable. Una página de servicios puede respaldar el criterio de inspección. Una página de sedes puede respaldar la cobertura regional. Un eslogan vago en la página de inicio no puede demostrar ninguna de las dos cosas. Si tu negocio necesita una propiedad que las fuentes disponibles no publican, márcala como desconocida en lugar de inventar una estimación.

Separa tres preguntas que a menudo se comprimen en una sola puntuación de lead:

Pregunta

Resultado

Prueba de ejemplo

¿Es la organización correcta?

Identidad de la cuenta resuelta

Dominio oficial enlazado desde un directorio autorizado

¿Encaja con nuestros criterios de cuenta?

Decisión de encaje con motivos

Servicio de inspección publicado y ubicación cubierta

¿Podemos contactarla por este canal?

Estado de prospección revisado de forma independiente

Política aplicable y permisos documentados

Estos resultados no deben anularse entre sí. Un encaje excelente no convierte una cuenta en apta para la prospección. Un canal de contacto aprobado no hace relevante a una empresa que no tiene nada que ver con tu objetivo.

Define las exclusiones junto con las reglas de inclusión: clientes actuales, competidores, ubicaciones no cubiertas, cuentas rechazadas anteriormente y organizaciones incluidas en una lista de supresión. Aplícalas antes del enriquecimiento costoso y de nuevo antes de la exportación. Esa segunda comprobación te protege frente a cambios de estado mientras un crawl está en marcha.

Tu contrato de aceptación también debe indicar los campos obligatorios y los responsables. Decide quién resuelve las coincidencias dudosas, quién aprueba nuevas fuentes y quién puede cambiar las reglas de cualificación. El web scraping para generación de leads resulta más fácil de operar cuando «listo para revisión» tiene un significado escrito en lugar de depender del último script que se ejecutó.

Elige fuentes que ofrezcan los campos que necesitas

Empieza con un pequeño inventario de fuentes. Anota para cada una el método de acceso, la finalidad permitida, los campos esperados, su forma de actualizarse y el responsable. Una API documentada o una exportación con licencia puede ser más fácil de mantener que el HTML cuando cubre el mismo requisito.

Usa fuentes de descubrimiento para localizar candidatos y páginas propias de las organizaciones para verificar los atributos relevantes. Una categoría de directorio es una pista de descubrimiento. La página de servicios de la propia empresa es una prueba más sólida de lo que anuncia actualmente. Ninguna de las dos demuestra una intención de compra.

Fuente

Aportación útil

Limitación importante

Directorio sectorial autorizado

Empresas candidatas y categorías

Las fichas pueden estar desactualizadas o patrocinadas

Sitio web oficial de la empresa

Servicios, sedes, dominio oficial

Las afirmaciones reflejan la posición de la propia empresa

API autorizada de un registro de organizaciones

Identidad jurídica y datos registrales

La identidad jurídica puede diferir de la marca comercial

Lista de cuentas existentes en el CRM

Correspondencia y exclusiones

Los registros existentes también pueden estar desactualizados

Revisa los términos y las condiciones de acceso aplicables al sitio antes de recoger datos. Respeta las reglas de rastreo publicadas y los límites configurados. El Robots Exclusion Protocol describe directivas para crawlers, pero indica explícitamente que no son un mecanismo de autorización de acceso. Un archivo robots permisivo no es una licencia general para recoger o reutilizar datos. RFC 9309

En el web scraping para generación de leads, la calidad de la cobertura importa más que el número de dominios en la cola. Toma muestras de distintas categorías, regiones y plantillas de página antes de comprometerte con una fuente. Un directorio dominado por fichas de pago puede distorsionar tu universo de cuentas aunque cada campo extraído sea técnicamente correcto.

Haz que el descubrimiento y la verificación puedan sustituirse de forma independiente. Si un directorio deja de estar disponible, deberías poder retirarlo sin reconstruir tu modelo de identidad de empresas. Para los límites del crawl y el diseño de colas, consulta nuestra guía de web crawling con Python.

Diseña un esquema de empresa con pruebas adjuntas

Almacena los hechos como observaciones antes de combinarlos en una cuenta. Una observación indica lo que mostraba una fuente concreta en un momento concreto. Una cuenta es tu interpretación actual de esas observaciones.

Esa separación evita un fallo habitual: sobrescribir una categoría de servicio verificada con una etiqueta de directorio menos fiable solo porque el directorio se consultó más tarde. También permite a los revisores reconstruir por qué cambió una decisión de cualificación.

Campo

Propósito

Regla de validación

account_id

Identidad interna estable

Generado internamente y nunca derivado solo del nombre visible

company_name

Etiqueta legible

Cadena no vacía que conserva la grafía original

canonical_domain

Candidato para la correspondencia

Hostname normalizado más un mapeo de alias revisado

service_category

Encaje de la cuenta

Vocabulario controlado con prueba de respaldo

operating_region

Encaje geográfico

Zona de servicio separada de la dirección registrada

source_url

Procedencia de la observación

Página exacta que respalda la observación

observed_at

Momento de la recogida

Marca de tiempo UTC asignada por tu recolector

evidence_text

Respaldo revisable

Extracto breve y relevante, no un volcado de toda la página

parser_version

Reproducibilidad

Versión que identifica las reglas de extracción

review_status

Control del flujo de trabajo

Valor explícito como pending, accepted o rejected

Mantén source_updated_at como campo aparte si la página ofrece realmente una fecha de actualización significativa. Obtener una página hoy no significa que la información subyacente se escribiera hoy. Del mismo modo, el año del copyright no es una marca de tiempo fiable para una afirmación sobre un servicio.

Algunos sitios web publican información de la organización como datos estructurados. El vocabulario Organization de Schema.org define propiedades como nombres, URL, direcciones e identificadores. Trata esos campos como candidatos para la extracción y verifica después que el marcado describe a la organización objetivo y no a un editor, una empresa matriz o un elemento sin relación de la página.

Usa null para la información ausente. No conviertas una categoría de servicio que falta en «no ofrece el servicio», ni una ubicación que falta en «fuera de nuestro mercado». Desconocido y negativo son estados distintos. Preservar esa diferencia hace que el web scraping para generación de leads sea más útil que una hoja de cálculo que convierte en silencio los fallos de extracción en decisiones de negocio.

Construye la extracción como una etapa acotada y observable

Asigna a cada fuente un pequeño adaptador que devuelva observaciones en el mismo esquema. Mantén separadas la obtención, el parsing y la cualificación de negocio. Un cambio en el diseño de una página debería requerir una corrección del parser, no reescribir tu integración con el CRM.

Para páginas renderizadas en el servidor, un cliente HTTP y un parser de HTML suelen ser un punto de partida razonable. Usa un navegador solo cuando el contenido necesario dependa de verdad de la ejecución de la página o de la interacción. La comparativa entre Scrapy y Beautiful Soup ayuda a distinguir un framework de crawling de una biblioteca de parsing, y la guía de clientes HTTP de Python cubre la capa de peticiones.

Pon límites a cada tarea de recogida: hosts aprobados, número máximo de páginas, tiempo de espera de las peticiones, tamaño de la respuesta, concurrencia por host y reintentos acotados. Un crawler que sigue todos los enlaces que descubre acabará en páginas irrelevantes y multiplicará tanto los costes como el trabajo de revisión.

Trata los errores como resultados clasificados. Una limitación de tasa debe ralentizar o pausar la recogida. Una respuesta «forbidden» debe desencadenar una revisión de la fuente, no un intento interminable de sortear la restricción. Una respuesta correcta sin los campos esperados debe pasar a una cola de investigación del parser en lugar de convertirse en un registro de empresa vacío.

La extensión AutoThrottle de Scrapy ajusta los retrasos de descarga según la latencia de las respuestas, respetando la configuración de concurrencia y de retraso. Es un componente de planificación útil, pero sigues necesitando decisiones de acceso específicas para cada fuente y límites operativos.

Mide por separado las páginas obtenidas, los parsings correctos, la cobertura de los campos obligatorios y la aceptación tras revisión. Una tasa de éxito HTTP puede parecer sana mientras una plantilla rediseñada elimina en silencio todos los campos útiles. Para un recolector de datos de leads, «la tarea ha terminado» dice menos que «las pruebas esperadas de la cuenta han superado la validación».

Normaliza y elimina duplicados sin fusionar empresas distintas

Normaliza los espacios en blanco y las variaciones evidentes de URL antes de cruzar registros. Conserva los valores originales para que un revisor pueda ver qué ha cambiado. No elimines palabras de los nombres de empresa con tanta agresividad que empresas distintas acaben siendo indistinguibles.

El siguiente ejemplo en Python trabaja solo con observaciones sintéticas. Normaliza hostnames y agrupa registros para su revisión. No descarga sitios web, no resuelve entidades jurídicas ni aprueba fusiones en el CRM.

from collections import defaultdict
from urllib.parse import urlsplit


def domain_key(value):
    value = value.strip()
    candidate = value if "://" in value else "https://" + value
    parts = urlsplit(candidate)
    if parts.scheme not in {"http", "https"} or not parts.hostname:
        raise ValueError("Expected a company HTTP(S) website")
    if parts.username or parts.password or any(c.isspace() for c in value):
        raise ValueError("Credentials and whitespace are not accepted")
    _ = parts.port  # Reject malformed or out-of-range ports.
    host = parts.hostname.rstrip(".").encode("idna").decode("ascii").lower()
    return host.removeprefix("www.")


observations = [
    {"name": "Example Tools", "website": "https://www.example.com/about",
     "source_url": "https://directory.example/companies/one"},
    {"name": "Example Tools Ltd", "website": "example.com/",
     "source_url": "https://example.com/services"},
    {"name": "Example Regional", "website": "regional.example.com",
     "source_url": "https://regional.example.com/about"},
]

groups = defaultdict(list)
for observation in observations:
    groups[domain_key(observation["website"])].append(dict(observation))

assert len(groups["example.com"]) == 2
assert len(groups["regional.example.com"]) == 1
assert domain_key("https://EXAMPLE.com:443/") == "example.com"
print({key: len(rows) for key, rows in sorted(groups.items())})

La salida contiene dos grupos candidatos: example.com, con dos observaciones, y regional.example.com, con una. Conservar el subdominio es intencionado. Nunca des por hecho que quedarse solo con las dos últimas etiquetas del hostname identifica a una empresa: los sufijos públicos y el alojamiento compartido hacen que ese atajo no sea fiable.

La documentación de Python sobre el análisis de URL advierte de que las funciones de análisis no validan las URL. Las comprobaciones de este ejemplo solo sirven para demostrar una correspondencia limitada. No son controles de seguridad de red. Un fetcher en producción debe validar por separado los destinos y las redirecciones antes de hacer peticiones.

Una coincidencia de dominio es una prueba útil, no una identidad perfecta. Distintas filiales pueden compartir un dominio, y una misma organización puede tener varias marcas y dominios por país. Envía los casos ambiguos a una cola de revisión con los ID de las cuentas candidatas y los motivos de la coincidencia. Solo una coincidencia aceptada debería actualizar tu tabla de alias.

Esa distinción es clave para que el web scraping para generación de leads sea fiable: la deduplicación debe reducir las cuentas duplicadas sin borrar las pruebas que revelaron un conflicto.

Cualifica cuentas y entrégalas al CRM de forma segura

Empieza con reglas de cualificación explicables. Una cuenta puede cumplir un criterio de servicio, no superar un requisito geográfico o quedar sin resolver por falta de pruebas. Guarda esos resultados individuales antes de calcular cualquier prioridad global.

En un piloto inicial, usa categorías como «lista para revisión de la cuenta», «faltan pruebas» y «excluida». Estas etiquetas son más fáciles de auditar que una puntuación que mezcla incógnitas y señales negativas en un número opaco. Si más adelante añades ponderaciones, versiona el conjunto de reglas y conserva los motivos que contribuyeron a cada resultado.

Establece una frontera clara con el CRM. Los registros aprobados pueden convertirse en entradas de investigación de cuentas. No deberían activar la prospección automáticamente solo porque la importación haya funcionado. Mantén la decisión sobre si se puede contactar fuera de tu tarea de scraping.

La documentación de la API de companies de HubSpot recomienda incluir el dominio de la empresa para ayudar a evitar duplicados y documenta la actualización de registros de empresa por ID. Uses el CRM que uses, guarda el identificador que devuelve y define un comportamiento de correspondencia explícito antes de enviar un segundo lote.

Mantén un registro de exportaciones con tu ID de cuenta, el ID del registro de destino, la versión del payload y el último resultado confirmado. En un reintento, concilia el intento anterior antes de crear otro registro. No des por hecho que un campo de dominio hace automáticamente idempotente cada escritura en la API.

Limita las actualizaciones a los campos de los que es responsable el recolector. Un propietario de cuenta verificado, un estado de relación negociado o una razón social corregida a mano no deberían desaparecer porque un crawler haya generado una nueva suposición. Usa una política de precedencia de campos revisable y mantén las exportaciones correctas separadas de los reintentos pendientes.

Mide el web scraping para generación de leads en esta frontera: cuentas únicas aceptadas, coincidencias rechazadas, pruebas que faltan y coste por cuenta aceptada. Las filas brutas por minuto premian los duplicados. Un pipeline útil premia los registros en los que tu equipo puede confiar de verdad.

Separa las decisiones de recogida, privacidad y prospección

Recoge solo los atributos de negocio necesarios para la finalidad declarada de investigación de cuentas. La segmentación a nivel de empresa no suele requerir números de móvil personales, historiales de comportamiento individuales ni características personales sensibles. Evita añadir esos campos solo porque una página los muestre.

El contexto empresarial no elimina automáticamente las obligaciones de privacidad. La Information Commissioner's Office (ICO) del Reino Unido explica que el UK GDPR puede aplicarse a los datos personales utilizados en el marketing B2B, incluida la información disponible públicamente. Sus directrices también distinguen, en las normas de marketing electrónico, entre los abonados corporativos y los empresarios individuales y ciertas sociedades personalistas. La página está en revisión tras cambios legislativos, así que comprueba su redacción actual cuando apruebes un flujo de trabajo en el Reino Unido. Directrices de la ICO sobre marketing B2B

En Estados Unidos, la FTC indica que la ley CAN-SPAM cubre el correo electrónico comercial y no exime los mensajes B2B. Sus directrices abordan la identificación del remitente, las líneas de asunto, la dirección postal y la gestión de las bajas. Esos requisitos se refieren al envío de mensajes. No conceden permiso para hacer scraping de un sitio web ni acreditan el cumplimiento en otra jurisdicción. Guía de cumplimiento de la FTC

Traduce la política aplicable a campos operativos: finalidad aprobada, regla de conservación, restricciones de acceso, estado de supresión y responsable de la revisión. Deja que el equipo de privacidad o el equipo jurídico competente determine qué es apropiado para las jurisdicciones y los canales realmente implicados.

Haz que la supresión se mantenga entre ejecuciones. Si una cuenta o un contacto debe quedar excluido, volver a descubrirlo en otro sitio web no debe reactivarlo en silencio. Aplica la misma regla a las exportaciones posteriores y a las copias de seguridad restauradas. El web scraping para generación de leads es un proceso de recogida, no un sustituto de la decisión sobre cómo pueden usarse los datos resultantes.

Conclusiones clave

  • Define los criterios de cuenta y las pruebas necesarias antes de construir el crawler.
  • Mantén las observaciones de origen separadas de las cuentas normalizadas y de las decisiones de cualificación.
  • Trata las coincidencias de dominio como candidatas, con revisión para dominios compartidos y marcas múltiples.
  • Concilia los reintentos en el CRM y protege los campos mantenidos a mano frente a sobrescrituras automáticas.
  • Gestiona el permiso de recogida, el encaje de la cuenta y la aptitud para la prospección como decisiones independientes.

FAQ

¿Un registro de empresa obtenido por scraping debe convertirse automáticamente en una oportunidad de venta?

No. Crea primero un registro de investigación de cuenta y deja que tu proceso de ventas decida si existe una oportunidad. Un sitio web puede mostrar servicios o ubicaciones relevantes sin reflejar un proyecto de compra activo. Mantener las cuentas de investigación separadas de las oportunidades también hace que los informes del pipeline sean más significativos y evita que tu CRM trate cada empresa descubierta como un ingreso potencial.

¿Puede un modelo de lenguaje clasificar las descripciones de servicios de las empresas?

Sí, como un paso de clasificación revisado, con una taxonomía fija y pruebas de origen. Exige que la salida identifique el texto que la respalda y permite el resultado «desconocido». Trata el contenido de las páginas web como datos no fiables, no como instrucciones para el modelo. Evalúa el clasificador con ejemplos etiquetados por personas antes de usar su salida para priorizar cuentas, y mantén las inferencias generadas por el modelo separadas de los hechos observados.

¿Cómo deberían afectar los anuncios de adquisición a los registros de cuentas existentes?

Envíalos a un flujo de revisión de entidades en lugar de fusionar registros automáticamente. Una adquisición puede cambiar la propiedad sin cambiar de inmediato las marcas, los sitios web, las entidades operativas o las relaciones en el CRM. Registra el anuncio como una observación fechada y deja que un responsable decida qué relaciones de cuentas y qué alias deben actualizarse. Conserva los identificadores históricos para que las exportaciones y decisiones anteriores sigan siendo trazables.

Conclusión

El resultado más valioso del web scraping para generación de leads es un registro de cuenta defendible. Tiene una identidad resuelta, atributos de negocio útiles, un rastro de fuentes claro y una decisión de cualificación que otra persona puede revisar. El número de páginas obtenidas es solo una métrica de apoyo.

Empieza con una sola fuente aprobada, una definición de cuenta acotada y un lote pequeño que los revisores puedan examinar por completo. Corrige las coincidencias erróneas y las pruebas que faltan antes de aumentar el volumen de crawling. Después, añade la programación de actualizaciones, los alias revisados y la conciliación con el CRM sin cambiar el significado de tus campos principales.

Ten a mano, junto al recolector, una breve checklist operativa: fuente aprobada, observación válida, cuenta emparejada, exclusiones comprobadas, exportación confirmada. Cuando algo falle, detenlo en la etapa correspondiente en lugar de dejar que la incertidumbre llegue al CRM.

Si mantener la capa de obtención te está quitando tiempo para la calidad de las cuentas, evalúa la Scraper API de WebScrapingAPI para obtener páginas dentro del alcance de recogida que hayas aprobado. Tu esquema, tus comprobaciones de pruebas y tus reglas de cualificación deben seguir bajo tu control, independientemente de cómo llegue el HTML al parser.

Acerca del autor

Robert Munceanu, Desarrollador full-stack @ WebScrapingAPI

Robert Munceanu

Desarrollador full-stack

Robert Munceanu es desarrollador full stack en WebScrapingAPI, donde colabora en todas las áreas del producto y ayuda a crear herramientas y funciones fiables que respaldan la plataforma.

Raspado alternativo de datos para las finanzas: Cómo los datos web dan ventaja a los inversores
Casos de uso

Raspado alternativo de datos para las finanzas: Cómo los datos web dan ventaja a los inversores

TL;DR: El scraping de datos alternativos utiliza técnicas de recopilación web para reunir conjuntos de datos no tradicionales (precios de productos, opiniones, ofertas de empleo, registros normativos) que revelan señales del mercado antes de que aparezcan en los informes de resultados. Esta guía le guiará a través de las fuentes de datos de mayor valor, cómo crear canales de calidad financiera, la validación de la calidad de los datos y las salvaguardas de cumplimiento que necesita para mantenerse en el lado correcto de la ley.

Mihnea-Octavian Manolache20 min read
Leer artículo
¿Qué son los datos financieros? Tipos, métodos de recopilación y herramientas de análisis
Casos de uso

¿Qué son los datos financieros? Tipos, métodos de recopilación y herramientas de análisis

TL;DR: Los datos financieros son la recopilación de registros cuantitativos (ingresos, gastos, activos, pasivos, flujo de caja) que las organizaciones y los particulares utilizan para tomar decisiones económicas fundamentadas. Esta guía desglosa los cuatro estados financieros básicos, compara las fuentes de datos tradicionales y alternativas, recorre los métodos de recopilación modernos y cubre las herramientas en las que se basan los profesionales para el análisis.

Suciu Dan16 min read
Leer artículo
XPath vs Selectores CSS: Elegir el correcto
Casos de uso

XPath vs Selectores CSS: Elegir el correcto

TL;DR: Tanto XPath como los selectores CSS localizan elementos DOM, pero resuelven problemas diferentes. Los selectores CSS son más rápidos y más legibles para selecciones sencillas. XPath gana cuando se necesita recorrer el DOM en cualquier dirección, hacer coincidir contenido de texto o manejar lógica condicional compleja. La mayoría de los proyectos de producción se benefician del uso estratégico de ambos.

Mihai Maxim15 min read
Leer artículo

Empieza a crear

¿Estás listo para ampliar tu recopilación de datos?

Únete a más de 2000 empresas que utilizan WebScrapingAPI para extraer datos de la web a escala empresarial sin ningún gasto de infraestructura.